
Claude Fable 5.1:変更点、移行リスク、アップグレード判断
Claude Fable 5.1は、Anthropicが高難度の推論と長時間のエージェント処理向けに提供する最新のFableモデルです。Fable 5と同じ入出力の標準API価格を維持しながら、キャッシュ読み取り価格を4分の1に下げ、長い処理を制御するための機能を追加しました。
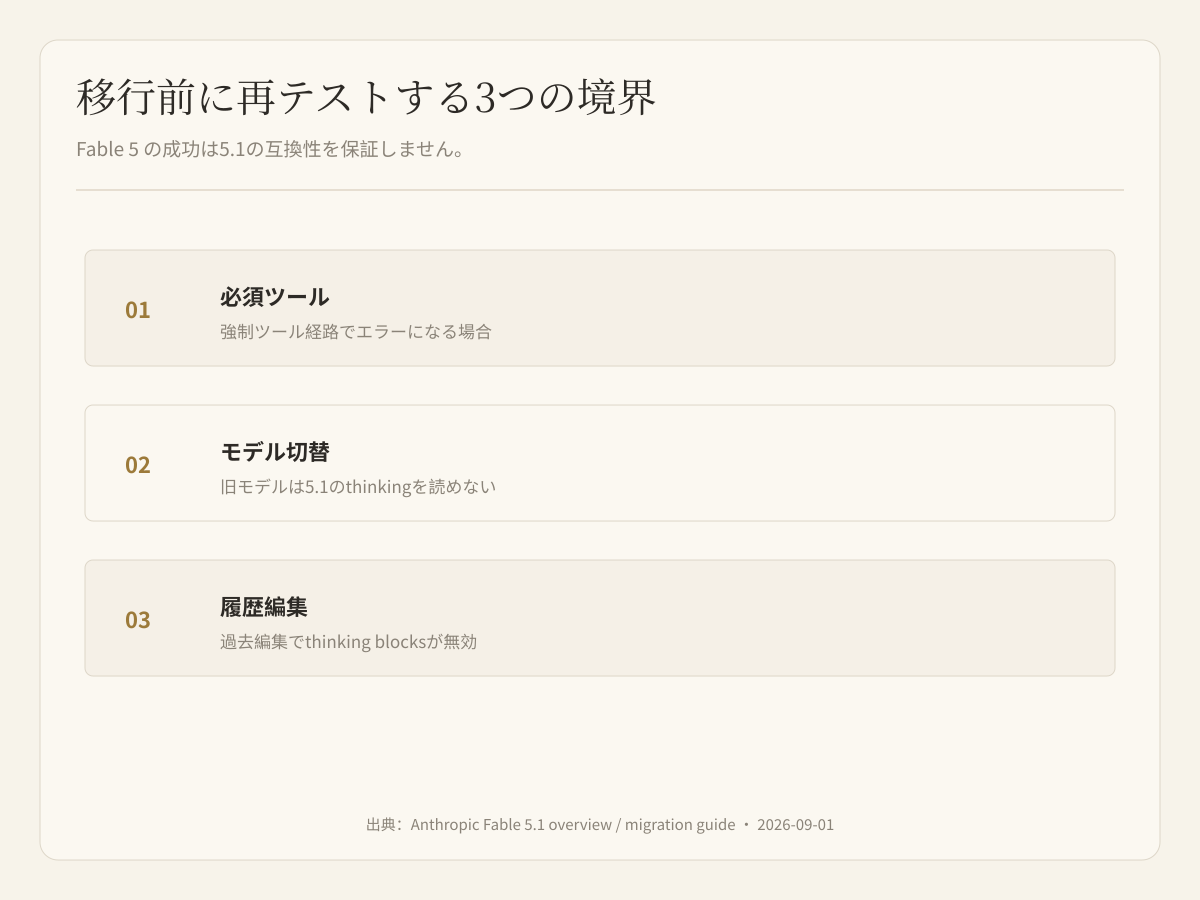
ただし、モデルIDを置き換えるだけの移行は安全ではありません。公式ドキュメントは、ツールの強制、thinking blocksのモデル間互換性、過去メッセージの編集に関する3つの変更を明記しています。
先に結論を示します。多くの用途ではClaude Opus 5から始め、Opus 5を高いeffortで使っても自社の評価基準を満たせない場合にFable 5.1を検討するのが妥当です。
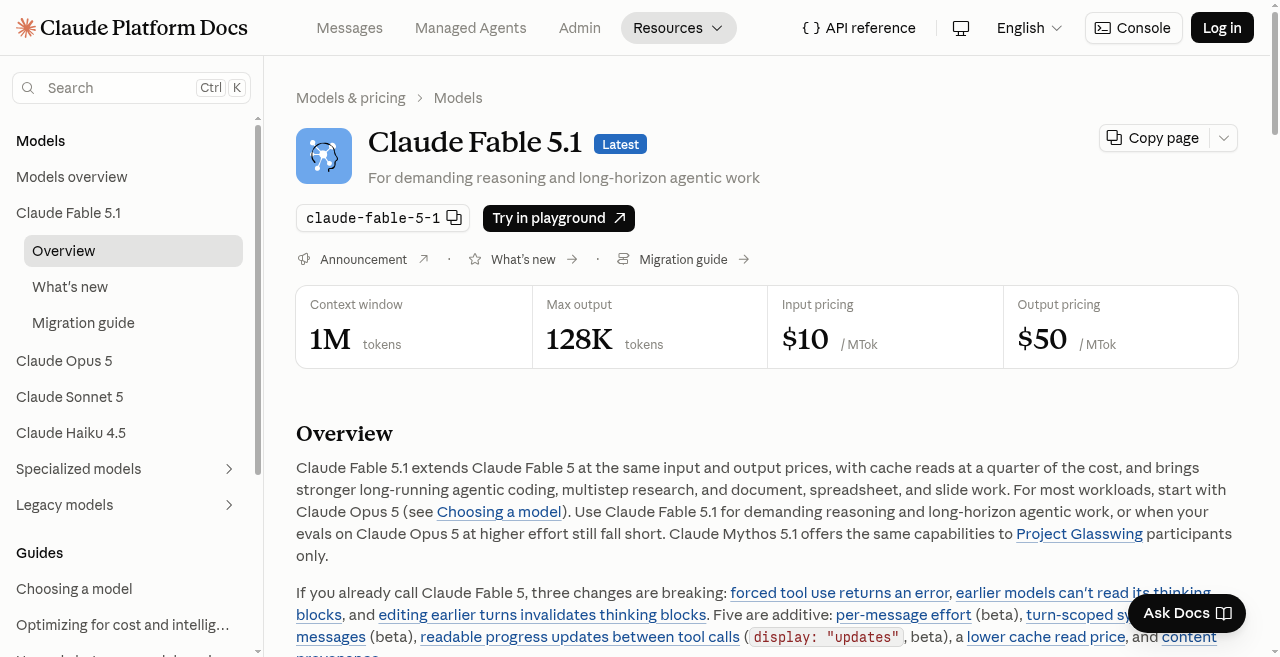
出典:Anthropic Claude Platform ドキュメント。2026年9月2日取得。
Claude Fable 5.1とは
Anthropicは2026年9月1日にClaude Fable 5.1を公開しました。主な仕様は次のとおりです。
- 100万トークンのコンテキスト
- 最大12.8万トークンの出力
- 常時有効なadaptive thinking
- 2026年6月の知識カットオフ
- 長時間のエージェントコーディング、複数段階の調査、文書・表計算・スライド作業を想定
公式は「ほとんどのワークロードではOpus 5から始める」と案内しています。Fable 5.1は、難しい判断だけを受け持つ上位ルートとして扱う方が合理的です。
Fable 5.1とFable 5の違い
| 項目 | Fable 5 | Fable 5.1 | 実務上の意味 |
|---|---|---|---|
| 状態 | Active、legacy | Active、latest | 新しい評価は5.1を対象にする |
| コンテキスト | 1M | 1M | 上限は同じ |
| 最大出力 | 128K | 128K | 上限は同じ |
| 上流の入出力標準価格 | $10 / $50 per MTok | $10 / $50 per MTok | 基本価格は同じ |
| Cache read | $1 per MTok | $0.25 per MTok | 再利用する長い文脈が安くなる |
| 長時間処理の制御 | 従来仕様 | per-message effort、turn-scoped system messages、進捗表示 | 長い実行を調整しやすい |
これはAnthropicの上流API標準価格であり、Budaの価格ではありません。BudaではCredits、倍率、最低課金、ツール呼び出し、キャッシュなど別の条件が適用される場合があります。また、本稿はFable 5.1がBudaで利用可能だとは述べません。
移行前に確認すべき3つの変更
1. ツールの強制でエラーになる場合がある
特定ツールの使用を強制するリクエストは、以前のモデルと同じように動かない可能性があります。required toolを使うすべての経路を再テストしてください。
2. 古いモデルはFable 5.1のthinking blocksを読めない
Fable 5.1から古いモデルへフォールバックする構成では、思考状態を引き継げない場合があります。混合モデルのセッションを実タスクで検証する必要があります。
3. 過去のターンを編集するとthinking blocksが無効になる
履歴の圧縮、過去メッセージの修正、途中からの分岐を行うエージェント基盤は注意が必要です。compaction、再試行、分岐、人による修正を個別にテストしてください。
どの仕事ならアップグレードする価値があるか
次の条件が重なる場合にFable 5.1を評価します。
- 複数段階にわたる長時間タスク
- 失敗ややり直しのコストが高い
- Opus 5を適切なeffortで使っても基準未達
- 安定した長い文脈を繰り返し読む
- 最終成果や重大な操作を人がレビューする
定型的で低リスク、低遅延が重要、結果を容易に検証できる仕事では、安価なモデルを選ぶ方が適切です。
Cache readが4分の1でも、総コストが75%下がるわけではない
総コストには、未キャッシュ入力、出力、推論、ツール、subagent、失敗、再試行、人のレビュー、修正が含まれます。比較すべきなのはトークン単価ではなく、合格した成果1件あたりの総コストです。
合格したタスクの総コスト = モデル + ツール + 失敗 + 再試行 + レビュー + 修正
安全な移行チェックリスト
- 検証環境で
claude-fable-5-1を固定する。 - 実務から評価セットを作る。
- 強制ツール呼び出しをすべて検証する。
- モデルフォールバックとthinking blocksを検証する。
- 履歴圧縮、編集、再試行、分岐を検証する。
- 合格率、総コスト、遅延、修正回数を比較する。
- 限定したワークフローから段階導入する。
- 互換性のない思考状態に依存しないロールバックを用意する。
エージェントを運用するチームへの意味
モデルが強くなるほど、一度の自律実行で進む範囲は広がります。だからこそ、権限、実行の可視性、評価、人のレビューが重要になります。
Budaは、エージェントが永続ファイルと実際のツールで作業し、人がSessionと成果物を確認できる運用層を提供します。モデル選定だけでなく、作業が境界内にあり、追跡でき、引き継げることが重要です。
モデル選定の考え方はHow to Choose the Right Model for Your AI Agentsを参照してください。旧版の背景はClaude Fable 5 が Buda で利用可能になりましたにあります。Fable 5.1のBudaでの提供状況とCreditsは、現在の製品ページを確認してください。
FAQ
Fable 5.1はFable 5より安いですか
上流の入出力標準価格は同じです。Cache readは$1から$0.25 per MTokに下がりました。総コストはキャッシュ、出力、ツール、再試行、修正に左右されます。
すべてのFable 5処理をすぐ移行すべきですか
いいえ。評価と互換性テストを先に行ってください。
Fable 5.1は常にOpus 5より優れていますか
いいえ。Anthropicは多くの用途でOpus 5から始めることを推奨しています。
Fable 5.1はBudaで利用できますか
モデルの提供状況とCreditsは更新されるため、Budaの現在のモデル一覧を確認してください。本稿のAnthropic標準価格は上流の参考価格であり、Buda Creditsではありません。