
Anthropicは2026年10月7日にClaude Haiku 5.5を発表しました。Haiku 4.5からコンピューター操作や推論の評価結果が大きく改善し、Haikuシリーズで初めてeffortの調整に対応。promptが100,000 tokens以下のリクエストでは、token単価が90%下がります。
主な用途は、要約、分類、データベースへの問い合わせ、コンテキスト圧縮、そして大きな仕事の中の限定的なsubagent作業です。モデルを頻繁に呼ぶアプリケーションでは、従来の小型モデルで難しかった処理や、費用のために控えていた処理を再検討できます。
どの能力が伸びたのか
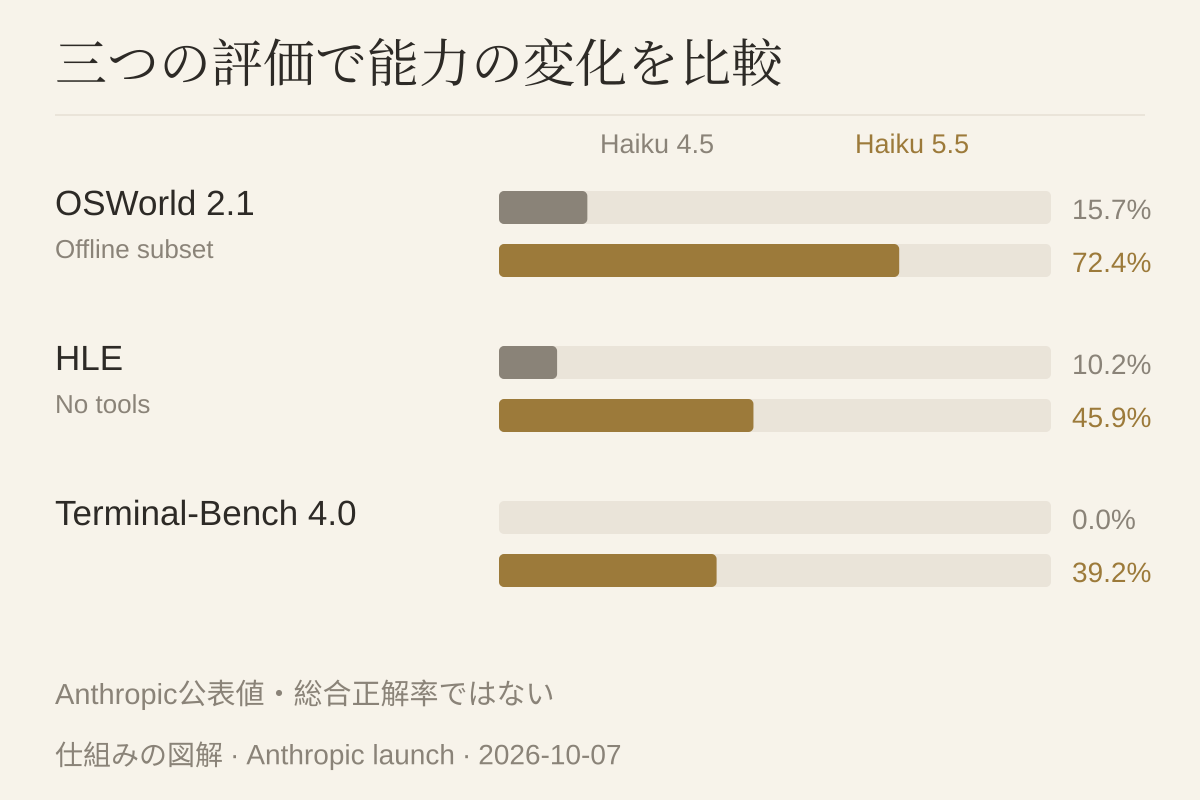
発表ページには、知識業務、コンピューター操作、推論、プログラミング、グラフ理解の評価が掲載されています。4.5からの変化を示す三つの結果は次のとおりです。
| 評価 | Haiku 4.5 | Haiku 5.5 | 評価する作業 |
|---|---|---|---|
| OSWorld 2.1、offline subset | 15.7% | 72.4% | コンピューター上の複数ステップ作業 |
| Humanity’s Last Exam、toolsなし | 10.2% | 45.9% | 専門知識と推論 |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 複雑なコマンドライン作業 |
いずれもAnthropicが公表した評価で、設定と方法はsystem cardに記載されています。異なる能力を測る指標なので、一つの総合正解率としては扱いません。
コンピューター操作の改善と並行して、PythonとTypeScript SDKにはcomputer useとbrowser useのbeta対応が加わります。ウェブページやデスクトップで操作を行うアプリにとって、モデルと開発手段の両方が進んだ更新です。接続、操作権限、結果の確認は、引き続きアプリ側で設計する必要があります。
Haikuでも思考の投入量を調整できる
Haiku 5.5は、effortを調整できる初めてのHaikuモデルです。発表ではlow、medium、high、xhigh、maxの各設定について、性能と費用の関係が示されています。
簡単な分類と難しい分析に、同じ思考投入量を使う必要はありません。大きなモデルに切り替える前にeffortを増やす選択肢も生まれます。適切な設定は、実際の作業の品質、遅延、費用を比較して決めるものです。
速度についてAnthropicは、標準速度で動作するClaudeの中で最速と説明しています。OpusのFast Modeはこの比較に含まれません。Asanaの初期評価では、作業完了までの遅延が30%以上減少し、Agentの一回のターンでは推論速度が最大2.5倍になったと報告されています。これは同社の評価環境の結果です。
繰り返す一工程に使う
発表ページの顧客事例は、どの仕事を分担させるかを具体的に示しています。
- **AlphaSense:文書への短い質問。**Ask in Documentは本番環境で週約800万回呼び出されます。400件の質問で、新モデルの評価値は0.84、4.5は0.76でした。数値は顧客独自の評価に基づきます。
- **HubSpot:範囲の決まったCRM作業。**顧客ポータルを模した評価で、三回の平均は92.8%。古くなった曖昧なレコードを見つける監査作業も含まれます。
- **Rogo:subagentによる検索。**大きなモデルがプレゼン資料を作り、Haikuが10-Kから必要な部門売上を探して渡します。
これらはAnthropicが収録した顧客の初期評価です。共通するのは、分類、抽出、短い要約、検索など、繰り返し実行され、結果を確認できる工程を切り出している点です。
複雑なagentic codingでは差が残ります。Terminal-Bench 4.0でSonnet 5.5は70.6%、Haiku 5.5は39.2%。Anthropicも複雑なプログラミングにはSonnetとOpusを推奨し、Haikuをより限定された作業に位置づけています。
料金は二段階:短いpromptは90%、長いpromptは50%低下
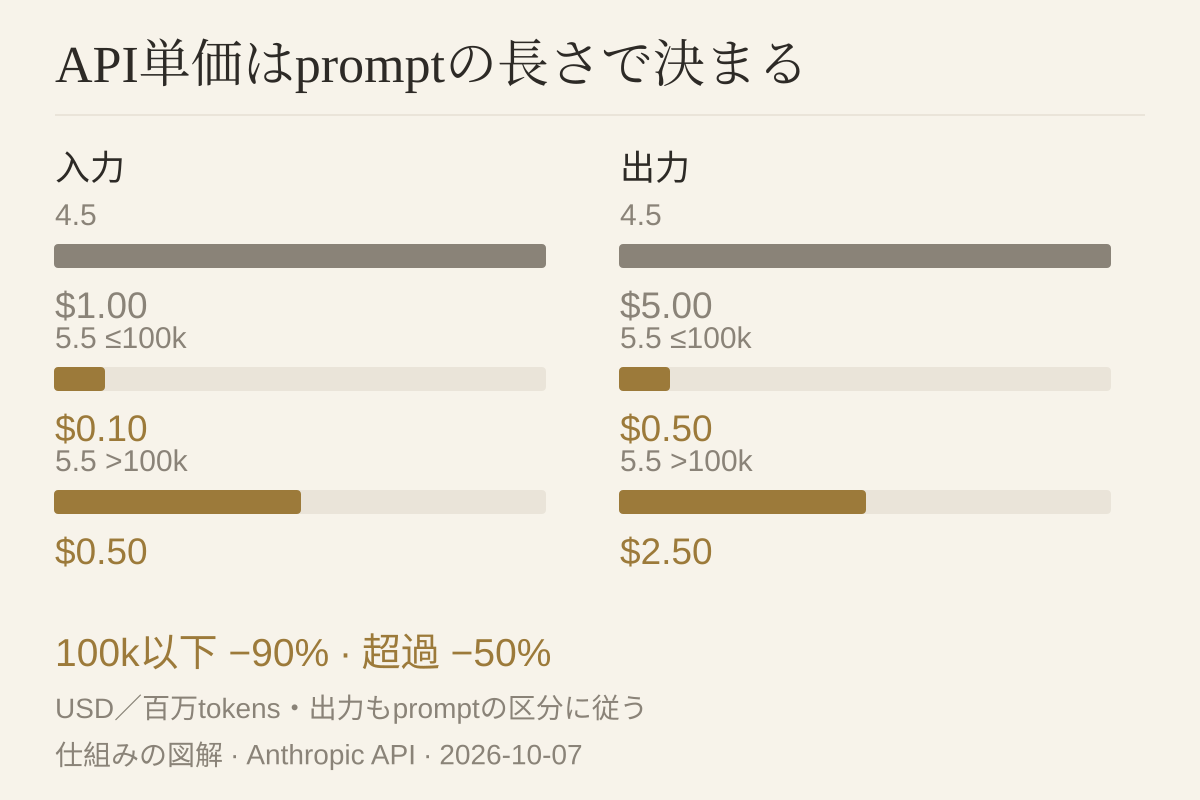
Anthropic APIの百万tokensあたりの公開単価です。
| 項目 | Haiku 4.5 | 5.5 prompt ≤100k | 5.5 prompt >100k |
|---|---|---|---|
| 入力 | $1.00 | $0.10 | $0.50 |
| 出力 | $5.00 | $0.50 | $2.50 |
| cache read | $0.10 | $0.01 | $0.05 |
| cache write | $1.25 | $0.125 | $0.625 |
100k以下では四項目とも90%低下、それを超える場合は50%低下です。出力の単価も、そのリクエストのpromptの長さに応じます。
Anthropicによると、従来のHaikuへのリクエストの約90%は100k以内でした。この「リクエストの90%」と「単価の90%減」は別の数字ですが、短いprompt向けの料金が重要な理由になります。
作業費用の平均はなぜ約75%減なのか
token単価が安くなっても、同じ仕事の費用がそのまま90%減るわけではありません。公式移行ガイドによると、新tokenizerでは同じ入力文が平均約30%多いtokensとして数えられ、増加幅は内容で変わります。effort、出力の長さ、再試行も使用量を変えます。
Anthropicの「平均約75%の費用減」は、作業に必要なtokensの変化を考慮した見積もりです。同じ作業セットで品質と総費用を比較し、5.5で再計数する必要があります。100kの境界付近にある入力は特に確認が必要です。
費用のために抑えていた要約や文書質問、subagentの呼び出しを増やせるかもしれません。ただし、判断の根拠になるのは価格表だけでなく、実際の完了品質と請求額です。
提供先とアップグレード時の注意
AnthropicはClaude Platform、AWS、Google Cloud、Microsoft Azureでの提供を発表しています。Claude APIの固定IDはclaude-haiku-5-5です。
既存の接続には互換性確認が必要です。Managed Agentsはモデル名の更新だけでよいとされていますが、Messages APIはthinking、応答解析、sampling、assistant prefill、toolsなどに変更があります。詳細は公式移行ガイドを参照してください。
今回の中心は、頻度が高く範囲の決まった仕事に、より高性能で安価な小型モデルが加わったことです。繰り返す一工程を見つけ、品質、遅延、費用を比較すると、更新が役立つ場所を判断できます。
確認日:2026年10月9日。評価、料金、顧客の初期評価はAnthropicの発表に基づきます。tokenizerと互換性は公式移行ガイドを参照。独立したモデル試験は行っていません。