Sonnet 5.5 はなぜ Max より Xhigh で高得点なのか:effort の選び方
推論の深さだけでなく、作業範囲、停止条件、手直しを含めて設定を評価します。

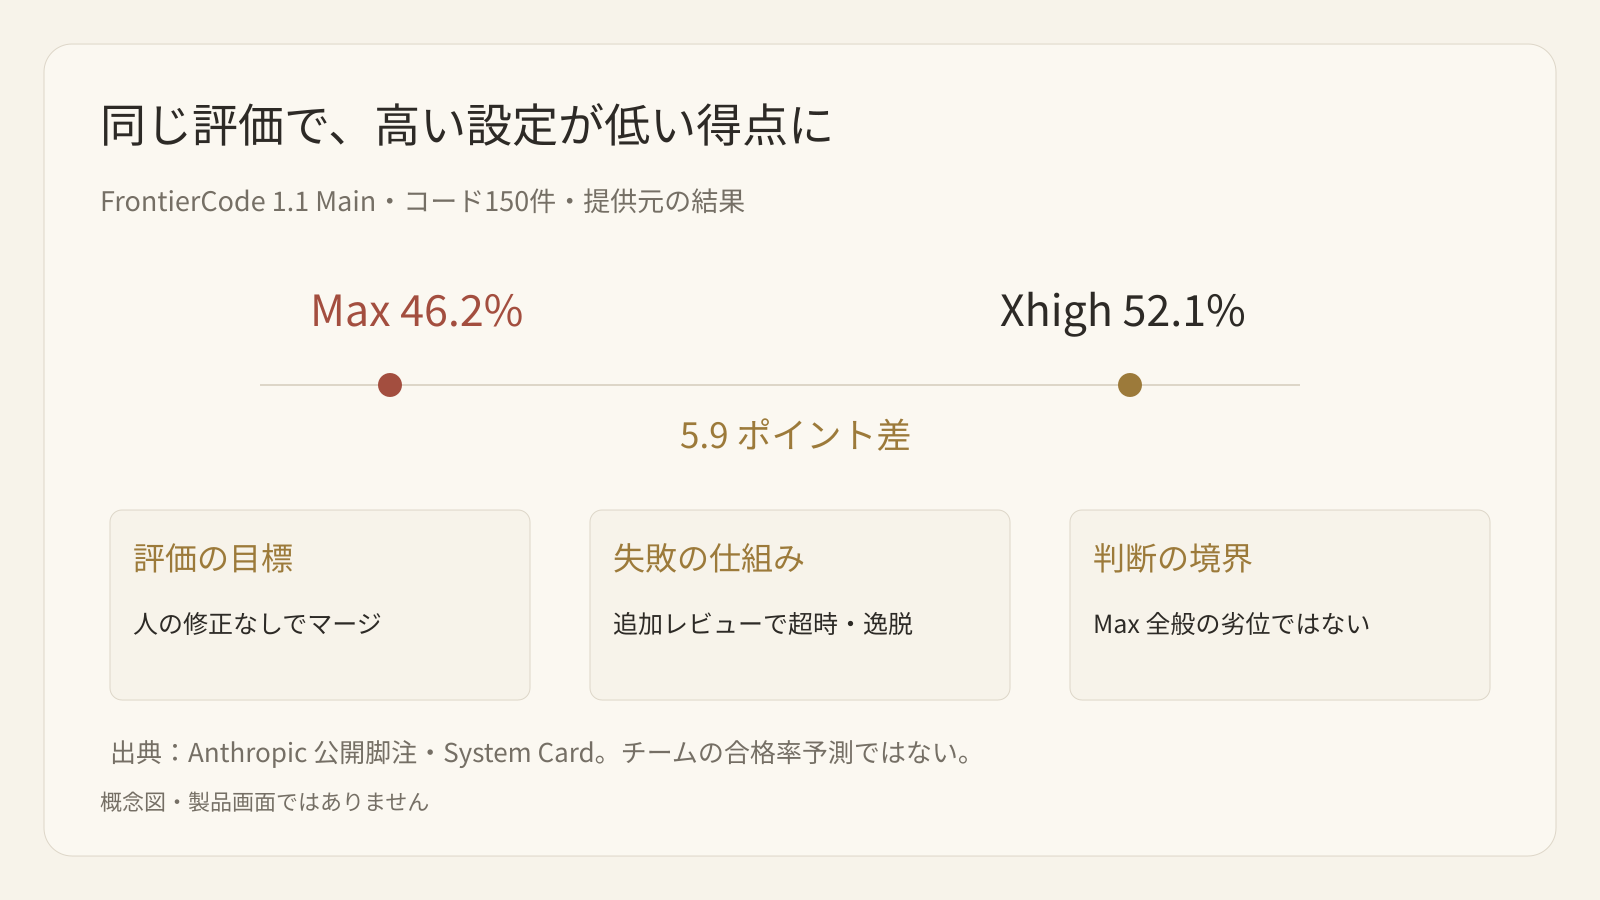
Anthropic が公開した FrontierCode 1.1 Main では、Sonnet 5.5 は Xhigh で 52.1%、Max で 46.2%。高い設定が 5.9 ポイント低い結果でした。問うべきなのは Max が常に弱いかではなく、追加の自律作業が成果物の合格条件に合っているかです。
この評価が求める成果物
System Card によれば、FrontierCode は Cognition が実際のオープンソース PR から作った 150 のソフトウェア課題です。Agent はリポジトリ、課題、テスト規範を受け取り、人の介入なしで修正します。機能上の必須条件とコード品質の評価が組み合わされます。
目標は人の編集なしでマージできる変更です。役立つ変更でも範囲外なら減点されます。公開記事の脚注では、Max が Claude Code の code-review skill を起動して複数の subagent に分担させることが増え、Cognition が確認した二つの事例ではタイムアウトや範囲外編集につながったと説明しています。
特定の実行環境での失敗機序であり、全業務の effort 順位やチームの成功率を示すものではありません。
Effort は作業の進め方も変える
公式ガイドでは、低い設定は長い作業の途中で確認を求めたり、Low では実質的な検証を省いたりすることがあります。高い設定では追加レビュー、文書、関連修正を始める場合があります。
一方は未完了を人に戻し、他方は許可されていない範囲へ広げます。速さだけでは必要なチェックの省略を見抜けません。消費が多いだけでは必要な慎重さと余計な作業を区別できません。
試験前に、必要な成果物、必要な検証、止まるか相談する境界を指定します。バグ修正なら対象ロジックと挙動を検証するテストを求め、無関係なリファクタリングは含めません。三つとも合格判定に入れます。
万能の既定値ではなく、課題別の出発点を選ぶ
Sonnet 5.5 の effort は再調整されており、Sonnet 5 と同じ名前でも同じ思考量ではありません。公式は一般的な Claude API 利用を High、明確な Agent コーディングや複数ツール作業を Medium、難しい長い課題を High、低遅延会話を Medium または Low から始めるよう勧めています。
Xhigh と Max は品質向上を測れた課題に使います。Adaptive thinking が必要で、between_tools は使えません。これは上流の推奨であり、Buda の選択画面や既定設定を説明するものではありません。
チームでは業務種類、初期設定、合格条件を対応させます。調査資料、コード修正、対話では失敗コストが違うため、全件 Max にする理由はありません。
停止条件をプロンプトに入れる
指示例は次のように書けます。
指定の変更を終え、対象の挙動を確かめる実際の検証を行う。必須チェックが通ったら停止して報告する。依頼されていない reviewer subagent、機能追加、無関係な編集は行わない。追加レビューは提案として分ける。検証できない場合は未実施項目と理由を示し、検証済み完了と報告しない。
必要なテストを禁止する指示ではありません。必須の検証と任意の拡張を分けています。高リスク課題では独立レビューを明示的な要件にして構いません。
公式の Max コーディング試験では、自発的な reviewer 起動を制限する指示により品質が変わらず会話コストが約三分の一減ったと報告されています。これはベンダーの試験で、一般的な割引や Buda の計測ではありません。再利用するのは条件を固定する方法です。
五つの結果を、同じ条件で記録する
入力、権限、指示、時間制限、合格基準を固定して、代表的な課題を隣接する二、三段階で評価します。前の試験のファイルが次へ影響しないよう同じ状態から始めます。
記録するのは、合格、範囲違反、全体時間、実行消費、人の手直し。安い失敗は安い納品ではありません。成果物が合格でも無許可の書き込みがあれば、無条件の成功とは扱いません。
同じ課金単位なら、全試行の費用を合格数で割って比較できます。合格ゼロでは成功一件の費用を算出できません。人の時間は別に示し、ドル、Credits、分を定義なしに足しません。
公式は頂点の effort 変更で prompt cache が無効になることも説明しています。Adaptive の beta per-message effort と合わせて、キャッシュ運用を記録し、設定差と混同しないでください。
安い一回が、安い納品とは限らない
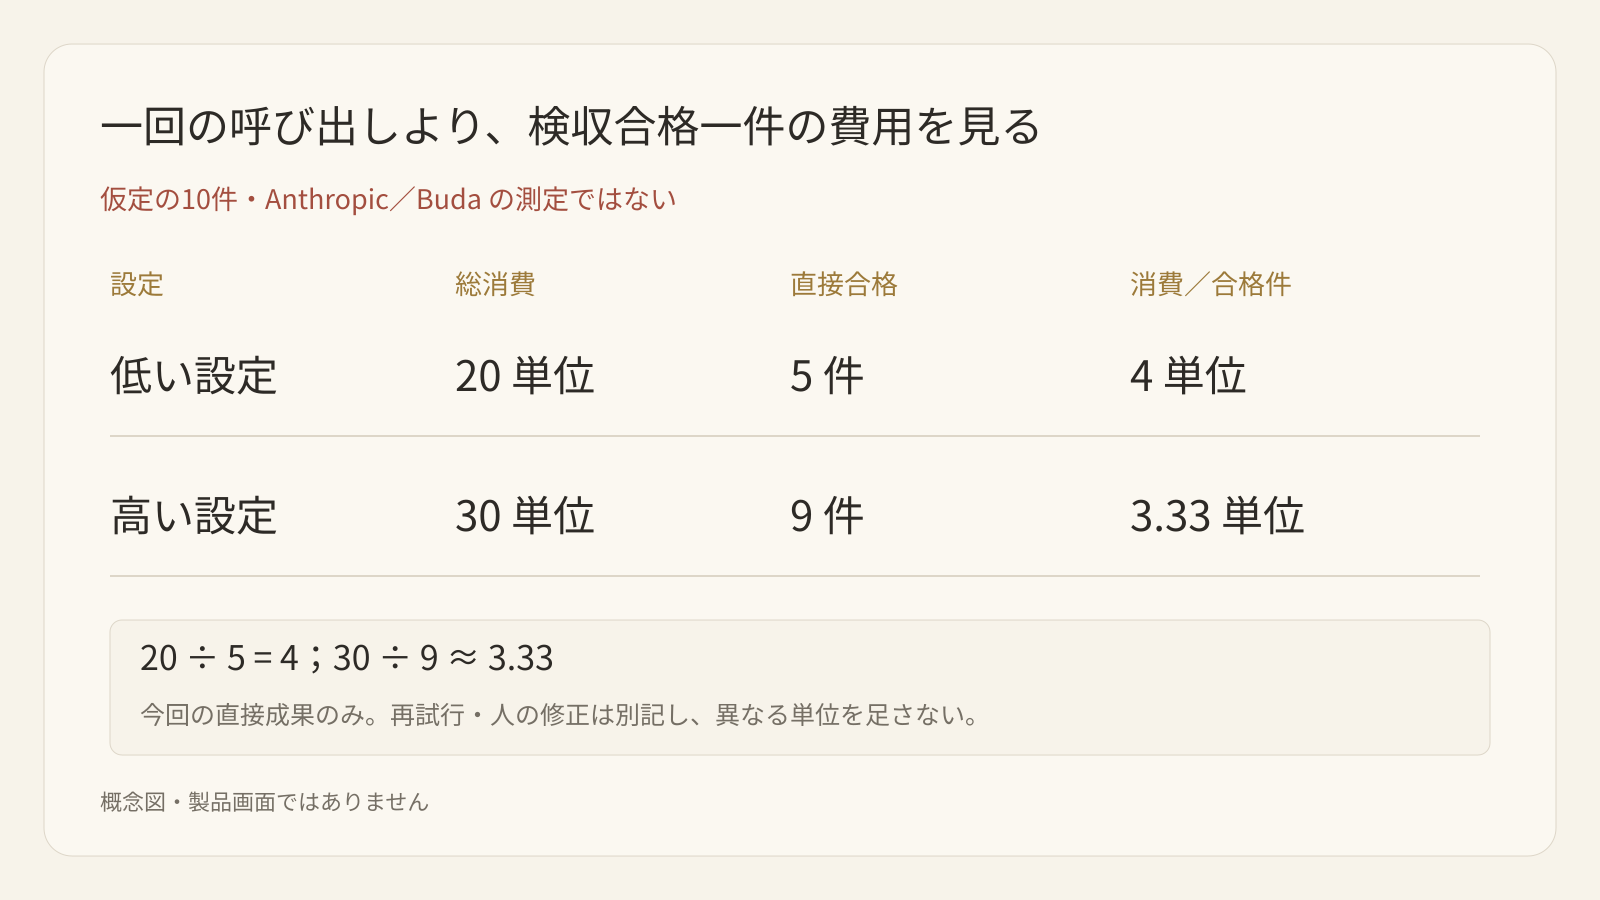
以下は計算方法を示す仮定のデータで、Anthropic や Buda の測定ではありません。同じ独立した十件を二つの設定で一回ずつ実行し、入力、ツール、検収基準を固定します。
| 実験 | 低い effort | 高い effort |
|---|---|---|
| 全試行の消費 | 20 単位 | 30 単位 |
| 手戻り・範囲逸脱なしで検収合格 | 5 件 | 9 件 |
| 一試行の平均消費 | 2 単位 | 3 単位 |
| 直接合格した一件あたりの消費 | 4 単位 | 約 3.33 単位 |
低い設定は一試行の消費が三分の一少ない一方、使える成果物も大幅に少なくなります。これは「今回の消費/直接検収した成果物」であり、未実行の再試行や十件すべてを納品する最終費用ではありません。後続試行と人の修正を記録しなければ、完全な予算にはできません。
逆に高い設定も範囲拡大で不利になります。必須テストの後に共通モジュール変更、文書の書き換え、追加レビューを始めれば、消費と新しいリスクが増えます。まず権限、作業範囲、停止条件を直し、追加作業を一律に責任感と評価しないことです。
平均点ではなく失敗の種類で次を決める
- 入力不足: 正しい仕様や期間がない。先に資料を追加します。設定を上げても未知の事実は保証できません。
- 検証不足: コードを変えたが必須テストを実行していない。ツールと完了条件を明確にして比較します。
- 推論不足: 入力も検証手段もあるのに重要な制約を見落とす。同じ基準で設定を上げ、改善を確認します。
- 範囲逸脱: 無関係なファイル、項目、業務規則を変更する。範囲と承認を絞り、変更量を品質と混同しません。
- 早い確認要求: 長い作業で質問して止まる。妥当な権限境界なのか、明確に許可された未完了作業なのかを区別します。後者だけを完了能力の不足として扱います。
平均値は重要な少数を隠します。九件の要約が正しくても、一件の契約で責任条項を落としたことは相殺できません。高リスク成果物は、全体合格率とは別に独立した人の確認を要求できます。
校正を条件付きの運用規則へ落とし込む
例えば「入力が完全で、読み取り専用ツールと納品一覧がある整理作業は Medium から開始。重要項目が欠ければ停止。出典と項目検査を通過して納品。繰り返し失敗したら合意済みのルールで設定変更または人へ引き継ぐ」と定義します。これは提案する手順で、能力保証ではありません。
設定、プロンプト、ツール権限を変えたら保存した回帰サンプルを再実行します。モデル ID、基盤、設定、プロンプト・ツールの版、新規会話か、キャッシュ状態を残します。条件が揃わない実験は問題発見に使い、精密な節約率として宣伝しません。
Claude Platform/API と Claude アプリ、Claude Code の既定値は混同しません。ここでの High は API 文書の文脈であり、すべてのクライアントや Buda の設定を意味しません。実験表には推測ではなく実際の設定を記録します。
最小限で十分な設定を標準にする
安定して合格する最低段階を日常の出発点にし、必要な課題だけ上げます。材料不足なら入力、権限不足なら認可、早期停止なら完了条件を直します。推論不足かどうかを確認してから effort を上げます。
Buda は Agent の実行文脈と再利用する流れを支えます。入力、ツール境界、確認項目を手順に残すほうが、毎回「もっと慎重に」と頼むより検証しやすくなります。特定の effort 操作や上流スコアの再現を保証する説明ではありません。
FAQ
Max を使わないほうがよいですか?
一律禁止ではありません。複雑な課題で自分の実行環境における効果を測ります。
52.1% はチームの成功率ですか?
特定のコード評価の数字であり、そのまま当てはめられません。
低い effort は必ず安いですか?
一回の試行は安くても、再試行と手直しで逆転する可能性があります。
追加レビュー制限はテストも省きますか?
必須テスト通過後に停止し、追加レビューを別扱いにする必要があります。