
評価コードが finish_reason=CONTINUATION を受け取ったのに、表示テキストは空だった。失敗扱いして「続けて」と送ると別の生成が始まる。同じ生成の再開を、新しい会話として扱ってしまったのだ。
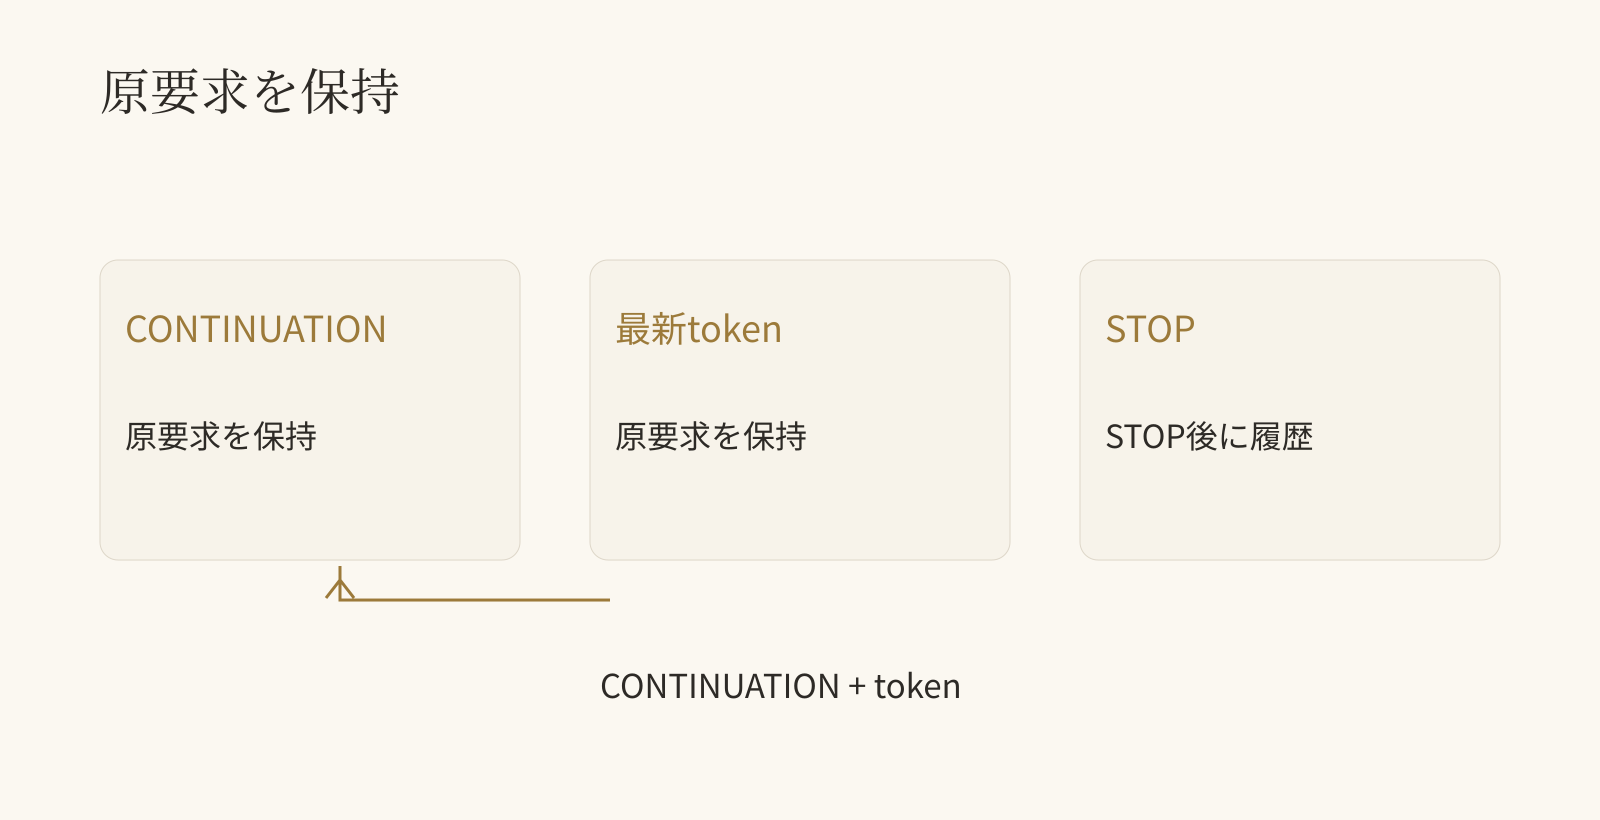
Gemini 4 Argon の long decode は continuation token で生成状態を再開する。自作クライアントでは原要求と最新tokenを再送する。一般的な用途では対応する Google Gen AI SDK に任せられる。
入出力は一つの枠を使う
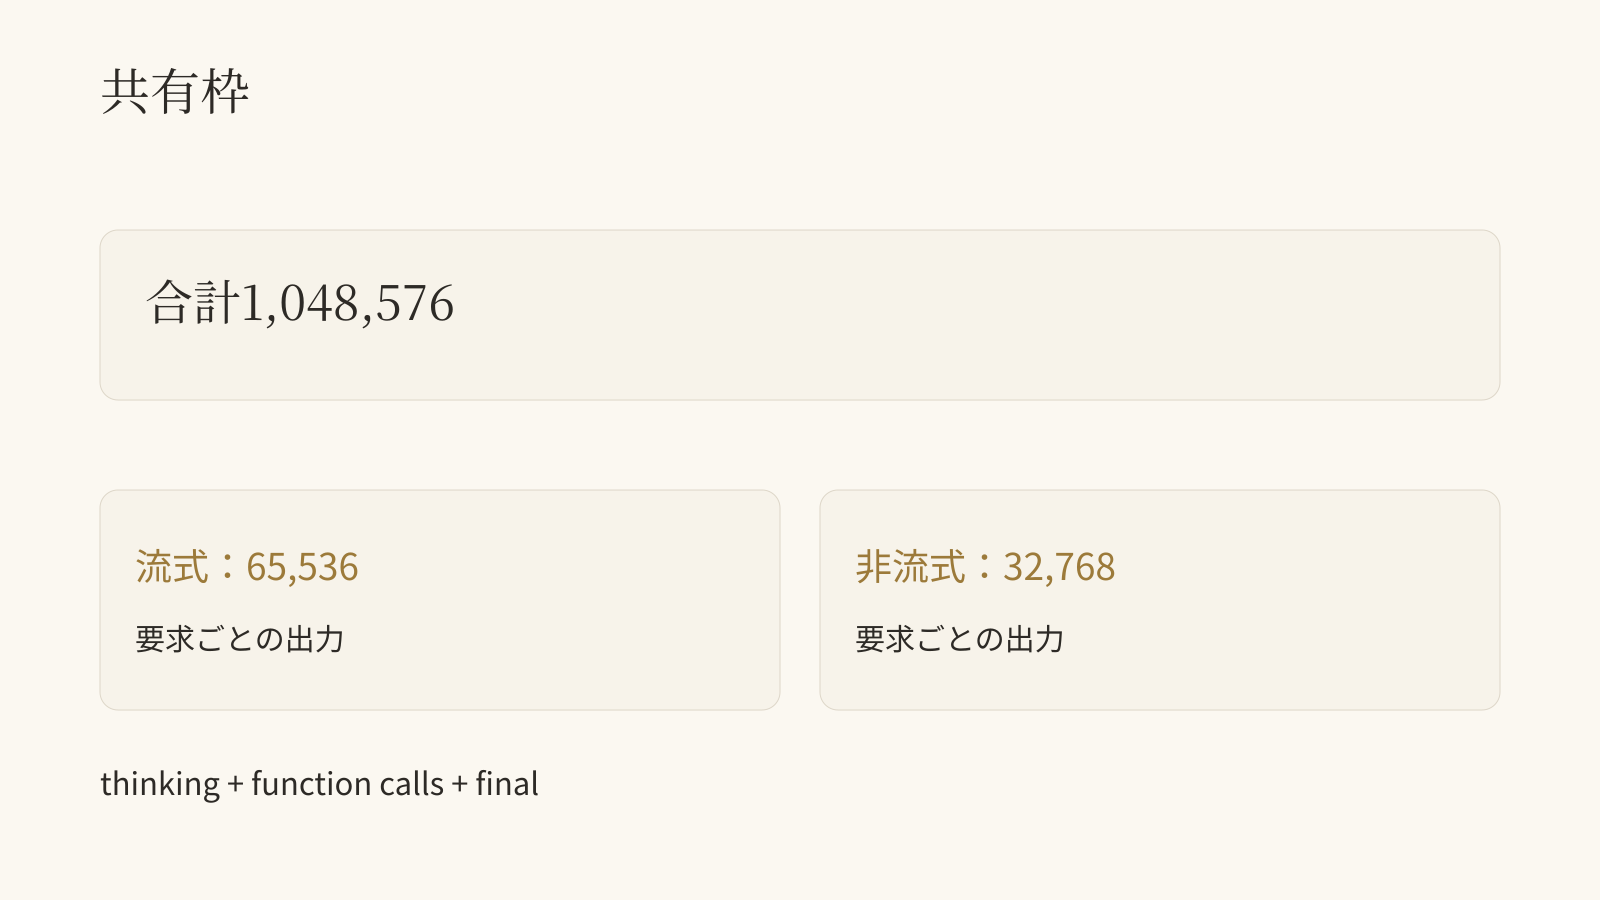
開発者ガイドの上限は入出力合計 1,048,576 token。出力には思考、関数呼び出し、最終回答が含まれる。入力百万と出力百万の二枠ではない。
ストリーミングの一段は最大65,536、直接HTTP非ストリーミングは32,768出力token。複数要求に分かれても合計枠と出力設定は残る。仮に入力200,000なら出力の算術上限は848,576であり、実際の長さの予測ではない。10月13日の発表と、現在のAPI規約を区別して読む。
SDKか自作ループかを選ぶ
Pythonは google-genai>=2.30.1、JavaScriptは @google/genai>=2.29.1 が自動継続に対応する。適切な max_output_tokens を設定する。
自作RESTは v1beta1 の streamGenerateContent または generateContent。long decodeは現在 v1 と Interactions API に対応しない。SDKは上書きしなければ v1beta1 が既定。古いSDKやOpenAI互換層ではtokenによる長生成を取得できない。
長生成には出力設定を流式65,536超、非流式32,768超にする。低遅延の対話や抽出、短いツールターンには通常不要。最大枠を常に指定しない。
原要求を変えずに再送する
contents、system_instruction、tools、生成設定を初回前に固定し、最新tokenだけを付けて再送する。途中回答を入力に追加せず、「続けて」に置き換えない。tokenは原プロンプトのhashと生成状態を持つ。
次は制御の擬似コードで、実行済みAPI例ではない。応答解析は実際のクライアントに合わせて実装する。
original = immutable_copy(authorized_request)
latest_token = absent
for segment in bounded_segment_count:
    response = call_v1beta1(original, latest_token)
    save_redacted_segment_metadata(response)
    accumulate_parts(response)
    if finish_reason == STOP: finish_one_model_turn()
    elif finish_reason == CONTINUATION and token_exists:
        check_time_and_total_budget()
        latest_token = response_token
    else: stop_for_explicit_handling()
思考だけの段は parts: [{"text": ""}] になりうる。CONTINUATIONとtokenがあるなら空テキストだけで失敗としない。tokenなしや未知の終了理由は盲目的に再試行しない。
token付き MAX_TOKENS は設定した生成枠の到達を示す。ガイドでは上限を増やす方法を示すが、自動増額せず許可された予算を確認する。STOP 後にだけ累積partsを一つのmodel turnへまとめ、次の履歴に使う。
使用量の二つの集計方式
Python SDKの最終応答・chunkの usage_metadata は継続要求全体の課金tokenを累積する。累積値を重ねて加算しない。
自作RESTは各要求の中で累積する。要求ごとの最終prompt、cached-content、candidate、thought値を合計する。ストリームの各スナップショットを加算しない。
以前の生成片を再prefillするので prompt_token_count は増える。元の文脈には initial_prompt_token_count を使い、tokenがなくなる生成完了までcompactionを待つ。途中の履歴変更は規約を崩す。
暗黙キャッシュは条件を満たす文脈に95%割引、最低6,144 token、TTLは15〜20分。仕事全体の95%割引ではない。出力や思考などの費用を別に考える。明示的context cacheは未対応だ。
古い設定を持ち込まない
thinking levelはLOW、MEDIUM、HIGH。通常Argonの既定はMEDIUM、cyber-permissiveはHIGH。thinking_budget、MINIMAL、frequency_penalty、presence_penalty、candidate_count は400。temperature、top_k、top_p の指定値は無視される。
関数応答は直前の呼び出しのID・名前・順序に対応させる。通信再試行とツール副作用を別管理し、切断を理由に送信や支払を再実行しない。
小さな要求で停止と会計を確認する
推奨ケースは短いSTOP、思考のみの継続、複数段で原要求不変、上限到達、非対応版、ツール実行後の切断。指紋・終了・集計・副作用記録を確認する。実際のAPI測定結果ではない。
移行表と匿名化した証拠を Driveへ。Workspaceは資料と許可されたコードの置き場になるが、継続対応は実クライアントで確認する。
long decodeが不要なのは?
要約、分類、短いツール対話など一段で終わる応答。入力が大きいほど出力に残る共有枠も減る。
「続けて」ではなぜ駄目?
新しい要求になり、元の生成状態を再開しない。最新tokenと原要求を使う。
費用画面は何を読む?
Python SDKは最終累積値、RESTは各要求の最終値の合計。集計方式と段IDを残す。まず再開・停止・会計を確かめてから出力枠を広げよう。