
同じ資料について質問したのに、数日後には違う説明が返ってくる。PDFを開き直し、原文を探し、どの版が根拠なのか確かめる。保存した資料は残っていても、前回の確認が次の判断に生かされていないことがあります。
Astro-Hanのリポジトリで管理されるKarpathy LLM Wikiは、この維持作業を明示します。原文を保ち、知識記事を更新し、新しい証拠が来たら関連する主張も調べる。普通の質問では知識庫を書き換えません。一つの資料がどう知識になり、結論が変わったとき何を直すのかが運用の要点です。
原文・知識記事・索引・ログを分ける
raw/は変更しない原文、wiki/は編集を続ける知識記事です。原文にはURL、収集日、公開日を記録し、意見を書き換えません。知識記事は概念ごとにまとめます。wiki/index.mdは記事への入口、wiki/log.mdは追記専用の操作記録です。ファイルの蓄積はモデルの重みが学習することを意味しません。
この分離により、新しい情報で解釈を変えても、以前の判断を支えた資料を確認できます。結論に合わせて原文を修正してはいけません。
ステップ1:Skillを導入し、実際の資料を取り込む
Buda AIのMarketplaceでKarpathy LLM Wikiを検索し、管理者とリポジトリを確認してインストールします。専用のプロジェクトを用意し、Agentが実際に読める資料を渡します。読めないPDFや認証が必要なURLには、別途抽出やアクセスの準備が必要です。
指示例は「この資料を取り込み、原文とメタデータを保存してください。既存記事を検索してから新規・更新・争点を判断し、変更ファイルと重要な主張の根拠箇所を返してください」。初回のIngestは不足する構造だけ作成します。QueryやLintは空の知識庫を自動作成しません。
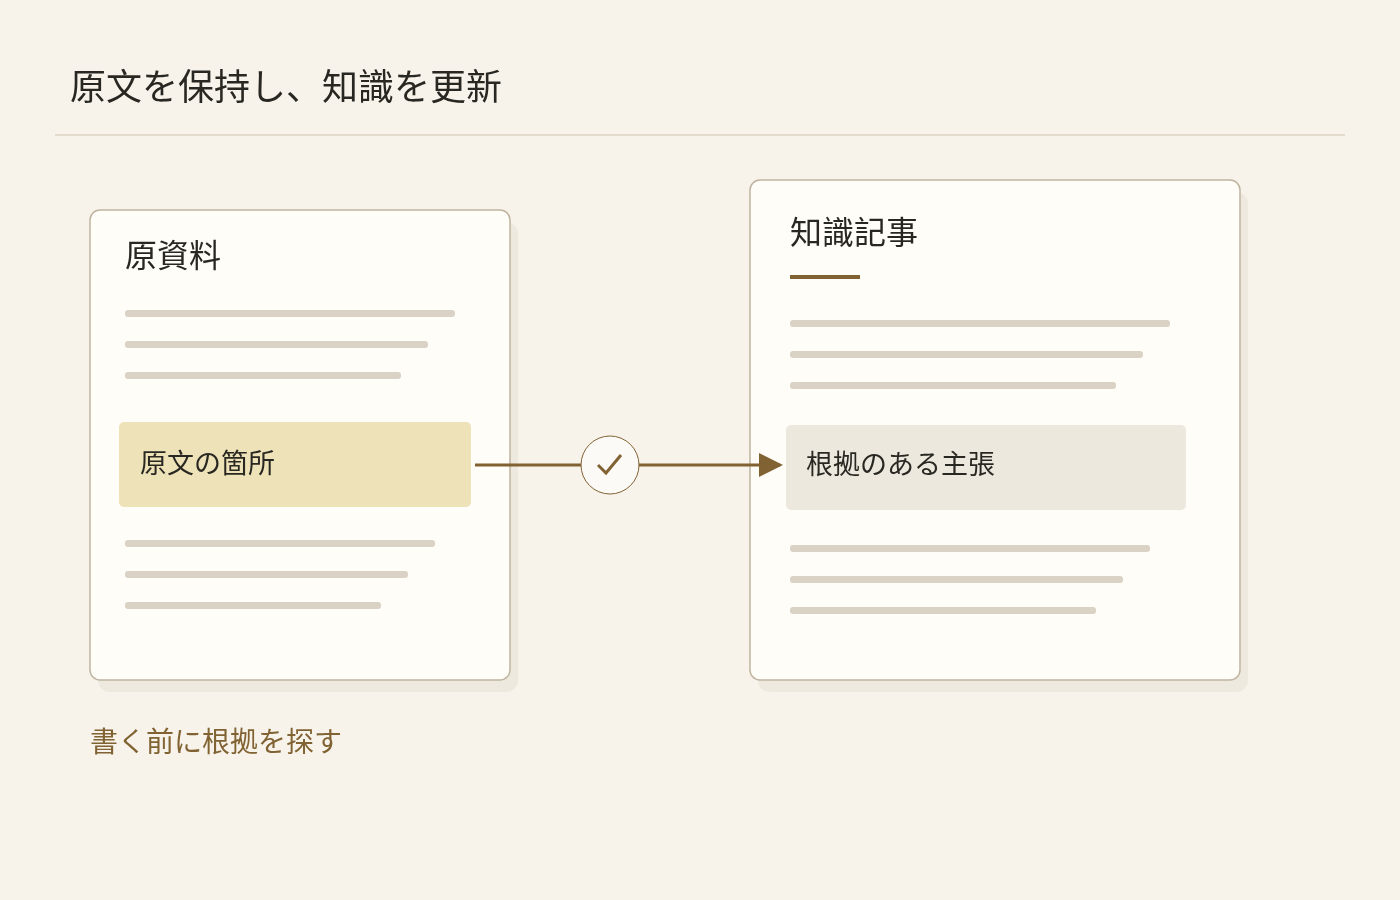
ステップ2:新規・更新・争点を判断する
保存後、固有名詞と同義語で既存記事を検索します。Newは新規記事、Updateは既存記事への統合、Disputedは矛盾の明示です。これらは組み合わせられます。No materialは排他的で、新しい知識がなければ原文とログだけを残します。毎回ページを増やす必要はありません。
数値、日付、直接引用は、書く前にリンク先の原文で探します。表記も保持し、計算値には構成要素を示します。ただし、原文と一致することと、その原文が正しいことは別の確認です。
ステップ3:関連する知識記事も更新する
索引だけでなく本文全体を検索し、影響を受ける記事を確認します。置き換わった主張はOutdated、対立する主張はDisputedとして履歴を保ち、別記事の争点も相互参照します。時点を固定したアーカイブは連鎖更新しません。変更した記事の知識更新日を索引に反映し、操作ログへ追記します。
レビューでは、新規記事数より「影響したファイル、根拠箇所、古い結論の取り残し」を見ます。
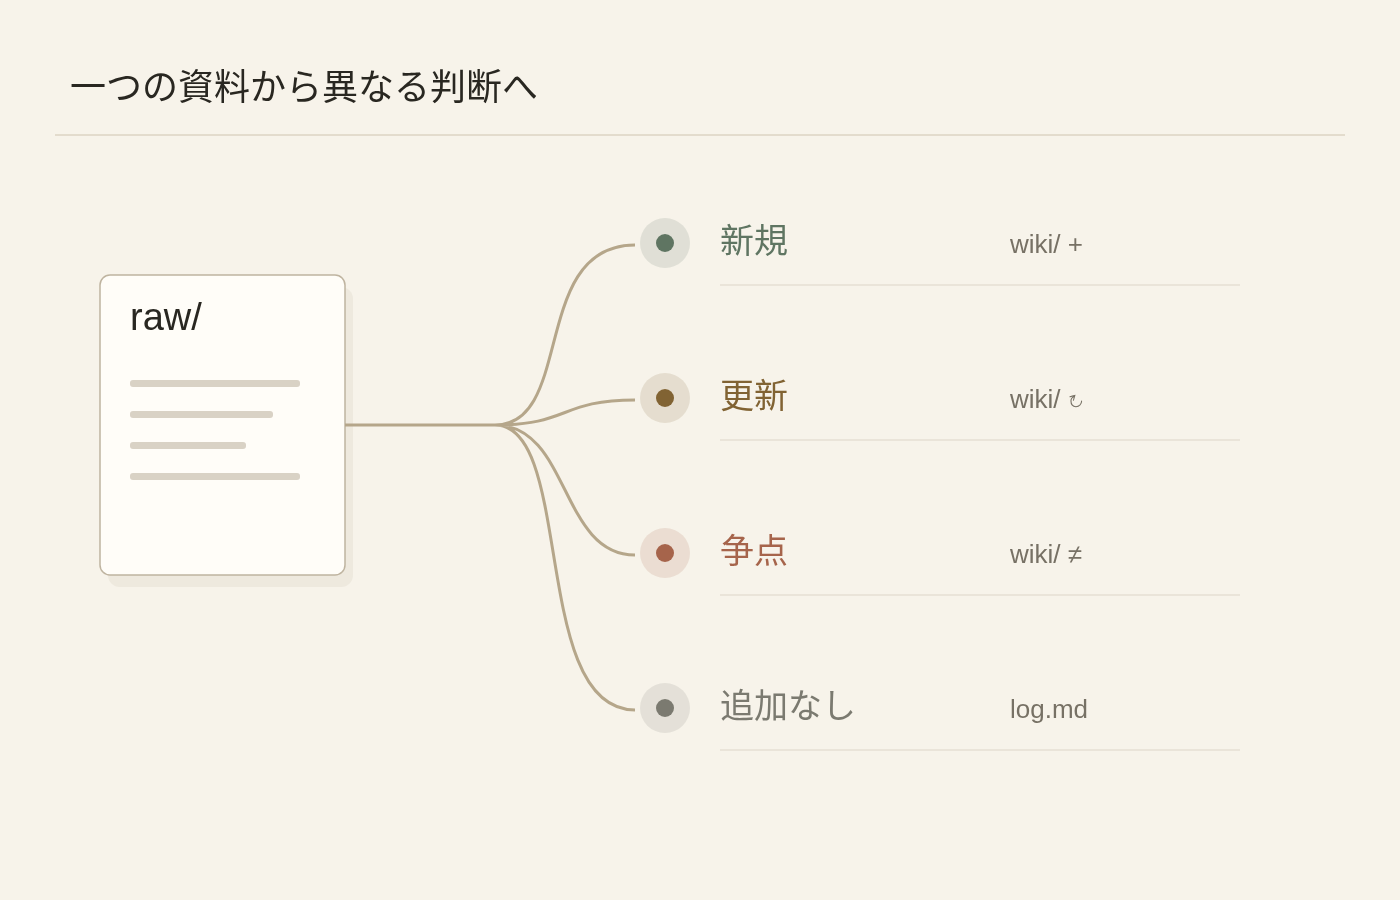
ステップ4:質問し、必要な回答だけ保存する
Queryは索引と全文検索を併用し、知識記事へのリンクを付けて回答します。通常の質問ではファイルを書きません。回答を保存するよう明示した場合だけ、参照記事を出典とする新しいアーカイブを作り、索引とログを更新します。
ステップ5:リンクと根拠を確認する
Lintは索引の欠落や移動先が一意のリンクなどを修復できます。候補が複数なら判断を求めます。check_evidence.pyはリンクした原文の特徴的な文字列を調べますが、疑いは文脈で判定し、矛盾を自動的に事実修正しません。
原文、分流の説明、根拠のある記事、索引、ログが一式で確認できれば、最初の運用を評価できます。BudaのDriveとファイルツールを使ってこの仕組みを構築し、実行環境とSkill一式を確認してから範囲を広げてください。正確な形式はソースリポジトリで確認できます。
何度も使う一つの資料から始める
Karpathy LLM WikiのSkillページを開き、Buda AIのMarketplaceで検索してAgentにインストールします。実際の資料を一つ渡し、原文・知識記事・出典リンクを確認してから次の資料へ進めてください。