GPT-6.1 Sol:エージェント業務は完成した成果で評価する
OpenAIがSolの新モデルを公開しました。重要なのは、実務のタスクで検証できる成果を出せるか、そして人が何を確認するかです。
GPT-6.1 Sol は2026年9月29日にOpenAIが発表したSolの更新です。コード、複数ステップの処理、PC操作、複雑な資料での進歩が報告されています。モデルの一斉切り替えを考える前に、成果を検査できる仕事を一つ選びます。
GPT-6 Solから何が変わったか
以下はOpenAIが特定の設定で公開した評価です。テスト対象を選ぶ材料にはなりますが、チームの合格率を予測するものではありません。
長いコーディング作業
DeepSWE v1.1でGPT-6 Solの最高スコアより6.4ポイント高いとOpenAIは報告。実際のリポジトリ、失敗するテスト、合格条件で試します。
複数ツールを使う業務
同じ推論強度でAutomationBenchが4.8ポイント向上。自社システムでの成功率を示す数字ではありません。
PC上の操作
OSWorld 2.0のオフラインセットで最大推論時に7ポイント向上。ブラウザーやアプリの権限は別途設定が必要です。
複雑な資料の確認
表や図を含む専門的なPDFの理解をOpenAIが強調。数値の出典ページと計算過程を確認します。
合否を判定できる仕事から始める
明確な成果物を指定し、実際の結果を確認してから採用を決めます。
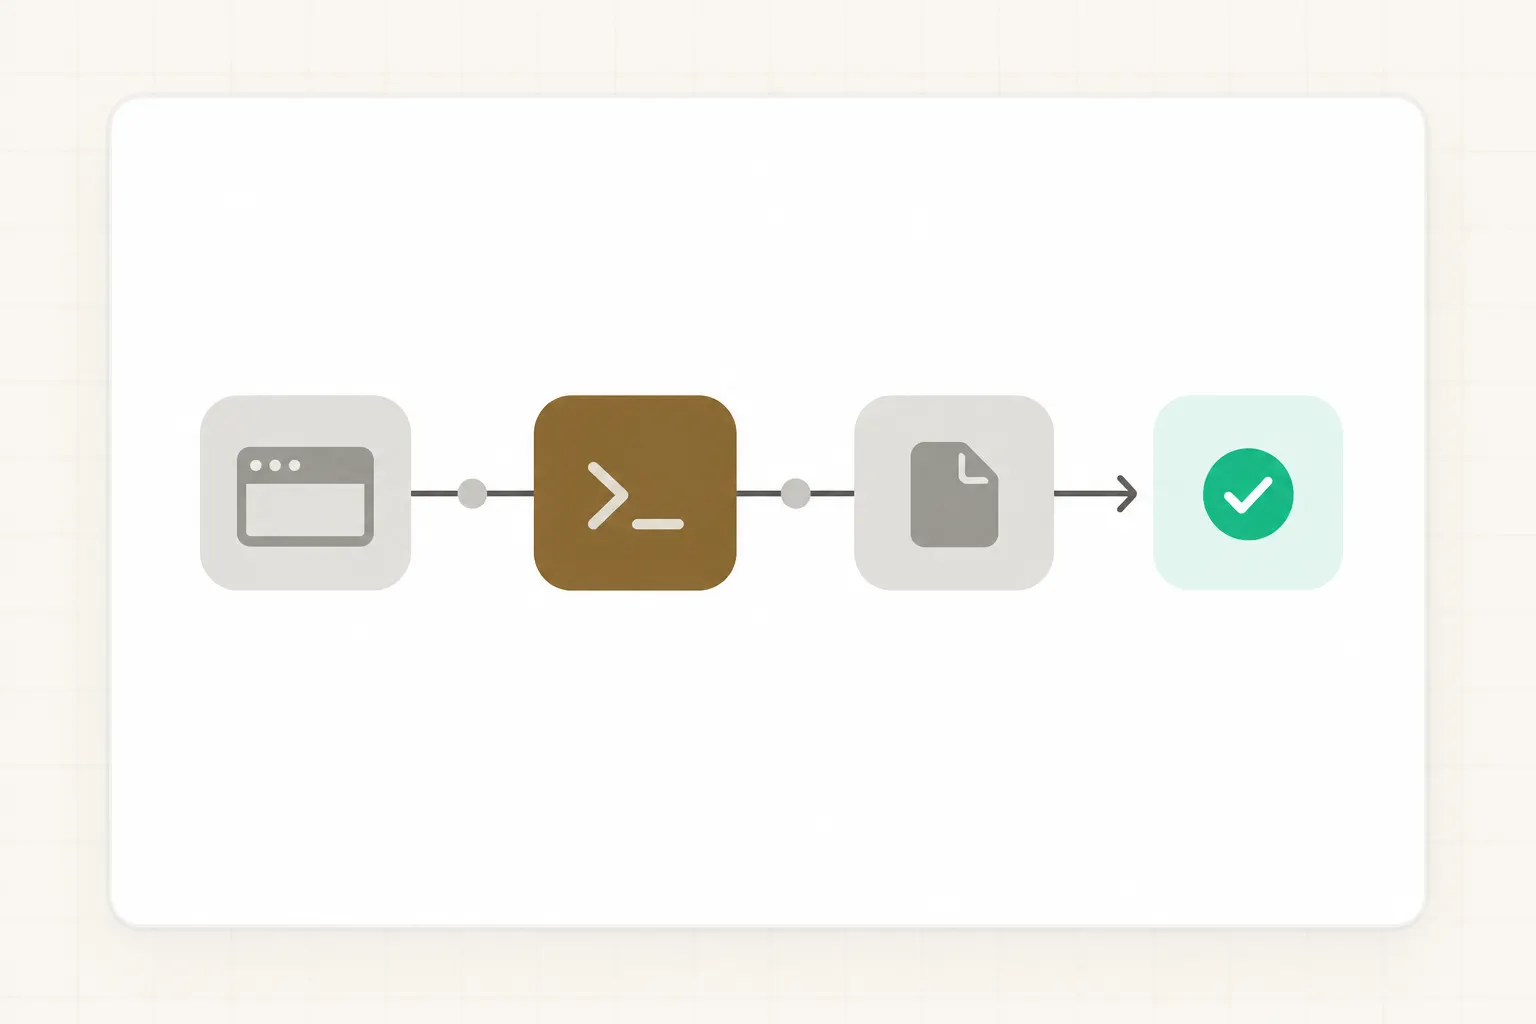
具体例:失敗するテストから修正を検証する
評価のための作業設計です。GPT-6.1 SolがBudaでこの作業を実行した実例ではありません。
1 · 入力をそろえる
リポジトリのスナップショット、再現できる失敗テスト、簡単な不具合報告を用意。変更可能なモジュールと触れてはいけないファイルを明記します。
2 · 完了条件を決める
まず失敗を再現し、範囲を絞った修正、関連テスト、変更ファイルと未検証の動作の説明を求めます。
3 · 成果を検査する
同じタスク内で差分とテストログを確認し、重要なテストを人が再実行します。スキーマ変更、秘密情報、デプロイが必要なら別途承認します。
普遍的な順位より自分の仕事と根拠を照合する
| タスク | GPT-6.1 Sol | GPT-6 Astra | 人による確認 |
|---|---|---|---|
| 失敗テストがあるコード修正 | DeepSWEが示す改善を自社のコードで検証 | 同じテストと制約で比較 | 差分とテスト結果を確認 |
| 複数ツールの業務 | AutomationBenchが示す改善を隔離環境で検証 | 同じツールと条件で比較 | 出典と作業記録を確認 |
| 高リスクで自由度の高い判断 | 必要なら範囲を絞った調査に使う | 代表的な事例で別途評価 | 責任者が判断 |
5件の実務タスクで試す
モデル間で入力、ツールの権限、合格条件を固定。
簡単な1件、一般的な2件、境界的な2件を選ぶ。
合格した成果、確認までの時間、人の修正、ツールの失敗を記録。
失敗を再検証し、成果物を見てから既定の作業手順を変える。
作業を後から確認できる形に
Drive
リポジトリ、依頼、テスト、完成したファイルを保存。
Agent セッション
コマンドと途中の成果も確認し、最終回答の文章だけで判断しない。
人の判断
テスト後に修正を受け入れる。マージやデプロイ、外部変更は別途承認する。
よくある質問
GPT-6.1 SolをBudaで使えますか?
OpenAI は API、ChatGPT Work、Codex での提供を発表しました。Buda で選べるかは未確認です。利用前にモデル一覧を確認してください。
GPT-6 Solとの違いは何ですか?
OpenAIはエージェントによるコーディング、複数ステップの業務、PC操作などの評価で改善を報告しています。特定のテストの結果なので、自社の仕事で確かめます。
OpenAIではどこから使えますか?
OpenAIはAPIモデル名gpt-6.1-solと、対象プランのChatGPT WorkおよびCodexでの提供を案内しています。発表時点では通常のChatでは使えません。
ベンチマークの伸びは自社の合格率ですか?
いいえ。OpenAIの評価環境と推論設定に依存します。代表的な社内タスクで確認してください。
最初にどんな仕事で試すべきですか?
元ファイルと合格条件が明確な仕事を選びます。再現可能なバグ修正なら、差分、テストログ、未検証項目まで成果物に含めます。
GPT-6 Astraを検討するのはどんな場合ですか?
自由度が高く難しい仕事やリスクの大きい仕事では、同じ条件の評価対象に加えます。この表は自動ルーティングでも、常に一方が優れるという保証でもありません。
二つのモデルを公平に比べる方法は?
入力、許可するツール、合格条件をそろえ、代表的な仕事で合格した成果と人の修正量を比較します。ベンチマークの順位だけでは判断しません。
人による確認は不要になりますか?
不要にはなりません。本番変更、顧客への連絡、公開には人の判断が必要です。
確認できる成果から始める。
範囲、元資料、合格条件を明確にする。実行過程は見える形に、最終判断は人に残します。