Buda vs Deep Agents Code: quem mantém o runtime e quem aceita a entrega?
Compare manutenção, evidências e transição do trabalho entre pessoas.

Uma demonstração termina quando o Agent produz um patch. O trabalho de uma equipe continua: alguém precisa verificar a mudança, encontrar a evidência na semana seguinte e manter modelos, ferramentas e ambiente de execução.
Essa divisão de responsabilidades é um ponto de partida melhor para avaliar uma alternativa ao Deep Agents Code do que contar recursos. Deep Agents Code atende desenvolvedores que querem compor o runtime. Buda atende equipes que querem organizar tarefas, acompanhar a execução e inspecionar arquivos em um workspace na nuvem. Nenhum dos dois elimina a responsabilidade humana por permissões ou aceite.
dcode não é apenas um terminal local
Deep Agents Code, executado com dcode, é um Agent de programação open source construído sobre o Deep Agents SDK. O SDK é uma base de desenvolvimento; dcode é uma interface executável construída com essa base.
A documentação inclui troca de modelos e provedores, memória persistente, compactação de contexto, skills, MCP, subagents e rastreamento no LangSmith. Ferramentas podem rodar em sandboxes remotos. Seria incorreto descrevê-lo como uma ferramenta sem memória, restrita a um único Agent ou obrigada a executar tudo no computador do operador.
Goals e rubrics merecem atenção. Um goal permite que o Agent proponha critérios de aceite; uma rubric recebe critérios já definidos pela equipe. Goals permanecem ativos entre turnos e podem ser alterados, pausados e retomados. A definição de concluído passa a fazer parte do ciclo de execução.
No Buda, a unidade de organização é o Agent Workspace: conversa, arquivos persistentes, Terminal, navegadores, preview e Git são diferentes visões do mesmo computador na nuvem. Arquivos produzidos aparecem na área de arquivos; aplicações podem ser abertas no preview; commits ficam disponíveis no Git. Código é um tipo de entrega, não o único.
Compare responsabilidades, não listas de recursos
| Decisão | Deep Agents Code | Buda |
|---|---|---|
| Definir conclusão | Goals e rubrics participam da execução e avaliação | Especificar entregas e verificá-las no workspace |
| Local de execução | Ferramentas locais ou sandbox remoto configurado | Ambiente na nuvem do Agent |
| Manter configuração | Selecionar provedores, credenciais, ferramentas e parâmetros | Gerenciar Agents e contexto; integrações e acesso ainda exigem configuração |
| Inspecionar processo | Terminal e rastreamento no LangSmith | Conversa, arquivos, Terminal, navegadores, preview e Git |
| Passar o resultado adiante | Definir convenções de repositório, arquivos e revisão | Reunir arquivos e visões de execução; o aceite continua humano |
Hospedar o ambiente não cria automaticamente uma política de aprovação da empresa. Um avaliador também não substitui a pessoa responsável pelo resultado de negócio.
Um teste de engenharia com critérios verificáveis
O cenário a seguir é uma proposta de piloto, não um benchmark executado. Considere um serviço que precisa de tratamento de refresh no OAuth. “Adicionar renovação” deixa questões importantes em aberto.
Um arquivo de aceite pode exigir que tokens expirados sejam renovados, que um refresh token inválido produza erro claro e que requisições concorrentes não criem um ciclo ilimitado. Os testes existentes devem continuar passando, com casos novos para expiração, repetição e concorrência. Também deve proibir mudanças em módulos não relacionados e credenciais nos logs. A entrega inclui resumo, comandos de teste e limitações pendentes.
O guia oficial de goals e rubrics oferece dois caminhos. Use /goal quando quiser receber critérios propostos antes da execução. Use um arquivo de rubric quando a equipe já tiver seu padrão. Execuções não interativas aceitam --rubric.
Revise os critérios antes de confiar na nota. Testes passando não justificam vazamento de token. Uma mudança pode passar nas verificações automáticas e quebrar o fluxo de login de clientes. Trocar o modelo avaliador ou aumentar iterações não resolve esse julgamento de negócio.
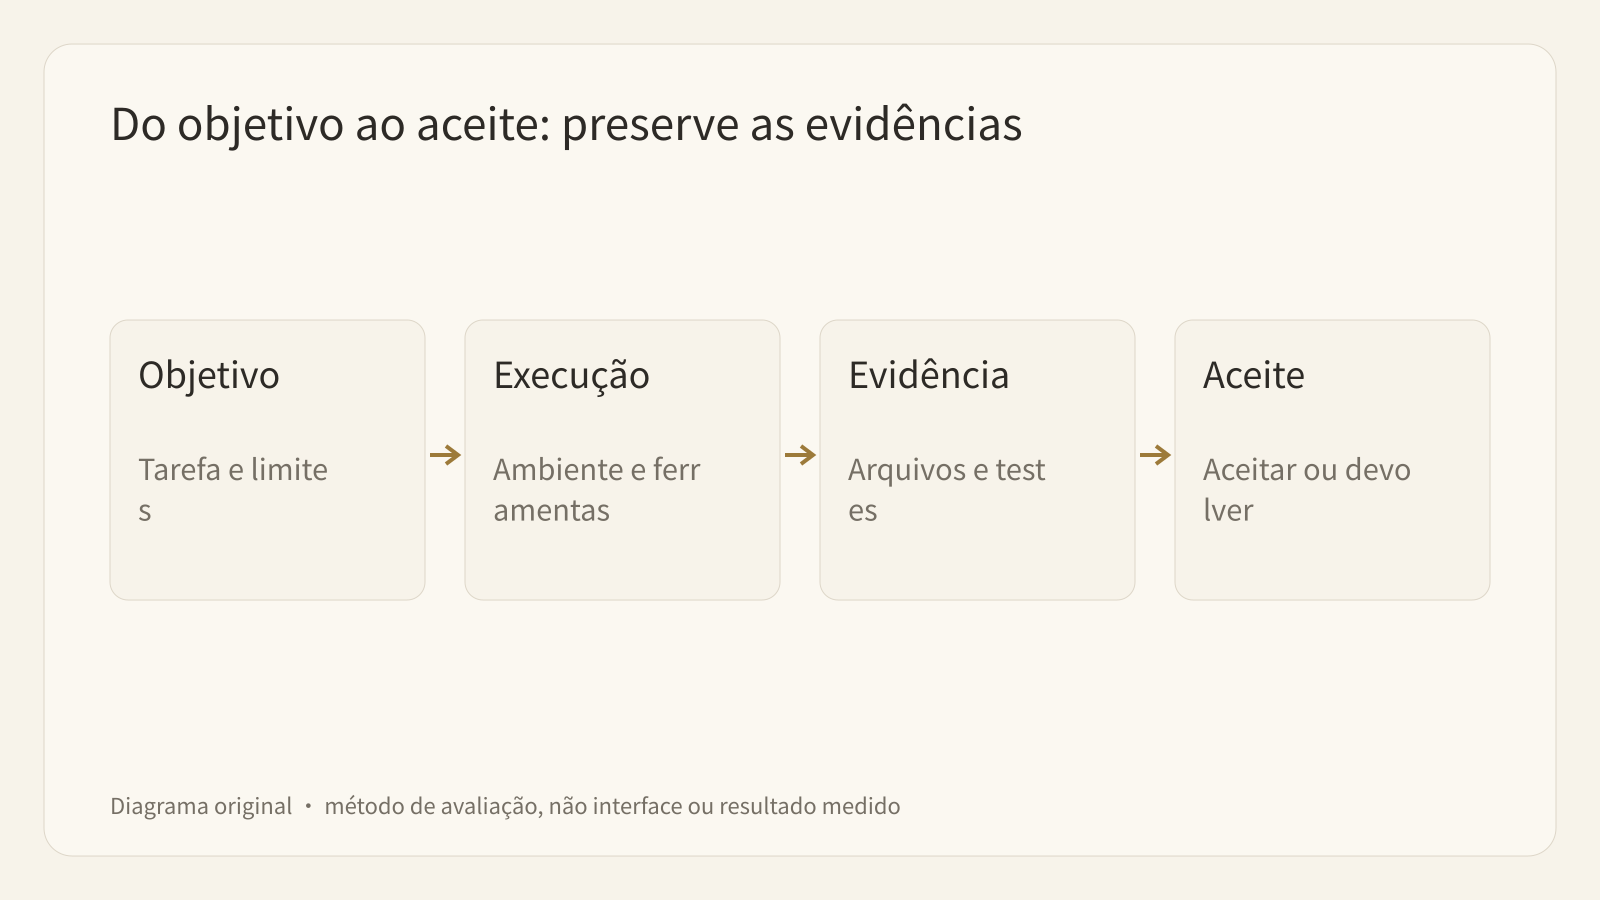
No Buda, organize a tarefa ao redor do repositório, arquivos e resultados observáveis. Exija o patch, a evidência dos testes e a localização do log ou preview. Este artigo não executou a mesma tarefa nos dois produtos e não apresenta ranking de velocidade, custo ou taxa de sucesso.
O patch precisa de um pacote de transição
Suporte precisa explicar o erro; produto precisa entender quais jornadas mudaram; operações precisa atualizar instruções. Um patch não responde sozinho a essas necessidades.
Peça um change-summary.md, resultados dos testes, limitações conhecidas e uma explicação para quem não desenvolve software. Vincule os documentos à versão correta e às evidências. A próxima pessoa não deveria reconstruir a conclusão percorrendo uma longa conversa no terminal.
dcode pode produzir esses arquivos. A equipe decide armazenamento, acesso, rastreamento e disciplina de entrega. Buda reúne arquivos e visões de execução no mesmo workspace, mas a empresa ainda determina quem pode aceitar e compartilhar o trabalho. A mensagem “concluído” é uma afirmação do Agent; arquivos acessíveis, testes e comportamento reproduzível tornam essa afirmação verificável.
Faça duas rodadas
Uma primeira demonstração costuma esconder o esforço de quem conhece a ferramenta. Repita com entrada modificada e outro destinatário. Registre separadamente:
- Preparação de credenciais, ferramentas, permissões e ambiente.
- Esforço para encontrar versão, testes e problemas pendentes.
- Capacidade de continuar a partir dos arquivos sem chamar o operador original.
- Efeito de alterar provedor, rubric ou configuração de ferramentas.
Separe gasto de execução, configuração, correções e revisão humana. Assim, práticas operacionais diferentes não viram uma suposta superioridade do modelo. Isso é um desenho de avaliação, não uma promessa de economia.
Escolha a camada que quer controlar
Deep Agents Code faz sentido quando a equipe quer adaptar provedores, avaliadores, ferramentas e sandboxes ao seu sistema de engenharia. Manter esses componentes pode ser um investimento deliberado.
Buda merece um piloto quando o gargalo é encontrar histórico, arquivos e entregas entre diferentes funções. Comece com uma tarefa que produza um resultado concreto em vez de migrar todo o trabalho de uma vez.
É possível usar as duas abordagens para trabalhos distintos. Essa divisão sugerida não significa integração direta validada: não presuma sincronização automática de memória, aprovações ou arquivos.
Perguntas frequentes
Deep Agents Code funciona apenas localmente?
Não. A documentação lista sandboxes remotos. A interface de terminal não determina o local de execução das ferramentas.
Qual a diferença entre goal e rubric?
Goal parte de um objetivo e permite propor critérios. Rubric recebe critérios já conhecidos. Goals têm ciclo de vida; rubrics podem valer para um turno ou continuar nos seguintes. O comportamento de revisão depende do modo de aprovação e das configurações.
Buda tem o mesmo avaliador nativo?
A documentação citada não comprova uma função idêntica. Defina requisitos de aceite e inspecione arquivos, testes e evidências em vez de afirmar equivalência.
É possível comparar licença open source com assinatura diretamente?
Inclua modelo, infraestrutura remota, manutenção e revisão. Consulte os planos e Credits em preços do Buda. Não há vantagem de custo medida neste artigo.
Vale migrar um fluxo dcode estável imediatamente?
Não é necessário. Comece por uma tarefa com dificuldade de transição entre pessoas. Expanda somente depois de verificar o resultado e o esforço operacional.
Escolha uma tarefa real e escreva entradas, ações permitidas, arquivos de saída e condições de aprovação. Use a mesma lista nas duas abordagens e entregue o resultado a uma segunda pessoa. Conheça as superfícies de inspeção no Agent Workspace.
Fontes verificadas em 8 de outubro de 2026: visão geral e guia de goals/rubrics oficiais. OAuth e o piloto de duas rodadas são métodos de avaliação construídos para o artigo, não medições comparativas executadas.