Apresentando Claude Haiku 5.5: mais capacidade e preço 90% menor para prompts curtos
Esforço ajustável e avanços em uso de computador ampliam as opções para tarefas frequentes.

A Anthropic lançou Claude Haiku 5.5 em 7 de outubro de 2026. A atualização melhora os resultados de uso de computador e raciocínio em relação ao Haiku 4.5, traz o primeiro controle ajustável de esforço da família e reduz em 90% os preços por token para prompts de até 100 mil tokens.
O foco continua em tarefas frequentes e sensíveis a custo: resumos, classificação, consultas a bancos de dados, compactação de contexto e subtarefas delimitadas. Para aplicações que chamam modelos repetidamente, a novidade permite reavaliar etapas antes caras demais ou pouco confiáveis com um modelo pequeno.
Onde a capacidade avançou
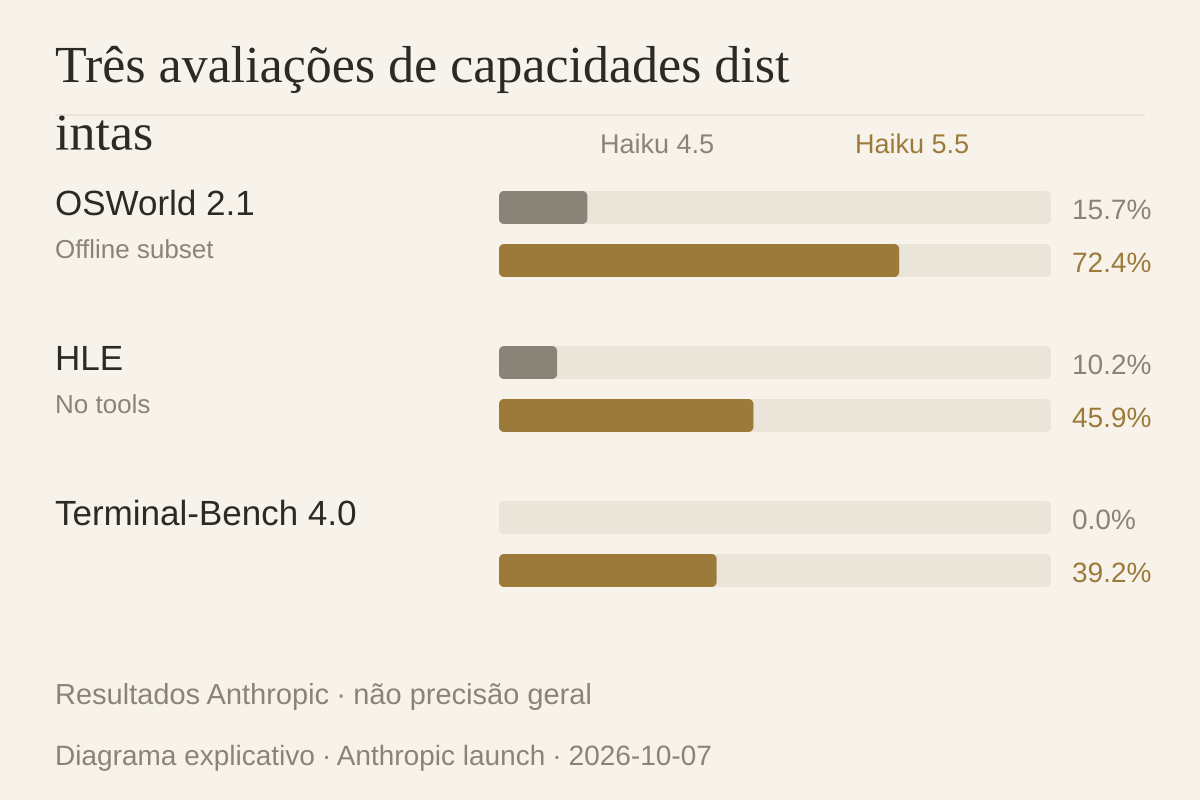
O anúncio apresenta avaliações de trabalho profissional, uso de computador, raciocínio, programação e interpretação de gráficos. Três resultados mostram a mudança desde o 4.5:
| Avaliação | Haiku 4.5 | Haiku 5.5 | O que mede |
|---|---|---|---|
| OSWorld 2.1, offline subset | 15.7% | 72.4% | Tarefas de computador com várias etapas |
| Humanity’s Last Exam, sem tools | 10.2% | 45.9% | Conhecimento especializado e raciocínio |
| Terminal-Bench 4.0 | 0.0% | 39.2% | Tarefas complexas no terminal |
São resultados publicados pela Anthropic, com métodos e configurações descritos no system card. Cada avaliação mede uma capacidade diferente, não uma precisão geral do modelo.
O avanço no uso de computador vem acompanhado de suporte beta a computer use e browser use nos SDKs Python e TypeScript. Tanto o modelo quanto os meios de integração avançam para aplicações que atuam em páginas e desktops. A aplicação ainda precisa administrar permissões, integração e verificação dos resultados.
Esforço ajustável chega à família Haiku
Haiku 5.5 é o primeiro modelo Haiku com esforço ajustável. O anúncio compara desempenho e custo nos níveis low, medium, high, xhigh e max.
Uma classificação simples não precisa do mesmo investimento de raciocínio que uma análise difícil. Também é possível testar mais esforço antes de transferir a tarefa para um modelo maior. A configuração útil depende de qualidade, latência e custo na aplicação real, não de um nível ideal para tudo.
A Anthropic descreve Haiku 5.5 como seu Claude mais rápido em velocidade padrão, excluindo Opus Fast Mode dessa comparação. Nos testes iniciais da Asana, a latência para concluir tarefas caiu mais de 30%, e a inferência por turno do agente ficou até 2,5 vezes mais rápida. Os números pertencem à suíte da Asana; não são uma promessa universal.
Uma etapa repetida, em vez do projeto inteiro
Os exemplos de clientes mostram uma divisão concreta do trabalho:
- AlphaSense: perguntas curtas sobre documentos. Ask in Document faz cerca de oito milhões de chamadas semanais em produção. Em 400 consultas, a empresa relatou resultado de 0,84 contra 0,76 do Haiku 4.5, segundo sua própria medida de avaliação.
- HubSpot: tarefas delimitadas no CRM. Em portais simulados de clientes, Haiku 5.5 obteve média de 92,8% em três execuções. Uma tarefa de auditoria busca registros antigos, mas ambíguos.
- Rogo: um subagente para consultas. Um modelo maior prepara a apresentação, enquanto Haiku encontra a linha de receita por segmento em um relatório 10-K.
São testes iniciais de clientes incluídos no anúncio da Anthropic. O ponto comum é separar uma etapa frequente, delimitada e verificável: classificar, extrair, resumir ou buscar uma informação.
Programação agentiva complexa continua sendo outra decisão. No mesmo Terminal-Bench 4.0, Sonnet 5.5 chega a 70,6%, contra 39,2% do Haiku. A Anthropic mantém Sonnet e Opus como escolhas para código complexo e Haiku para trabalhos mais estreitos.
Duas faixas de preço: redução de 90% ou 50%
Preços publicados da API Anthropic por milhão de tokens:
| Item | Haiku 4.5 | 5.5 prompt ≤100k | 5.5 prompt >100k |
|---|---|---|---|
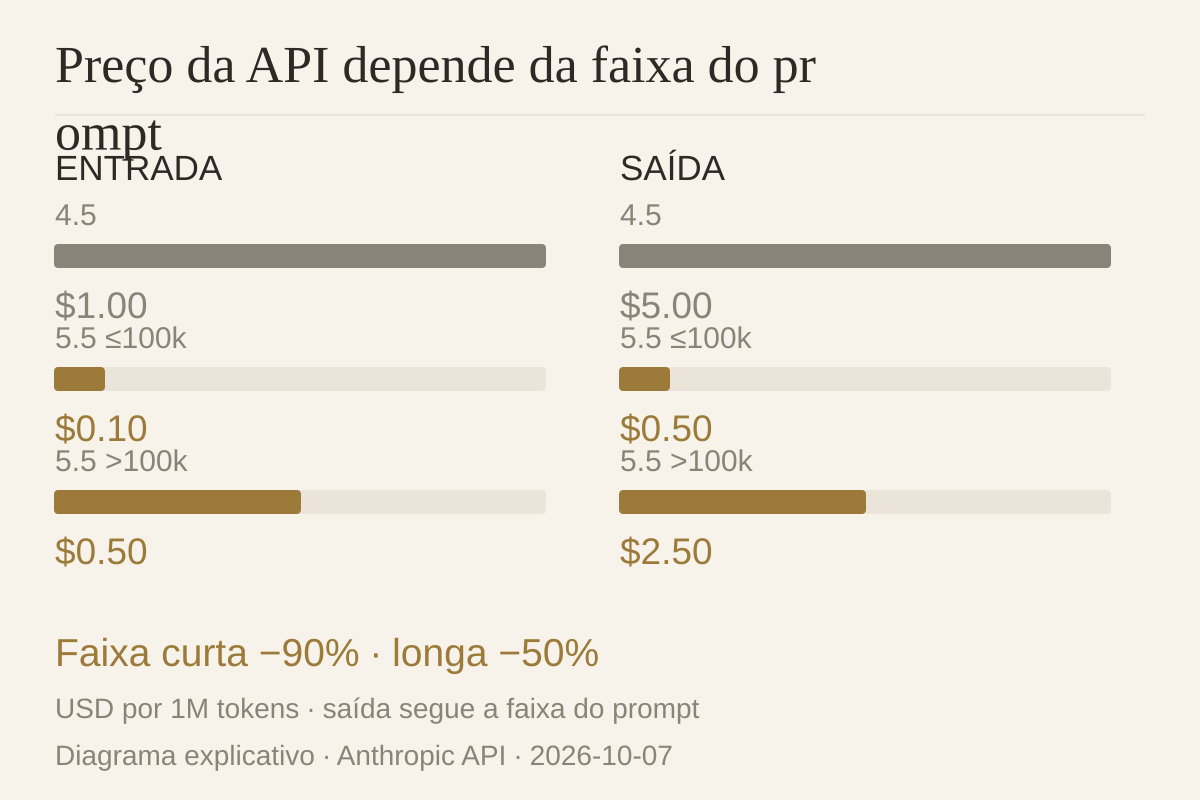
| Entrada | $1.00 | $0.10 | $0.50 |
| Saída | $5.00 | $0.50 | $2.50 |
| Cache read | $0.10 | $0.01 | $0.05 |
| Cache write | $1.25 | $0.125 | $0.625 |
As quatro tarifas da faixa curta caem 90%; na faixa longa, caem 50%. A tarifa de saída também acompanha a faixa do prompt da requisição. Portanto, $0.50 por milhão de tokens de saída não vale para todas as chamadas.
Segundo a Anthropic, cerca de 90% das chamadas ao Haiku anterior tinham até 100 mil tokens. Essa participação é um dado diferente da redução de preço de 90%, mas explica a importância da faixa curta.
Por que o custo médio por tarefa cai cerca de 75%?
Tokens mais baratos não significam o mesmo trabalho exatamente 90% mais barato. O guia oficial de migração informa que o novo tokenizer produz aproximadamente 30% mais tokens de entrada para o mesmo texto, variando conforme o conteúdo. Esforço, tamanho da saída e novas tentativas também alteram o consumo.
A estimativa da Anthropic de cerca de 75% menos custo médio considera mudanças na quantidade de tokens necessária para executar o trabalho. Compare o mesmo conjunto de tarefas por qualidade e custo total. Reconte com 5.5, especialmente perto da fronteira de 100 mil tokens.
Isso abre espaço para reconsiderar resumos, perguntas sobre documentos e chamadas de subagentes limitadas pelo custo. A expansão deve depender de resultados e contas medidos, não apenas da tabela de tarifas.
Disponibilidade e uma nota sobre atualização
A Anthropic anunciou disponibilidade no Claude Platform, AWS, Google Cloud e Microsoft Azure. Na Claude API, o ID fixo é claude-haiku-5-5.
Integrações existentes ainda exigem checagem de compatibilidade. O guia diz que Managed Agents requer apenas atualizar o nome do modelo; na Messages API há mudanças de thinking, parsing, parâmetros de amostragem, assistant prefill e ferramentas. Consulte o guia de migração antes de ampliar o tráfego.
A mudança principal é um modelo pequeno mais capaz e barato para trabalho frequente e delimitado. Identifique a etapa que realmente se repete e compare qualidade, latência e custo para decidir onde a atualização se encaixa.
Verificado em 9 de outubro de 2026. Avaliações, preços e testes iniciais de clientes são atribuídos ao anúncio da Anthropic; tokenizer e compatibilidade vêm do guia oficial. Não foram realizados testes independentes do modelo.