Por que Sonnet 5.5 pontuou menos em Max que em Xhigh — e como escolher o esforço
Inclua escopo, condições de parada e retrabalho na avaliação, não apenas profundidade de raciocínio.

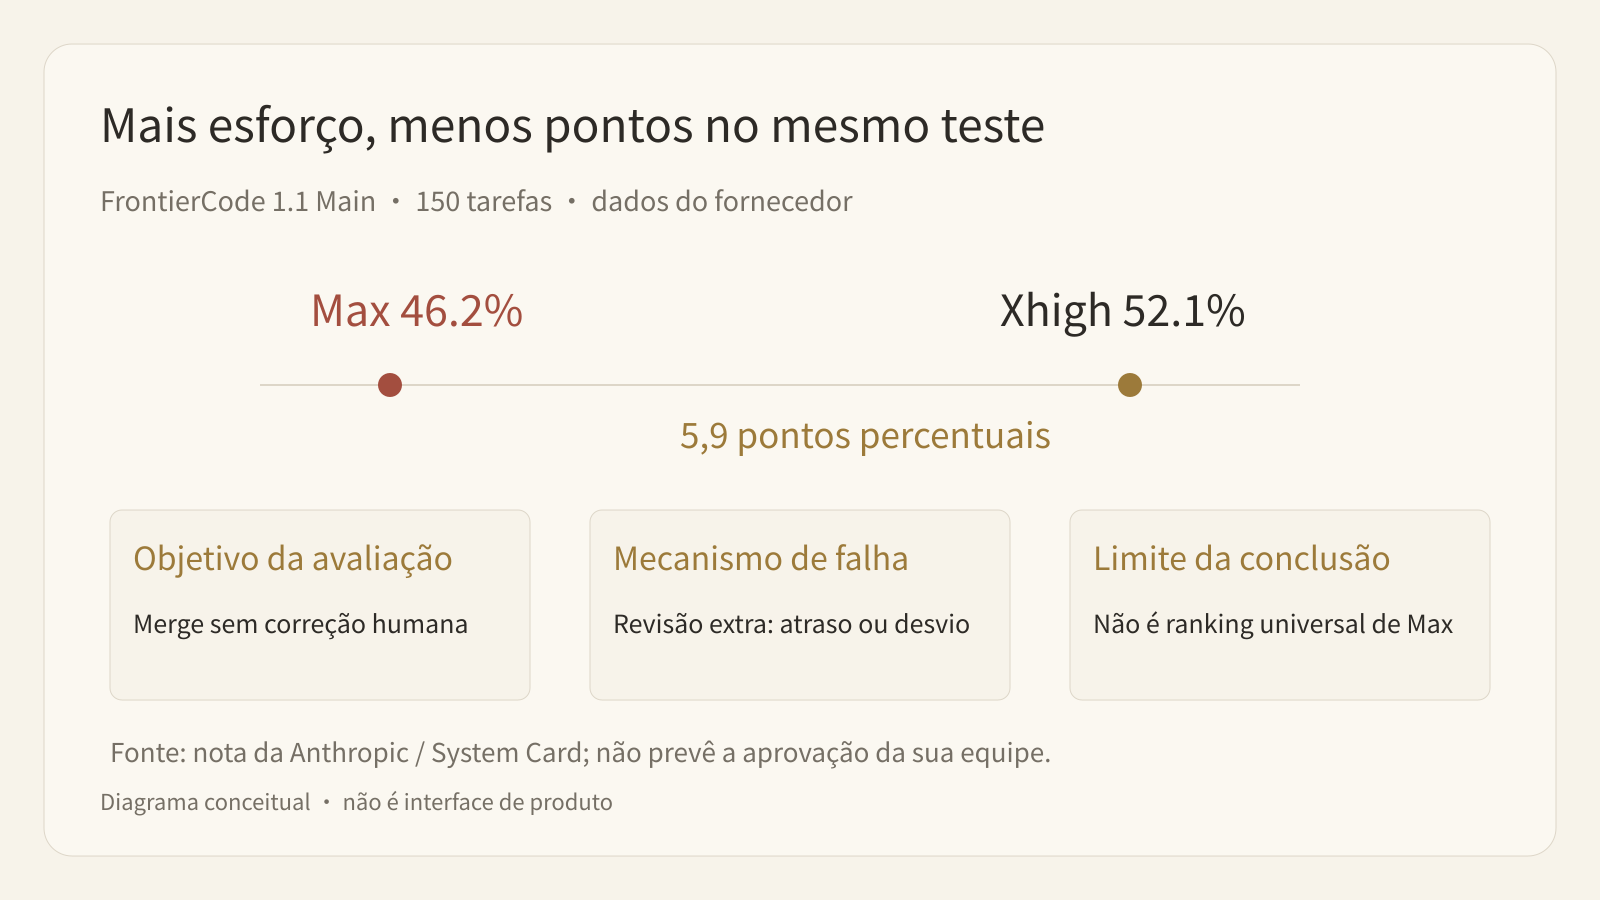
Nos resultados publicados pela Anthropic para FrontierCode 1.1 Main, Sonnet 5.5 marcou 52,1% em Xhigh e 46,2% em Max: diferença de 5,9 pontos percentuais na direção inesperada. A pergunta útil não é se Max é sempre pior, mas se o trabalho autônomo extra respeita o contrato da entrega.
O que essa avaliação aceita
O System Card descreve 150 tarefas de engenharia de software da Cognition, derivadas de pull requests reais de projetos abertos. O agente recebe repositório, problema e regras do projeto, trabalhando sem intervenção humana. A nota combina condições funcionais obrigatórias e uma rubrica de qualidade de código.
O objetivo é um patch integrável sem edições humanas. Mudanças fora do escopo podem ser penalizadas mesmo quando úteis. A nota de rodapé do lançamento explica que Max acionou com mais frequência a skill de code review do Claude Code com vários subagentes. Em dois casos examinados pela Cognition, isso provocou timeout ou edições extras.
É um mecanismo de falha nesse ambiente, não uma classificação universal de esforço nem uma previsão da taxa de aceite da sua equipe.
Esforço também muda a execução
O guia oficial observa que níveis menores podem parar para consultar o usuário antes de concluir uma tarefa longa; Low pode deixar de fazer verificações reais. Níveis maiores podem iniciar revisões adicionais, documentação ou mudanças relacionadas.
Um extremo devolve trabalho incompleto; o outro amplia a missão sem autorização. Velocidade não distingue eficiência de verificações omitidas. Mais tokens não distinguem diligência necessária de expansão indesejada.
Defina três partes antes de testar: artefatos obrigatórios, verificações obrigatórias e limite para parar ou perguntar. Uma correção pode exigir patch direcionado e teste do comportamento, proibindo refatorações sem relação. Avalie as três partes.
Escolha um ponto inicial por tarefa
Os níveis foram recalibrados: o mesmo nome não significa o mesmo orçamento do Sonnet 5. A Anthropic recomenda High para uso geral da Claude API, Medium para tarefas bem especificadas de agentes e ferramentas, High para tarefas mais difíceis ou longas, e Medium ou Low para conversa sensível à latência.
Reserve Xhigh e Max para ganhos de qualidade medidos. Ambos exigem adaptive thinking e não aceitam between_tools. São recomendações do provedor, não afirmações sobre controles ou padrões do seletor da Buda.
Mantenha uma tabela de tipo de trabalho, nível inicial e aceite em vez de usar Max em tudo. Pesquisa para orçamento, patch de código e resposta interativa têm custos de falha distintos.
Escreva a condição de parada
Um exemplo:
Conclua a mudança solicitada e execute uma verificação real do comportamento. Quando as verificações obrigatórias passarem, pare e reporte. Não inicie subagentes revisores, amplie funcionalidades ou altere arquivos sem relação, salvo solicitação. Sugira revisão adicional separadamente. Se uma verificação não puder rodar, informe qual e por quê; não declare conclusão verificada.
Isso não proíbe testes necessários: separa verificação obrigatória de expansão opcional. Em tarefas de alto risco, revisão independente pode ser requisito explícito.
A Anthropic relata um teste de programação em Max no qual uma instrução de limite de escopo impediu subagentes revisores e reduziu o custo da sessão em cerca de um terço, sem mudar a qualidade. É um experimento do fornecedor, não desconto universal ou medição da Buda. Reutilize o método controlado, não a promessa de economia.
Registre cinco resultados comparáveis
Fixe entradas, permissões, instruções, prazo e critérios. Avalie tarefas representativas em dois ou três níveis próximos, começando do mesmo estado para evitar que arquivos de uma tentativa contaminem outra.
Registre aceite, violações de escopo, tempo total, consumo e retrabalho humano. Falha barata não é entrega barata; artefato aprovado com escrita não autorizada não é sucesso irrestrito.
Na mesma unidade de cobrança, custo total das tentativas dividido por tarefas aceitas resume custo de execução. Sem nenhum aceite, não há estimativa finita de custo por sucesso. Mantenha tempo humano separado; não some dólares, Credits e minutos sem uma conversão definida.
O guia também diz que alterar esforço no nível superior invalida prompt cache. A função beta por mensagem preserva cache com adaptive. Registre essa política para não atribuir ao esforço uma diferença de cache.
Uma tentativa barata pode resultar em uma entrega cara
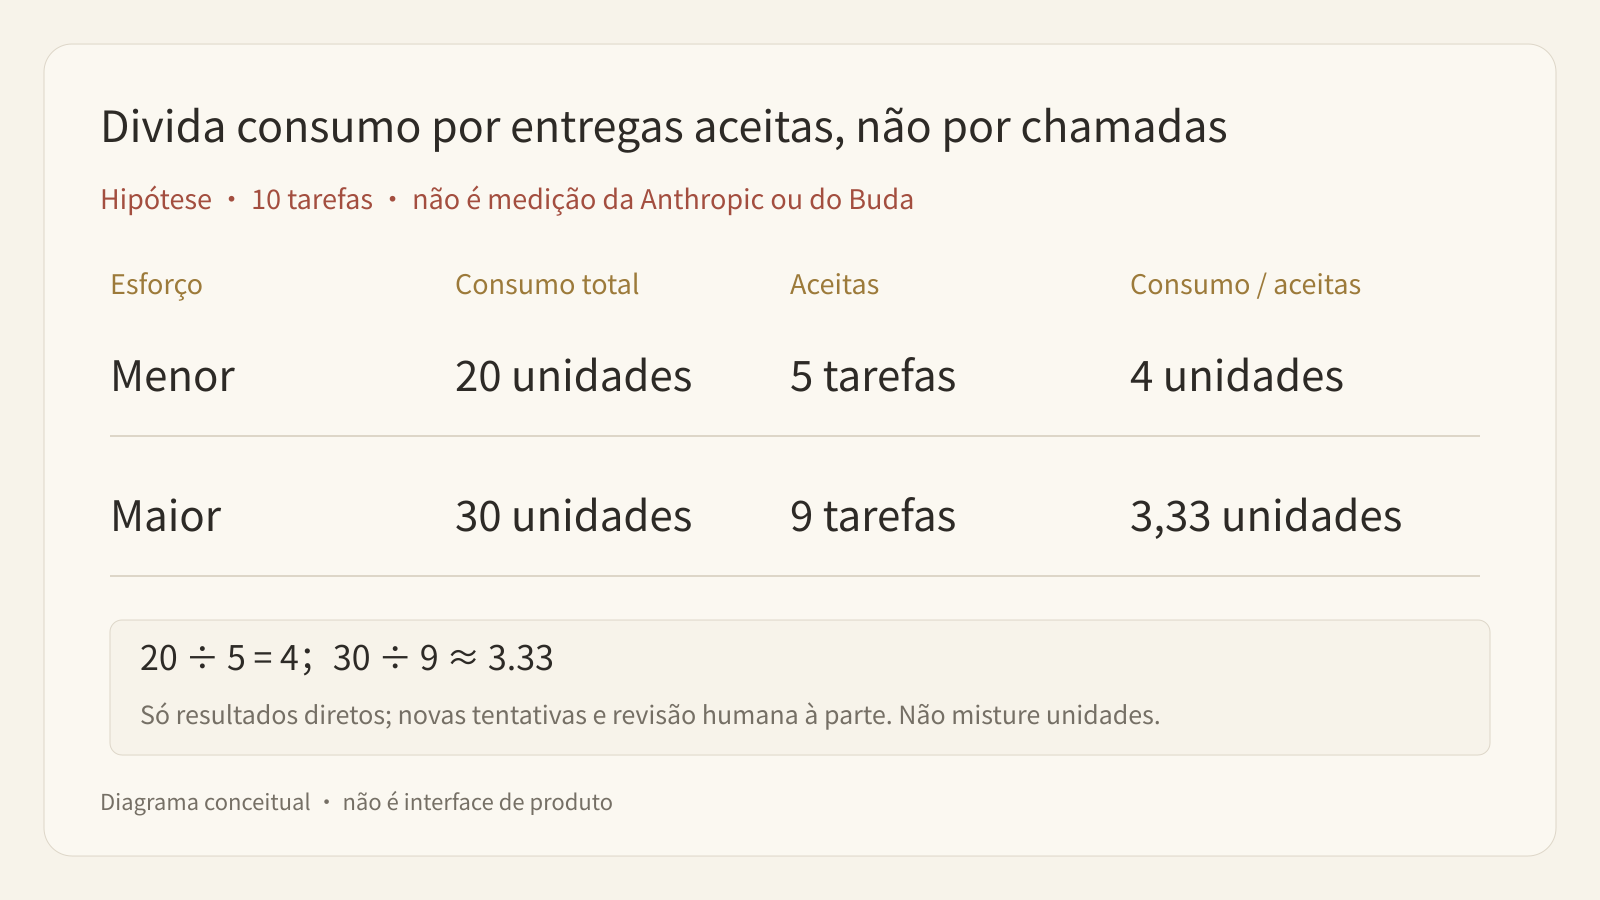
Os números a seguir são hipotéticos, não medições da Anthropic ou do Buda. Execute as mesmas dez tarefas independentes uma vez em cada um de dois níveis, mantendo entradas, ferramentas e critérios de aceitação.
| Experimento | Esforço menor | Esforço maior |
|---|---|---|
| Consumo de todas as tentativas | 20 unidades | 30 unidades |
| Aceitas sem retrabalho nem desvio de escopo | 5 | 9 |
| Consumo médio por tentativa | 2 unidades | 3 unidades |
| Consumo por entrega aceita diretamente | 4 unidades | Cerca de 3,33 unidades |
O nível menor consome um terço menos por tentativa, mas produz bem menos entregas utilizáveis. A razão é consumo do lote dividido pelos resultados diretamente aceitos, não custo das novas tentativas nem orçamento final para entregar as dez tarefas. Para isso, registre tentativas posteriores e correções humanas.
O nível maior também pode perder ao ampliar o escopo: depois dos testes obrigatórios, altera módulos compartilhados, reescreve documentação ou inicia outras revisões. Aumenta consumo e risco. Corrija permissões, escopo e parada antes de chamar todo trabalho extra de cuidado — ou reduzir o nível indiscriminadamente.
Classifique a falha para decidir o próximo teste
- Entrada incompleta: faltava a especificação correta ou o período. Forneça material; maior esforço não garante um fato desconhecido.
- Validação ausente: houve mudança de código sem os testes exigidos. Defina disponibilidade de ferramentas e conclusão antes de comparar níveis.
- Raciocínio insuficiente: entradas e testes estavam disponíveis, mas uma restrição importante foi ignorada. Experimente subir o nível com os mesmos critérios.
- Ação fora do escopo: arquivos, campos ou regras não relacionados foram alterados. Restrinja autorização; mais mudanças não significam mais qualidade.
- Escalonamento precoce: uma tarefa longa parou para perguntar. Diferencie um limite legítimo de autorização de trabalho claramente autorizado ainda incompleto; só o segundo é falha de conclusão.
A média pode esconder uma exceção crítica. Nove resumos corretos não compensam um contrato que omite uma cláusula de responsabilidade. Entregas de alto risco podem exigir revisão humana independente, mesmo com boa aprovação agregada.
Transforme a calibração em uma regra condicional
Uma regra reutilizável pode começar em Medium para organização com entradas completas, ferramentas somente de leitura e entregas explícitas; parar se faltar um campo crítico; entregar após conferir fontes e campos; e escalar segundo uma regra acordada quando tentativas repetidas falharem. É uma proposta de processo, não garantia de capacidade.
Ao mudar nível, prompt ou permissões, repita amostras de regressão preservadas. Registre ID do modelo, plataforma, nível, versões de prompt/ferramenta, sessão nova ou existente e cache. Condições não comparáveis servem para descobrir problemas, não para anunciar percentuais precisos de economia.
Separe os contextos de padrão: Claude Platform/API não é o mesmo que o aplicativo Claude ou Claude Code. High aqui se refere à documentação da API, não a todos os clientes nem a um controle oferecido pelo Buda. Registre a configuração real em vez de supor o padrão.
Prefira o menor nível suficiente
Use o menor nível que passa de forma estável e eleve quando a falha for de raciocínio. Evidência ausente pede melhores entradas; falta de permissão pede autorização; parada precoce pede um contrato mais claro.
A Buda pode organizar contexto de execução e fluxos reutilizáveis. Preserve requisitos, limites de ferramentas e aceite no processo, em vez de pedir mais cuidado a cada conversa. Isso é desenho de trabalho, não reprodução do benchmark nem promessa de controles específicos de esforço.
FAQ
Devo desativar Max?
Não. Meça seu benefício em tarefas complexas no seu ambiente.
52,1% prevê minha taxa de sucesso?
Não. É um resultado de uma avaliação específica de código.
Menos esforço sempre custa menos?
Uma tentativa pode ser barata, mas repetição e retrabalho podem inverter o resultado.
Limitar revisão extra elimina testes?
Não, se o contrato exigir os testes necessários antes de parar e separar revisão adicional.