Continuação no Gemini 4 Argon: por que pedir “continue” não retoma a geração
Preserve a requisição original e controle a contabilização e o orçamento de saídas longas.

O harness recebe finish_reason=CONTINUATION, mas o texto visível está vazio. Marca falha, envia “continue” e obtém outra trajetória. Confundiu uma geração em andamento com uma nova conversa.
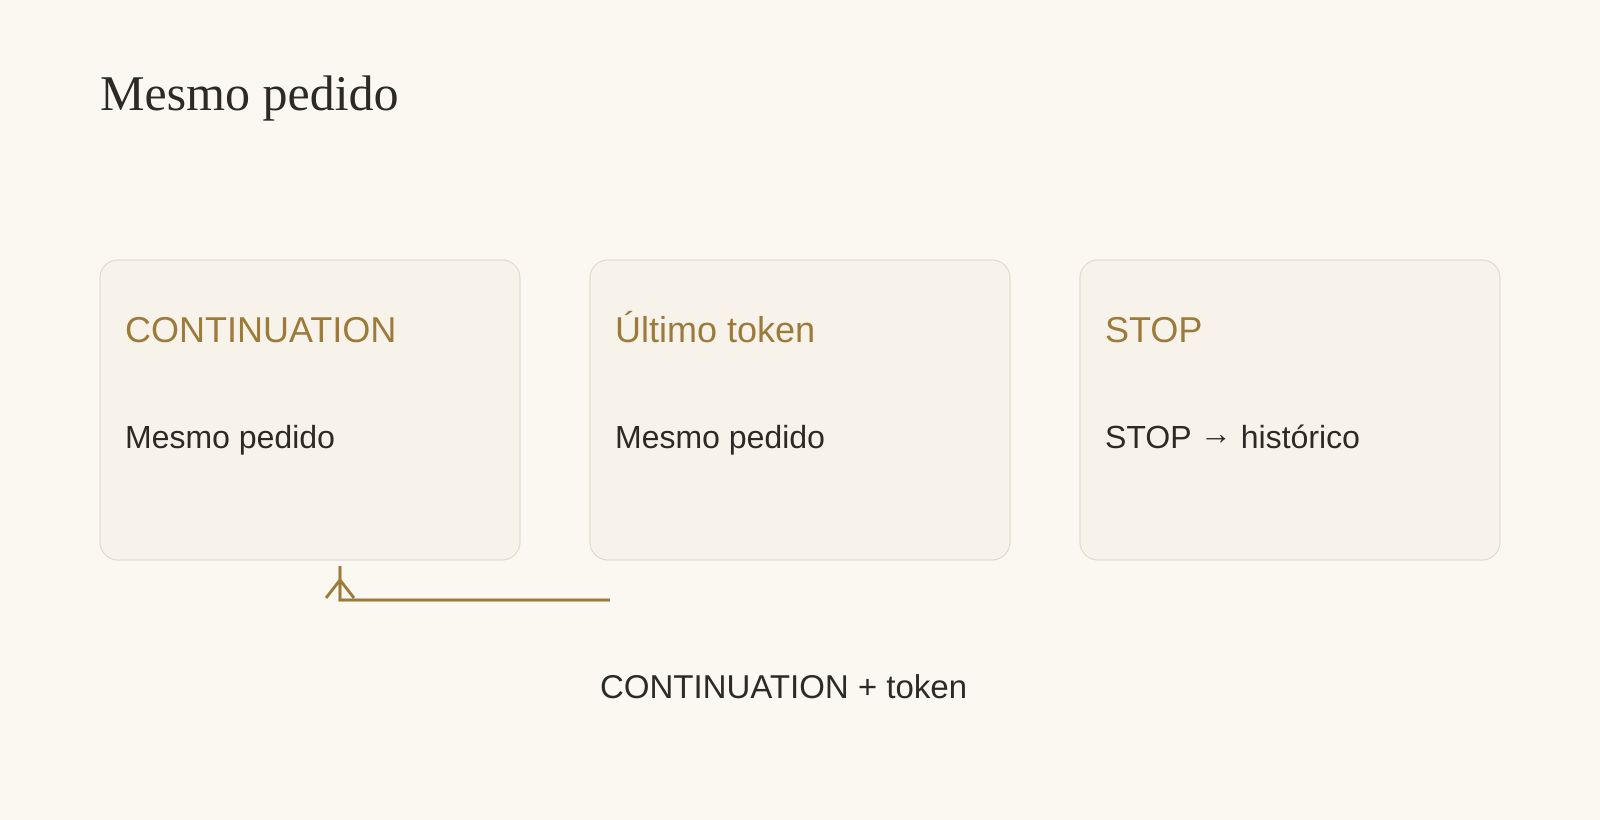
O long decode do Gemini 4 Argon retoma o estado usando um token. Um cliente próprio reenvia a requisição original com o token mais recente. Um Google Gen AI SDK compatível pode administrar essa sequência.
Um limite compartilhado, vários pedidos
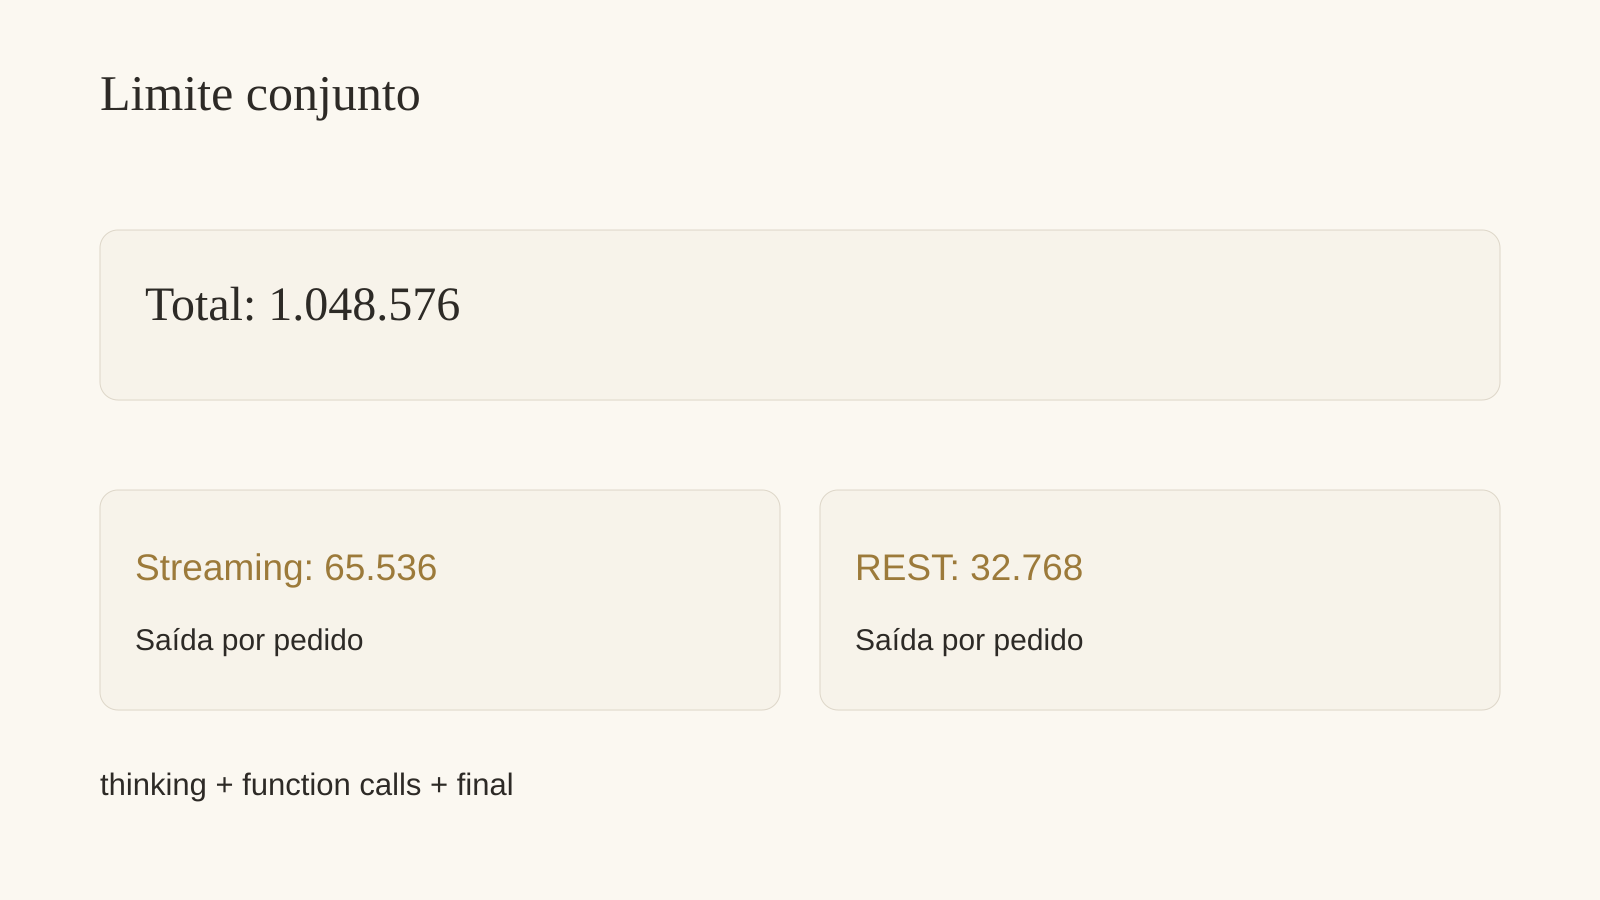
O guia de desenvolvimento define 1.048.576 tokens para entrada e saída juntas. A saída inclui pensamento, chamadas de função e resposta final. Não são dois milhões separados.
Cada segmento de streaming produz até65.536 tokens; HTTP direto sem streaming,32.768. Long decode divide uma geração em requisições, sem eliminar o limite total e o teto solicitado. Uma entrada hipotética de200.000 deixa848.576 como teto aritmético de saída, não como previsão de comprimento.
O anúncio de13 de outubro contextualiza o lançamento. Na migração do cliente, confira regras e campos atuais, não apenas avaliações de capacidade.
Defina quem controla a continuação
Python google-genai>=2.30.1 e JavaScript @google/genai>=2.29.1 suportam continuação automática. Configure um teto de saída adequado e leia a contagem final.
REST próprio usa v1beta1 em streamGenerateContent ou generateContent. Long decode atualmente não funciona em v1 nem na Interactions API. O SDK usa v1beta1 por padrão, salvo substituição explícita. SDKs antigos e a camada de compatibilidade OpenAI não recuperam essas conclusões longas com tokens.
Para long decode, configure max_output_tokens acima de65.536 no streaming ou32.768 sem streaming. Chat de baixa latência, extração e vários turnos curtos de ferramentas geralmente não precisam dele. Não escolha o máximo automaticamente.
Reenvie os mesmos dados
Congele contents, system_instruction, tools e configurações antes do primeiro pedido. Reenvie-os com o último token, sem acrescentar texto parcial, trocar a tarefa ou pedir “continue”. O token contém estado da geração e hash do prompt original.
Este pseudocódigo descreve controle, não um cliente testado; implemente leitura de campos conforme a interface real.
original = immutable_copy(authorized_request)
latest_token = absent
for segment in bounded_segment_count:
    response = call_v1beta1(original, latest_token)
    save_redacted_segment_metadata(response)
    accumulate_parts(response)
    if finish_reason == STOP: finish_one_model_turn()
    elif finish_reason == CONTINUATION and token_exists:
        check_time_and_total_budget()
        latest_token = response_token
    else: stop_for_explicit_handling()
Um segmento só de pensamento pode retornar parts: [{"text": ""}]. CONTINUATION com token permite continuar mesmo sem texto visível. Token ausente ou motivo inesperado exige tratamento, não repetição cega.
MAX_TOKENS com token indica que o teto solicitado foi atingido. O guia permite aumentá-lo, mas isso deve ser uma decisão autorizada de orçamento. Registre truncamento antes de ampliar. Só após STOP combine partes em um único turno do modelo para o histórico.
Não some totais acumulados duas vezes
No Python SDK, o usage_metadata da resposta ou chunk final acumula tokens faturados de todas as requisições de continuação. Não some novamente cada total cumulativo.
No REST próprio, os contadores acumulam dentro de cada requisição. Some os valores finais de prompt, contexto em cache, candidatos e pensamento de cada pedido, não cada atualização de streaming.
A continuação refaz o prefill de resultados parciais. Por isso prompt_token_count cresce cumulativamente. Use initial_prompt_token_count para medir a entrada original e espere o fim sem token para compactar. Alterar histórico no meio quebra o contrato.
Cache implícito elegível oferece95% de desconto sobre contexto em cache, mínimo6.144 tokens e TTL documentado de15–20 minutos. Não significa95% de desconto na tarefa inteira. Saída, pensamento e demais custos permanecem; condições de cache podem falhar. Cache explícito não é suportado.
Remova parâmetros antigos
LOW, MEDIUM e HIGH são níveis válidos. Argon comum usa MEDIUM por padrão; cyber-permissive usa HIGH. thinking_budget, MINIMAL, frequency_penalty, presence_penalty e candidate_count retornam400. temperature, top_k e top_p personalizados são ignorados.
Respostas de função correspondem ao ID, nome e ordem da chamada anterior. Separe repetição de geração e efeitos das ferramentas: queda de stream não autoriza repetir pagamento, envio ou escrita no banco.
Verifique antes de ampliar
Casos sugeridos: STOP curto, continuação só de pensamento, segmentos com entrada invariável, teto esgotado, versão incompatível e falha após efeito externo. Confira fingerprint, término, contagem e registro de efeitos. Não são resultados de testes reais desta execução.
Guarde checklist e rastros redigidos em Drive. O Workspace reúne documentos e código autorizado; verifique o protocolo no cliente real, não suponha suporte pelo seletor de modelo.
Quando dispensar long decode?
Resumos, classificação e turnos curtos que cabem num segmento. Entradas maiores deixam menos orçamento total para saída.
Por que não pedir “continue”?
É outro pedido, não retomada do estado. Use token e requisição original; só depois do término incorpore a resposta ao histórico.
O que o painel de custos deve ler?
Total final acumulado do Python SDK ou soma dos totais finais de cada pedido REST. Registre método e IDs para evitar contagem dupla. Comece pequeno e prove retomada, parada e contabilidade antes de aumentar o teto.