GPT-6 Astra vs Claude Fable 5.1: qual serve melhor a Agents de longa duração?
Fable lidera o índice independente; Astra vence várias tarefas com ferramentas. A escolha depende do trabalho, harness, cache e revisão.

GPT-6 Astra vs Claude Fable 5.1: qual serve melhor a Agents de longa duração?
GPT-6 Astra e Claude Fable 5.1 têm especificações parecidas: cerca de um milhão de tokens de contexto, saída máxima de 128 mil tokens e preço Standard upstream de US$ 10 por milhão de tokens de entrada e US$ 50 por milhão de saída.
Isso não torna os dois intercambiáveis.
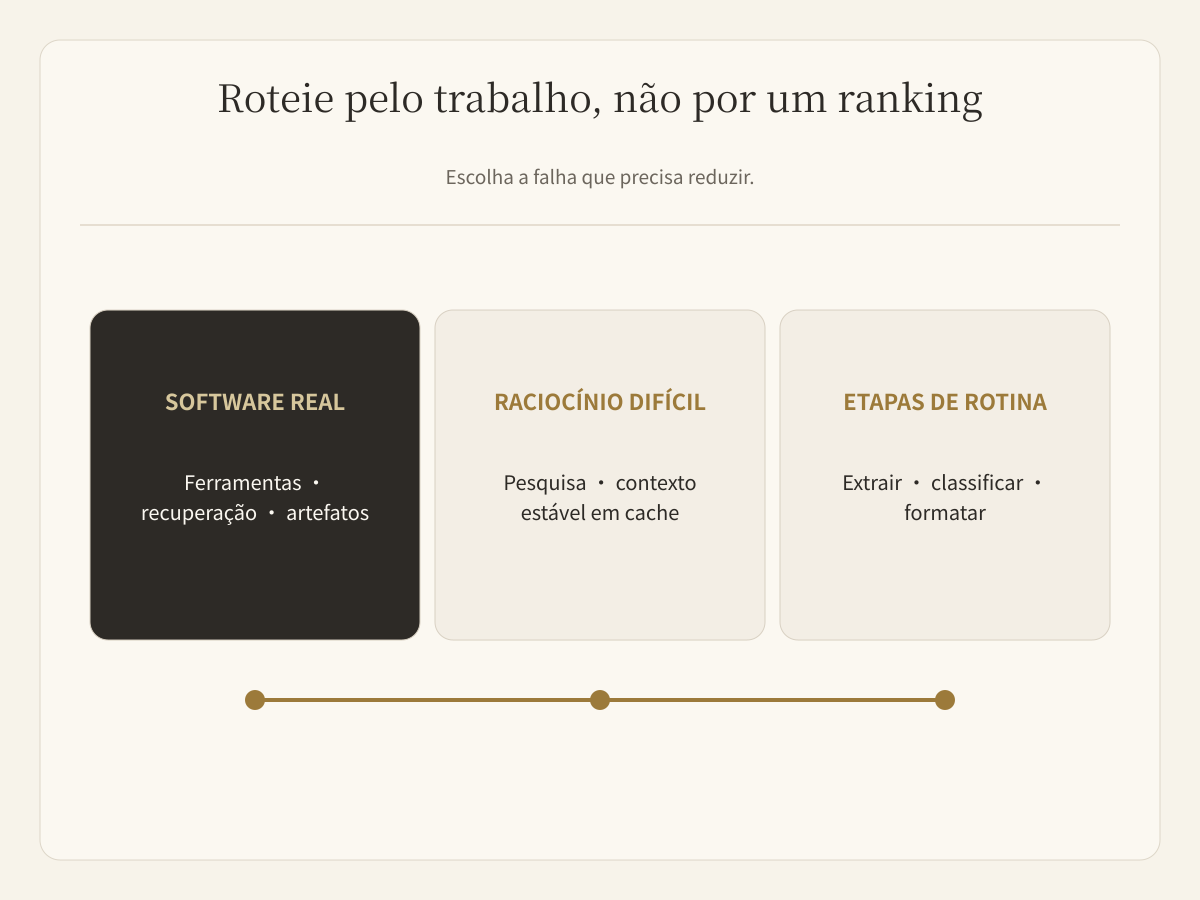
A resposta curta é: comece pelo Fable 5.1 em raciocínio difícil, pesquisa em várias etapas ou sessões que reutilizam um grande prefixo em cache. Teste Astra quando o Agent precisa operar software real, atravessar uma sequência longa de ferramentas, recuperar falhas e entregar artefatos prontos. A rota final deve vir de tarefas aceitas no seu ambiente, não de um único ranking.
O índice independente favorece Fable 5.1
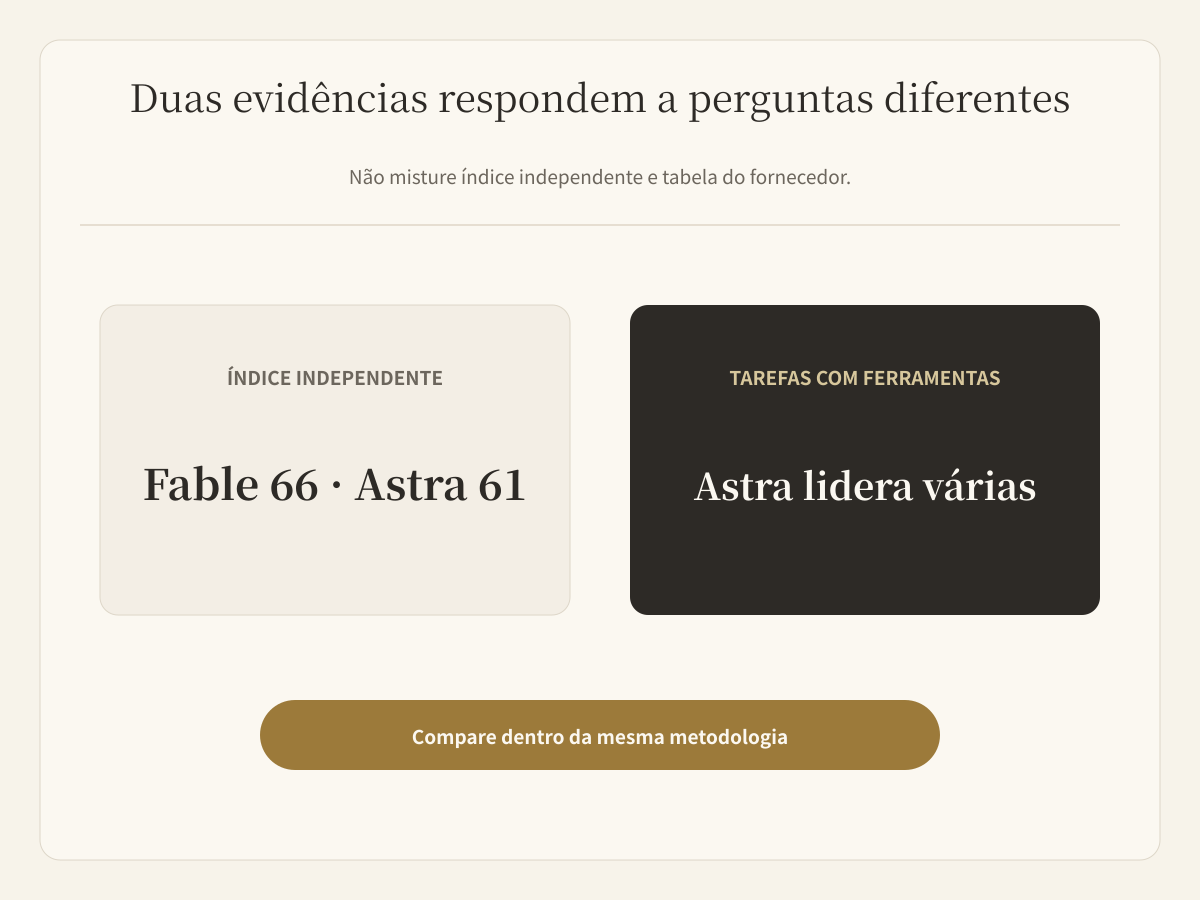
A Artificial Analysis atribui 66 ao Claude Fable 5.1 e 61 ao GPT-6 Astra no Intelligence Index, ambos em esforço máximo. No Coding Agent Index, Fable 5.1 marca 70 e Astra 67.
O sinal é útil porque os modelos passam pela mesma metodologia. Ainda assim, não prova que Fable vence toda tarefa. A configuração do Fable inclui esforço máximo e fallback padrão. No índice de coding, os ambientes também diferem: Claude Code e Codex. O resultado mede modelo mais harness, não apenas o modelo.
A própria avaliação do Astra é mista: ele usa muito menos tokens que GPT-5.6 Sol e fica na fronteira de custo para coding, mas o aumento de preço supera parte da eficiência em tarefas gerais de inteligência.
A tabela da OpenAI favorece Astra em tarefas com ferramentas
| Avaliação | GPT-6 Astra | Claude Fable 5.1 | Limite |
|---|---|---|---|
| Terminal-Bench 4.0 | 57,9% | 55,8% | Tabela da OpenAI; o Agent de terminal importa |
| AutomationBench | 41,4% | 31,4% | Execução em SaaS |
| BenchCAD | 95,9% | 84,3% | O resultado Claude usa alterações documentadas |
| Terminal-Bench Science | 64,6% | 52,6% | Fluxos científicos com ferramentas |
| Artificial Analysis Intelligence Index | 61,2 | 65,7 | Índice independente reproduzido pela OpenAI |
| Artificial Analysis Coding Agent Index | 67,0 | 67,2 | Praticamente empatados nesse retrato |
Não há contradição: Astra pode liderar operação de computador, terminal e alguns trabalhos profissionais, enquanto Fable lidera um agregado independente mais amplo.
Especificações parecidas, economia diferente
- Entrada em cache do Astra custa US$ 1/MTok; cache read do Fable 5.1 custa US$ 0,25/MTok.
- Acima de 272 mil tokens de entrada, Astra cobra 2x por entrada/cache e 1,5x por saída na solicitação inteira.
- Ambos oferecem 50% de desconto em Batch. Astra também oferece Flex a 50% e Fast a 2x.
- Fable 5.1 usa adaptive thinking sempre ativo e permite mudar effort durante a conversa.
- O fallback padrão do Fable 5.1 muda o sistema efetivamente medido.
- Ferramentas, tentativas, recusas, revisão e retrabalho podem pesar mais que o preço nominal.
Ter capacidade para um milhão de tokens não significa enviar um milhão em cada turno. Recuperação seletiva e cache continuam essenciais.
Escolha pela falha que precisa reduzir
Teste Astra primeiro quando houver navegador ou desktop, terminal + arquivos + Web + verificação, problemas de direção ou recuperação em tarefas longas, ou entrega de documentos, planilhas, slides e sites.
Teste Fable 5.1 primeiro quando predominar raciocínio difícil, pesquisa em várias etapas, reutilização de prefixo em cache, integração Claude que já preserva thinking blocks ou Claude Code como ambiente principal.
Mantenha um modelo econômico para extração, classificação, formatação e qualquer etapa em que um modelo menor já passe no critério de aceite.
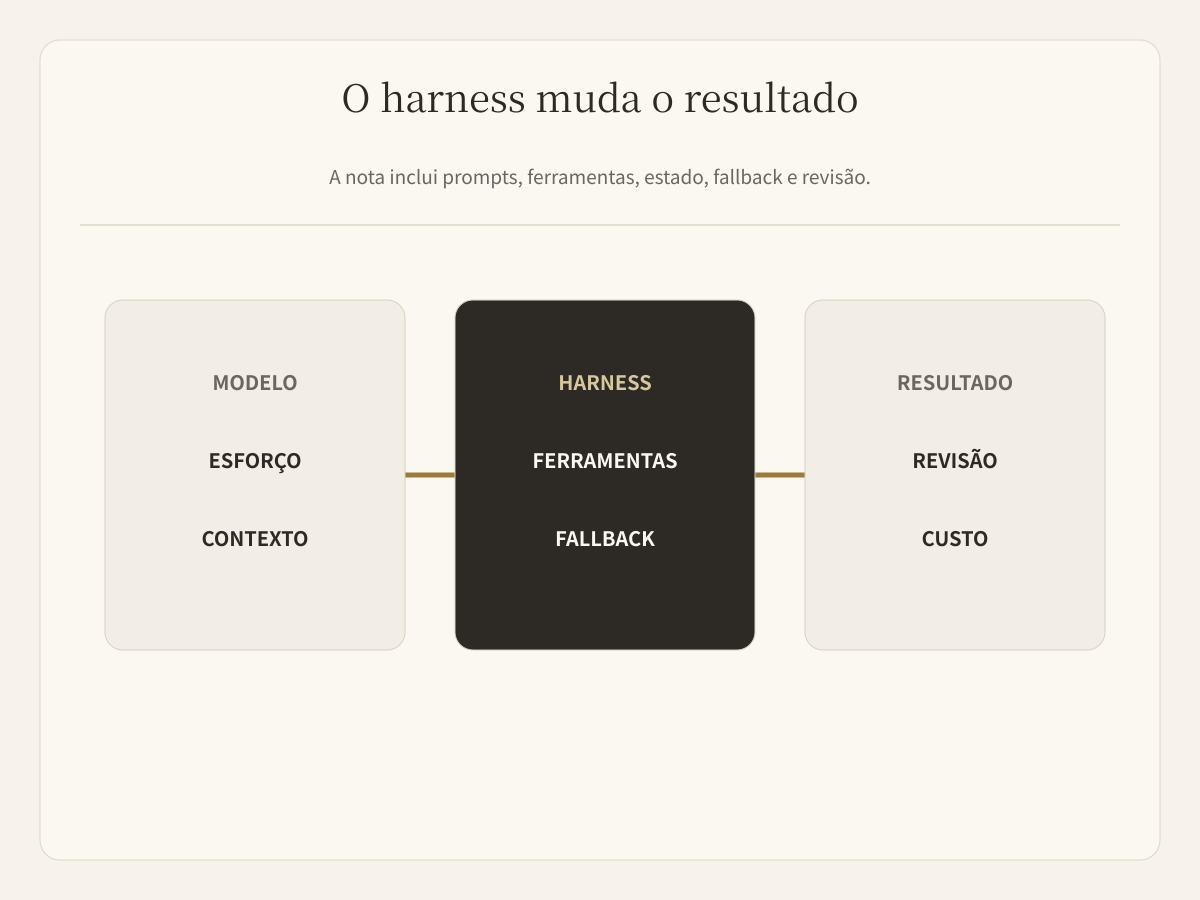
O harness pode inverter o resultado
Codex e Claude Code diferem em prompts, ferramentas, permissões, compactação, fallback, confirmação e persistência de estado. Parte da melhoria do Astra vem do Codex, inclusive a busca em janelas anteriores de contexto. Fable 5.1 tem regras próprias: não aceita tool choice forçado, modelos anteriores não leem seus thinking blocks e editar turnos anteriores pode invalidá-los.
Antes de trocar a produção, meça o mesmo conjunto de tarefas: aceite na primeira tentativa, recuperação de ferramentas, tempo, uso de input/cache/reasoning/output, correções humanas, origem da falha e custo total por tarefa aceita.
Não compare uma API isolada com um produto de Agent completo e chame isso de ranking de modelos.
O que isso significa no Buda
Um modelo de fronteira é apenas parte de um Agent Workspace. Arquivos persistentes, ferramentas reais, limites de acesso, execução visível e revisão humana continuam necessários.
GPT-6 Astra e Claude Fable 5.1 ainda não estão disponíveis no Buda. Quando forem lançados, a disponibilidade e os Credits aparecerão no seletor de modelos e na página pública de preços.
Leia também o guia de lançamento do GPT-6 Astra, como escolher um modelo para AI Agents e as mudanças do Claude Fable 5.1.
Perguntas frequentes
GPT-6 Astra é melhor que Claude Fable 5.1?
Não em toda carga. Fable 5.1 lidera o índice geral da Artificial Analysis; Astra lidera várias tarefas de computador, terminal, automação e ciência reportadas pelo fornecedor.
Qual é mais barato?
O preço Standard de entrada e saída é igual. Fable 5.1 tem cache read mais barato; Astra aplica acréscimo acima de 272 mil tokens de entrada. Compare a tarefa completa.
Qual tem mais contexto?
Astra lista 1,05 milhão; Fable 5.1 lista 1 milhão. Recuperação, cache e preservação de decisões pelo harness costumam importar mais.
Um benchmark pode definir o modelo padrão?
Não. Use avaliações públicas para selecionar candidatos e um conjunto interno estável para definir rotas.