GPT-6.1 Sol: Avalie o Trabalho Concluído, Não Só o Modelo
A OpenAI lançou uma versão mais capaz do Sol. O teste que importa é se ela entrega trabalho aceito, com custo e revisão adequados ao seu contexto.
O GPT-6.1 Sol é a atualização do Sol anunciada pela OpenAI em 29 de setembro de 2026. A empresa relata avanços em código, fluxos de várias etapas, uso do computador e documentos complexos. Antes de mudar o modelo padrão, escolha uma entrega que possa ser inspecionada.
O que mudou em relação ao GPT-6 Sol
Os números abaixo vêm de avaliações da OpenAI com configurações específicas. Servem para escolher tarefas de teste, não para prever a taxa de aprovação da sua equipe.
Programação de longo prazo
No DeepSWE v1.1, a OpenAI relata ganho de 6,4 pontos percentuais sobre a melhor pontuação do GPT-6 Sol. Teste em um repositório real com critérios de aceitação.
Fluxos com várias ferramentas
O AutomationBench sobe 4,8 pontos no mesmo esforço de raciocínio. Isso não prevê a taxa de sucesso nos seus aplicativos.
Uso do computador
No conjunto offline do OSWorld 2.0, a melhora relatada é de sete pontos no esforço máximo. Permissões de navegador e aplicativos exigem decisões próprias.
Leitura de documentos complexos
A OpenAI destaca PDFs profissionais com tabelas e gráficos. Peça páginas de origem, definições dos números e cálculo verificável.
Comece por uma tarefa com aprovação objetiva
Organize as tarefas por entregas verificáveis e decida com base nos resultados.
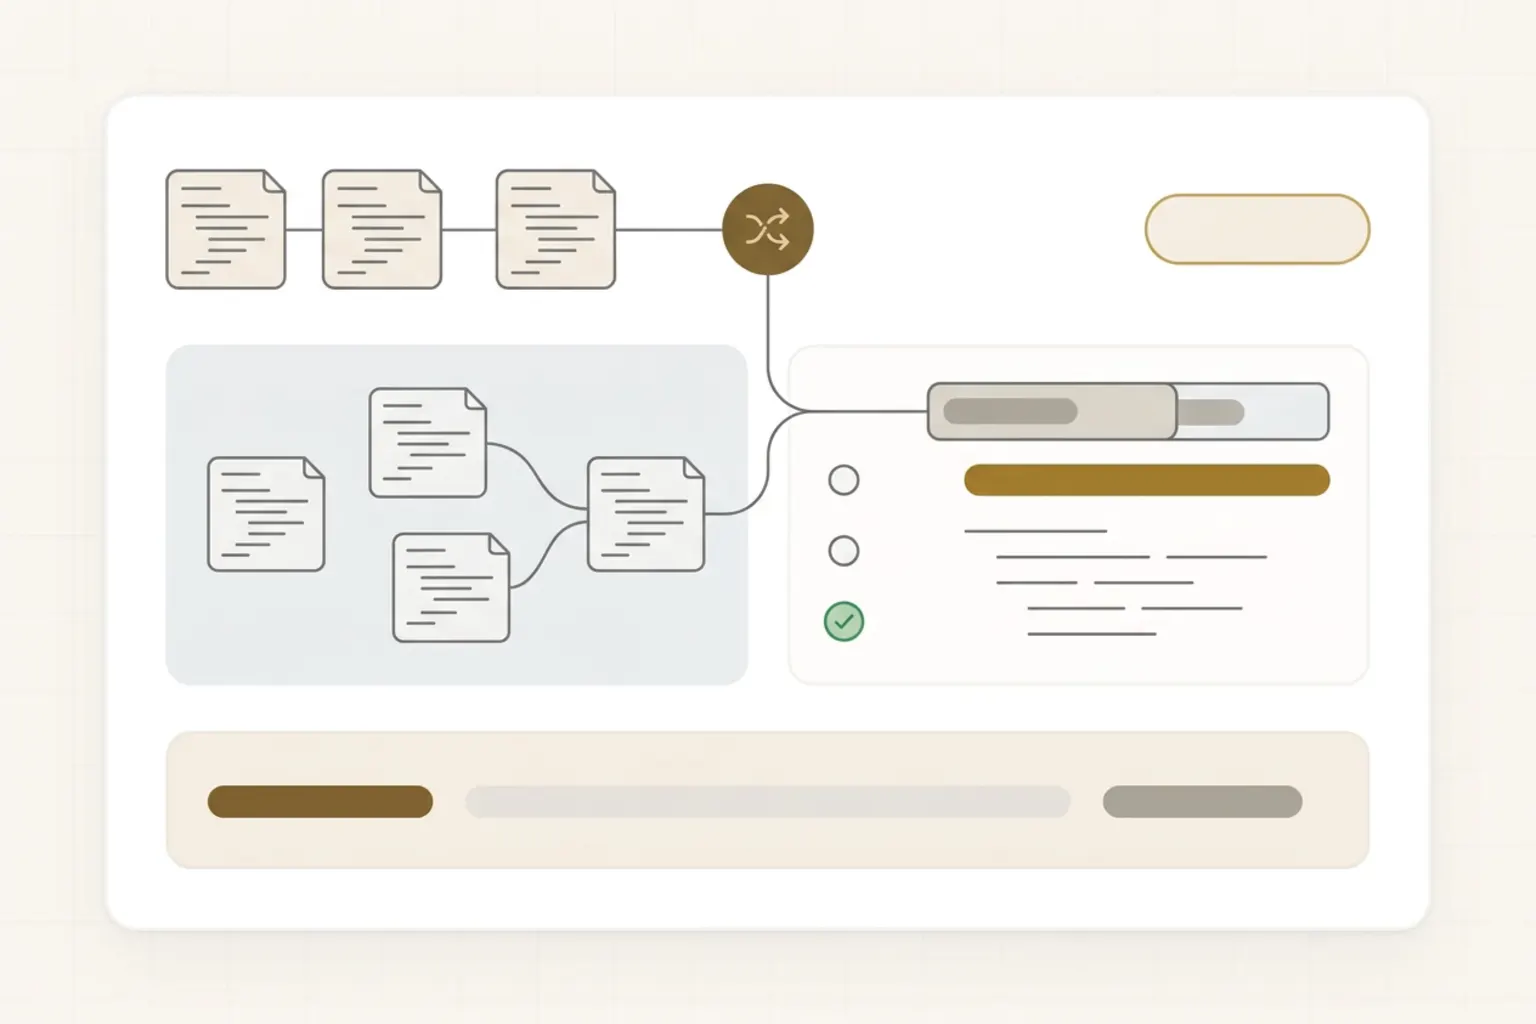
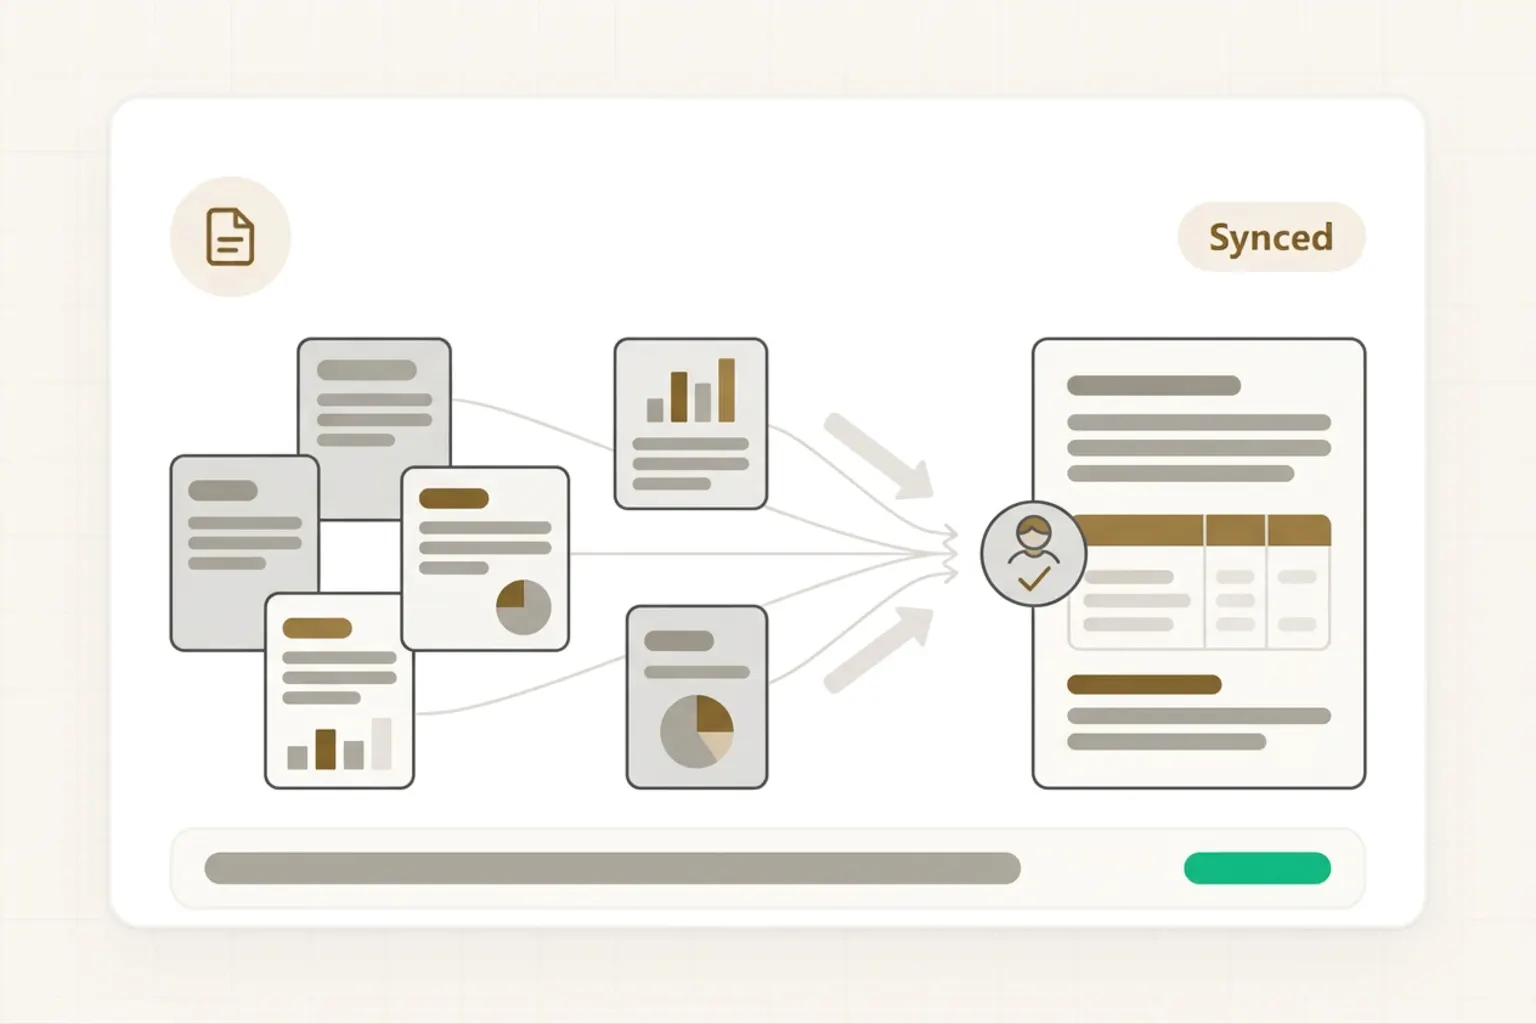
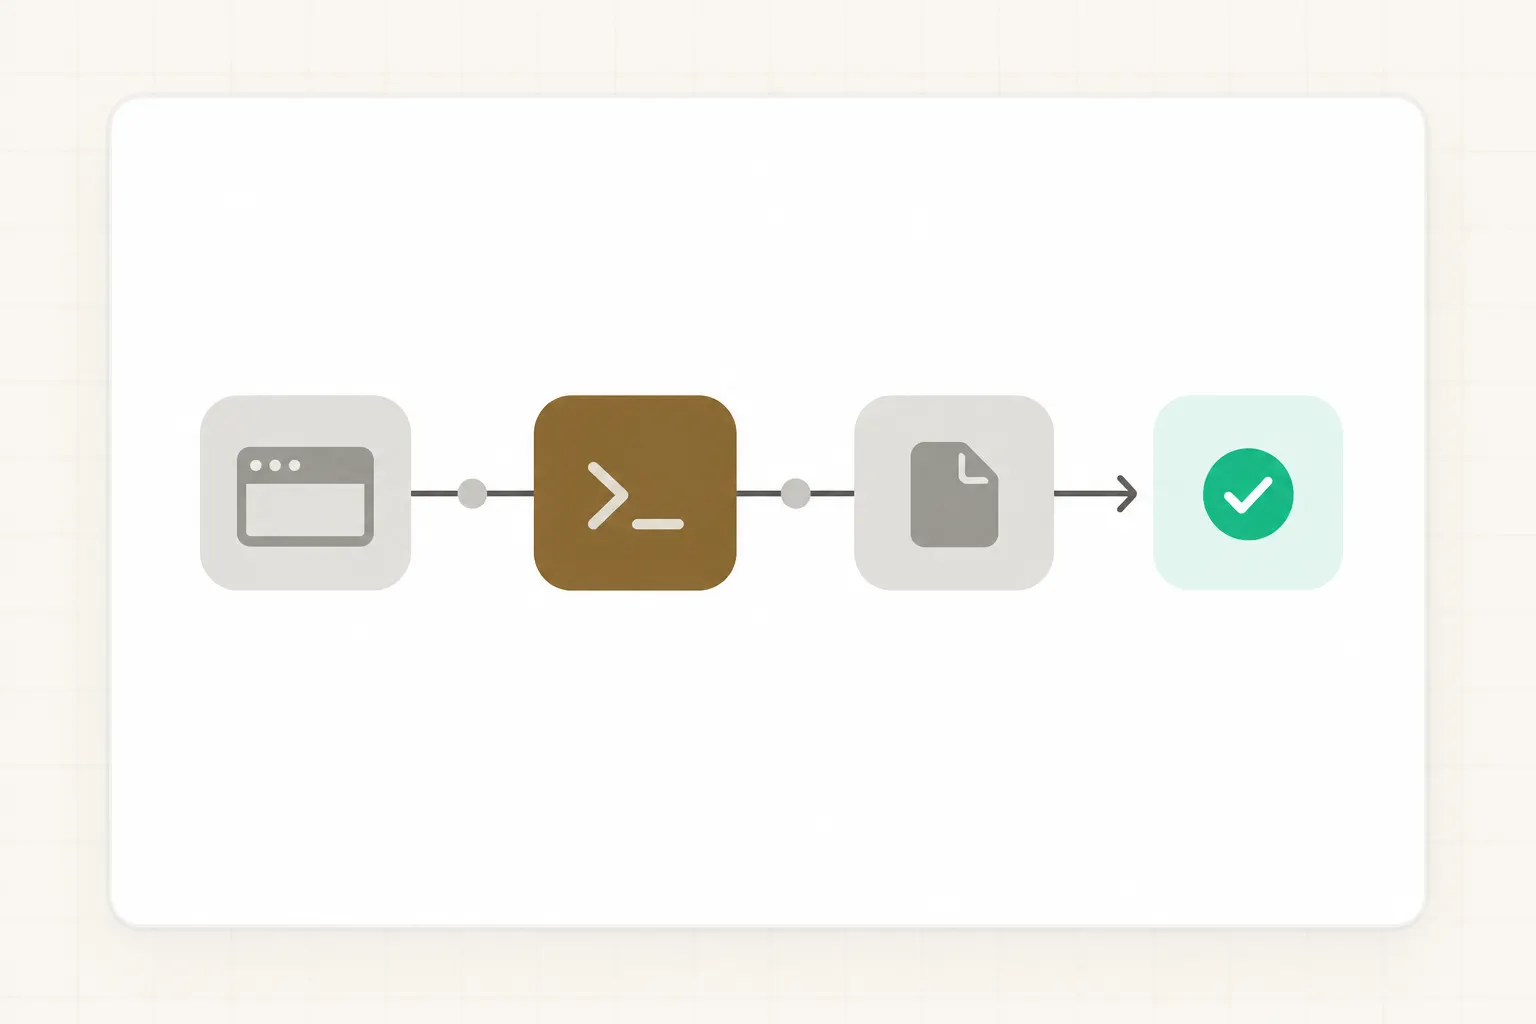
Exemplo completo: corrigir um teste que falha
Um desenho de tarefa para avaliação, não um teste do GPT-6.1 Sol executado no Buda.
1 · Prepare as entradas
Anexe um snapshot do repositório, um teste reproduzível que falha e o relato do bug. Delimite o módulo permitido e os arquivos que não devem ser alterados.
2 · Defina o resultado
Exija a reprodução da falha, um patch focado, a execução dos testes e um resumo dos arquivos alterados, resultados e comportamentos não verificados.
3 · Revise os artefatos
Confira o diff e o log no mesmo contexto; repita as verificações críticas. Alterações de esquema, segredos ou deploy exigem autorização separada.
Compare tarefas reais, não um ranking universal
| Tarefa | GPT-6.1 Sol | GPT-6 Astra | Revisão humana |
|---|---|---|---|
| Código com teste que falha | Teste a melhora sugerida pelo DeepSWE no seu repositório | Compare com as mesmas restrições e testes | Inspecione diff e resultados |
| Fluxo com várias ferramentas | Teste o avanço do AutomationBench em ambiente isolado | Compare com as mesmas ferramentas e critérios | Verifique fontes e trilha de execução |
| Decisão aberta de alto risco | Se necessário, limite a tarefas de investigação | Avalie separadamente em casos representativos | Responsável decide |
Avalie cinco tarefas reais
Fixe entradas, ferramentas e critérios iguais entre modelos.
Escolha cinco tarefas: uma fácil, duas típicas e duas de fronteira.
Registre entrega aceita, tempo até aceitação, correções e falhas de ferramentas.
Repita falhas e confira os artefatos antes de mudar o fluxo padrão.
Mantenha o trabalho inspecionável
Drive
Guarde o repositório, o pedido, os testes e os arquivos finais juntos.
Sessão do Agent
Inspecione comandos e artefatos intermediários, não só o texto final.
Decisão humana
Aceite o patch após testes; autorize merge, deploy e mudanças externas separadamente.
Perguntas frequentes
O GPT-6.1 Sol já está disponível no Buda?
A OpenAI anunciou acesso via API, ChatGPT Work e Codex. A disponibilidade no Buda ainda não foi verificada; confira o seletor de modelos antes de planejar o fluxo.
O que mudou em relação ao GPT-6 Sol?
A OpenAI relata melhorias em programação agêntica, fluxos profissionais de várias etapas e uso do computador. São avaliações específicas; confirme o resultado com tarefas da sua equipe.
Onde a OpenAI disponibilizou o GPT-6.1 Sol?
A OpenAI lista a API com o identificador gpt-6.1-sol e o acesso no ChatGPT Work e Codex para planos elegíveis. No lançamento, o modelo ainda não está disponível no Chat comum.
O ganho no benchmark se repetirá no meu fluxo?
Não necessariamente. Os testes têm configurações específicas; avalie tarefas representativas da sua equipe.
Qual tarefa devo testar primeiro?
Escolha uma tarefa delimitada, com arquivos de origem e critérios objetivos, como corrigir um bug reproduzível. Peça diff, log de testes e itens não verificados.
Quando considerar o GPT-6 Astra?
Em tarefas abertas, difíceis ou de maior risco, inclua o Astra numa comparação com as mesmas condições. A tabela não representa roteamento automático nem garante um vencedor universal.
Como comparar dois modelos de forma justa?
Use as mesmas entradas, ferramentas permitidas e critérios de aceitação. Compare entregas aceitas e correções humanas em tarefas reais, não apenas a pontuação de benchmarks.
Posso dispensar revisão humana?
Não. Mudanças em produção, mensagens a clientes e publicações externas ainda precisam de autorização humana.
Comece por uma entrega que possa ser conferida.
Defina fontes, escopo e critérios de aceitação. Mantenha a execução visível e a decisão final com uma pessoa.