
一次 Agent 演示很容易结束:代码改好了,终端停了,屏幕上出现“完成”。团队的工作却从这里继续。谁检查改动?下周换一个人,能否找到原始材料、运行过程和结果?模型、工具与执行环境由谁维护?
比较 Buda 与 Deep Agents Code,先明确团队准备接手哪一层责任,比先数功能更有用。
**Deep Agents Code 适合希望控制 Agent 运行栈的开发团队;Buda 适合希望在云端工作区组织任务、查看执行并接手文件与结果的团队。**这不是“一个有工具,一个没工具”的区别。Deep Agents Code 已经支持远程沙箱、持久记忆、子 Agent、Skills、MCP、审批和追踪。
先认清产品:dcode 不是只有本地终端
Deep Agents Code,命令名 dcode,是建立在 Deep Agents SDK 上的开源编程 Agent。它与 SDK 相关,但不是同一个交付物:SDK 用于构建 Agent,dcode 提供可以直接运行的终端入口。
官方文档列出的能力包括模型与提供商切换、记忆、上下文压缩、Skills、MCP 工具、子 Agent,以及 LangSmith 追踪。工具还可以在远程沙箱里执行。因此,“离开电脑就不能运行”“没有记忆”“只能单 Agent”都不是合适的比较前提。
它最值得单独讨论的能力,是把完成标准放进执行循环。通过 /goal,Agent 可以先提出验收条件;通过 /rubric,团队可以直接指定已有标准。目标能跨回合保持,也能暂停、恢复或修改。这让工程团队有机会把“修好它”变成可检查的任务。
Buda 的组织单位则是 Agent Workspace:对话、持久文件、Terminal、浏览器、预览和 Git,是同一个云端执行环境的不同视图。Agent 写出的文件会出现在文件视图,启动的应用可以预览,代码提交可以在 Git 中检查。编程也是其中一种工作,而不是唯一的结果形式。
比较的是责任,不是功能勾选
| 需要决定的事情 | Deep Agents Code | Buda |
|---|---|---|
| 如何定义任务完成 | goal 与 rubric 可进入 Agent 的执行和评分流程 | 人在任务要求中定义产物与验收点,并通过工作区检查 |
| 工具在哪里运行 | 可在本机或配置的远程沙箱运行 | 工作区中的工具运行在 Agent 的云端环境 |
| 谁维护模型与运行配置 | 团队选择提供商、凭据、工具和配置 | 团队管理 Agent、上下文与任务;仍需配置所用集成和访问范围 |
| 如何排查执行过程 | 可使用 LangSmith 追踪及终端上下文 | 可从对话、文件、Terminal、浏览器、预览和 Git 查看过程 |
| 结果如何交给下一岗位 | 由团队设计文件、仓库和交接约定 | 文件和执行视图聚在同一工作区;业务验收仍由团队负责 |
两者都需要人负责权限、机密材料和最终验收。把运行环境托管到云端,不会自动产生组织审批;拥有一个评分器,也不等于已经批准了业务结果。
一项工程任务:把 rubric 写得足够具体
下面是一个建议的试点,不是已执行的产品性能测试。
假设团队需要为一个已有服务补充 OAuth refresh handling。与其只要求“增加刷新逻辑”,可以先写清:
- 访问 token 过期后能够刷新;refresh token 无效时返回明确错误。
- 并发请求不会重复触发无界刷新。
- 现有测试不回退,新增测试覆盖失效、重试和并发边界。
- 不修改无关模块,不把凭据写入日志。
- 交付改动说明、测试命令和仍未解决的问题。
Deep Agents Code 的 goals 与 rubrics 文档提供了两种入口。如果标准还不明确,可以用 /goal 让 Agent 先提出条件,确认后再执行。如果团队已经有标准,可以用 rubric 文件;非交互运行也支持 --rubric。
这里真正需要审的是评分条件:测试通过但日志泄露 token,任务仍然不合格;所有自动检查通过,但登录行为破坏了客户现有使用方式,也需要人工判断。给评分器另一套模型或更多迭代次数,不能替团队决定这些业务边界。
在 Buda 中,同一任务可围绕仓库、文件和运行结果组织。交付要求应明确列出修改、测试、预览或日志位置,让审阅者能实际打开。本文没有执行两者同任务对照,因此不提供速度、成本或通过率排名。
工程通过以后,还要有一份能接手的交付包
完成代码只回答了一部分问题。支持团队可能要知道刷新失败会出现什么提示,产品负责人需要知道哪些客户场景变了,运营需要更新使用说明。
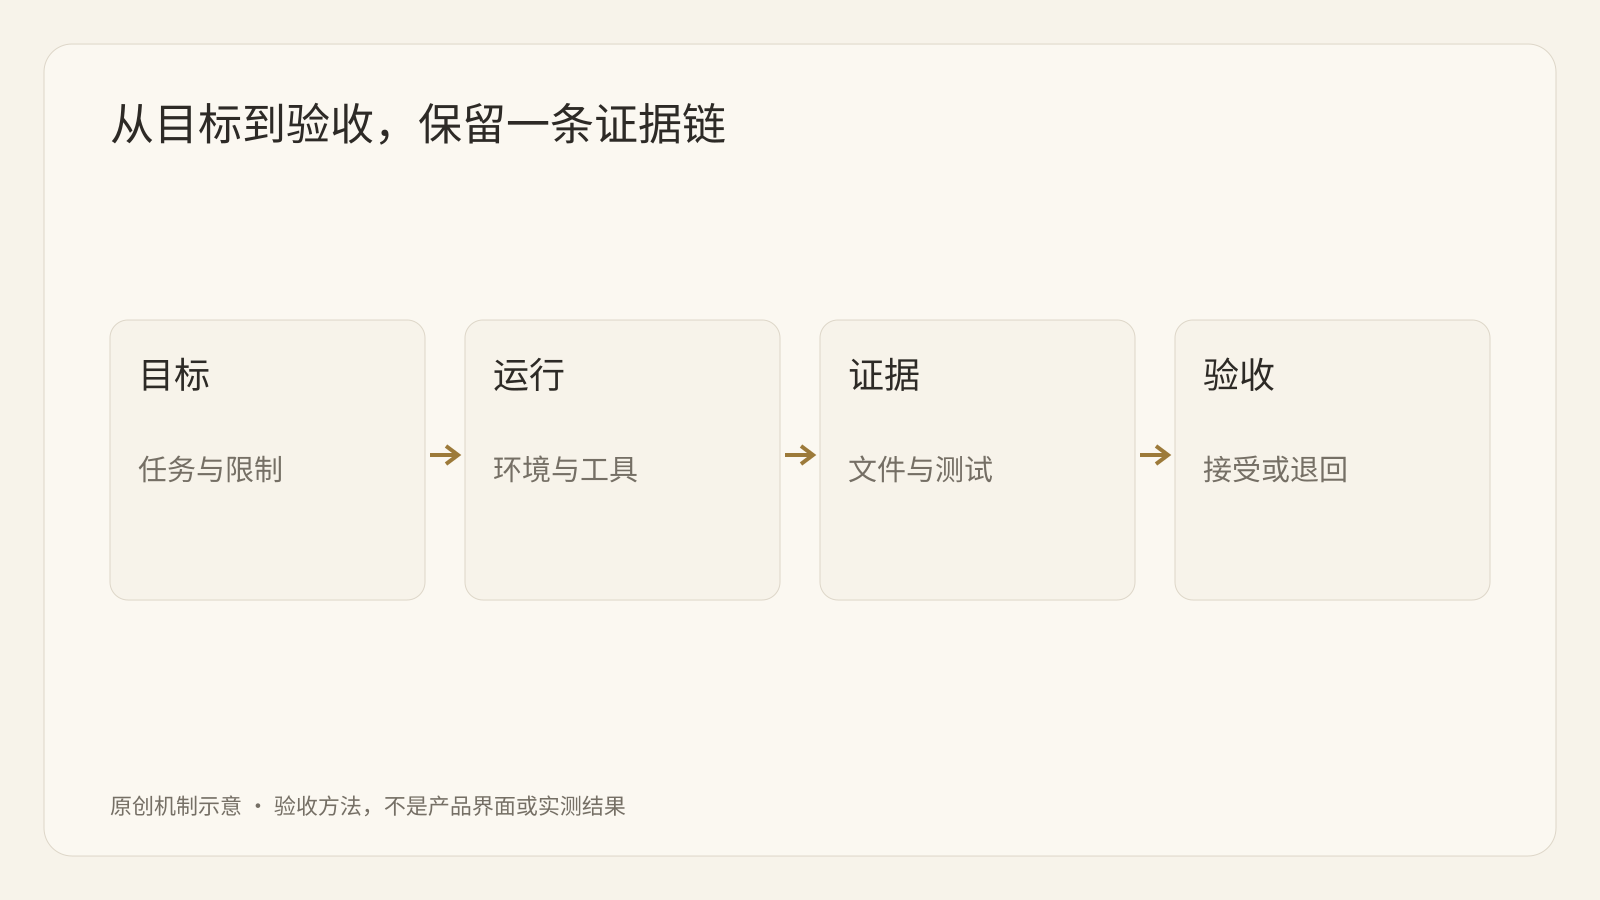
可以要求工程任务同时交付:change-summary.md、测试结果、已知限制,以及面向非开发岗位的使用变化说明。每个文件写清对应版本和验证依据。下一岗位不必从几十轮终端消息中猜测最终结论。
dcode 可以生成这些文件,也可以通过工具扩展工作范围;采用它的团队要决定文件存放、追踪入口、访问方式和交接纪律。Buda 把文件和执行视图放在一个工作区中,减少在多个表面寻找结果的成本,但“谁有权接受结果、哪些材料可以共享”仍是团队规则,不能省略。
工作区适合成为检查位置,不应被描述为自动担保所有内容可信。Agent 的说明是待审材料;测试输出、可打开的文件和可复现行为才是验收依据。
两轮试点,检查维护成本和交接成本
只做第一轮容易高估效果:最熟悉工具的人准备好环境、修好配置并亲自验收,所有额外工作都被藏在演示之外。
建议第二轮使用另一位接手人和一份变更后的输入。两轮都记录:
- 运行准备:模型凭据、工具、环境和权限花了多少人工操作;哪个错误需要维护者处理。
- 结果检查:审阅者能否找到准确版本、测试和未解决事项,而不是只看到聊天中的“完成”。
- 交接复用:第二位同事能否根据文件继续任务,是否还要回头询问第一位操作者。
- 变更恢复:更换提供商、修改 rubric 或更新工具后,任务与验收是否仍保持一致。
将配置时间、运行费用、人工修复和审核时间分别记录,避免把所有差异归为“模型更强”。这里给的是试点设计,不是节省比例承诺。
选择落在团队想掌控的层上
如果团队要研究 Agent 行为、调整提供商和 grader、将工具与远程沙箱接进自己的工程系统,Deep Agents Code 的可组合入口有实际价值。愿意维护这些部件,本身就是一种合理选择。
如果当前瓶颈是多个岗位找不到任务过程、文件和结果,希望把执行与检查放进一个持久云端工作区,Buda 更贴近这个问题。先用一个有明确产物的真实任务验证,而不是先把所有业务搬进去。
两者也可以承担不同工作:工程团队使用自己的运行栈,业务岗位使用工作区组织其他任务。这样的分工是建议,不代表已验证 dcode 与 Buda 的直接集成,也不应预设两者会自动同步记忆、审批或文件。
FAQ
Deep Agents Code 是否只能本地运行?
不是。官方文档列出远程沙箱能力。部署位置需要结合实际配置判断,不能用“终端入口”推断工具只能在本机执行。
dcode 的 goal 和 rubric 有什么区别?
goal 适合先给目标、由 Agent 提出验收条件的任务;rubric 适合团队已有明确标准的任务。goal 有持续、暂停和恢复等生命周期;rubric 可作用于一次执行或后续回合。具体审核行为取决于审批模式和配置。
Buda 是否提供与 /rubric 相同的内置评分器?
本文引用的工作区证据没有证明两者存在相同的原生评分功能,因此不作等同描述。可以在任务要求中明确验收标准,并检查文件、测试和执行结果。
开源工具与 Buda 的费用可以直接比吗?
不能只把许可费用与订阅价格相减。模型、远程环境、运行维护和审核投入应分别计算;Buda 的套餐与 Credits 以 当前定价页 为准。本文不提供未经同任务测试的成本优势。
是否应立即迁移已有 dcode 流程?
不必。如果运行栈已经稳定,先找交接困难的任务做独立试点。只有看到过程可检查、产物可接手,以及维护投入适合团队,才扩大范围。
从一份验收清单开始
选择一个真实任务,写出输入、允许操作、交付文件和通过条件。用同一清单评估运行栈与工作区,再让第二位同事接手结果。要了解 Buda 的检查表面,可以从 Agent Workspace 开始。
资料核验:2026 年 10 月 8 日。Deep Agents Code 概览与 goals/rubrics 文档用于产品事实;工程场景与两轮试点为本文构造的评估方法,未执行为对比测试。