
客户发来一封询盘,附件是一份不整齐的需求表。系统要识别产品、查资料、发现缺失条件,再准备回复。固定字段可以映射,含糊的要求需要判断,最后的报价又不能未经确认就发出去。
这类工作不是“自动化或 Agent”二选一。Make 已把 Agent 放进 Scenario Builder:场景负责接收事件、组织输入和连接系统,Agent 在其中选择工具、使用知识并处理变化的信息。Buda 则把执行放在一个能打开文件、查看浏览器和终端、反复修订产物的工作区。
选择的关键是:你主要在维护一条跨系统业务流程,还是在经营一份需要持续检查与修订的工作成果?
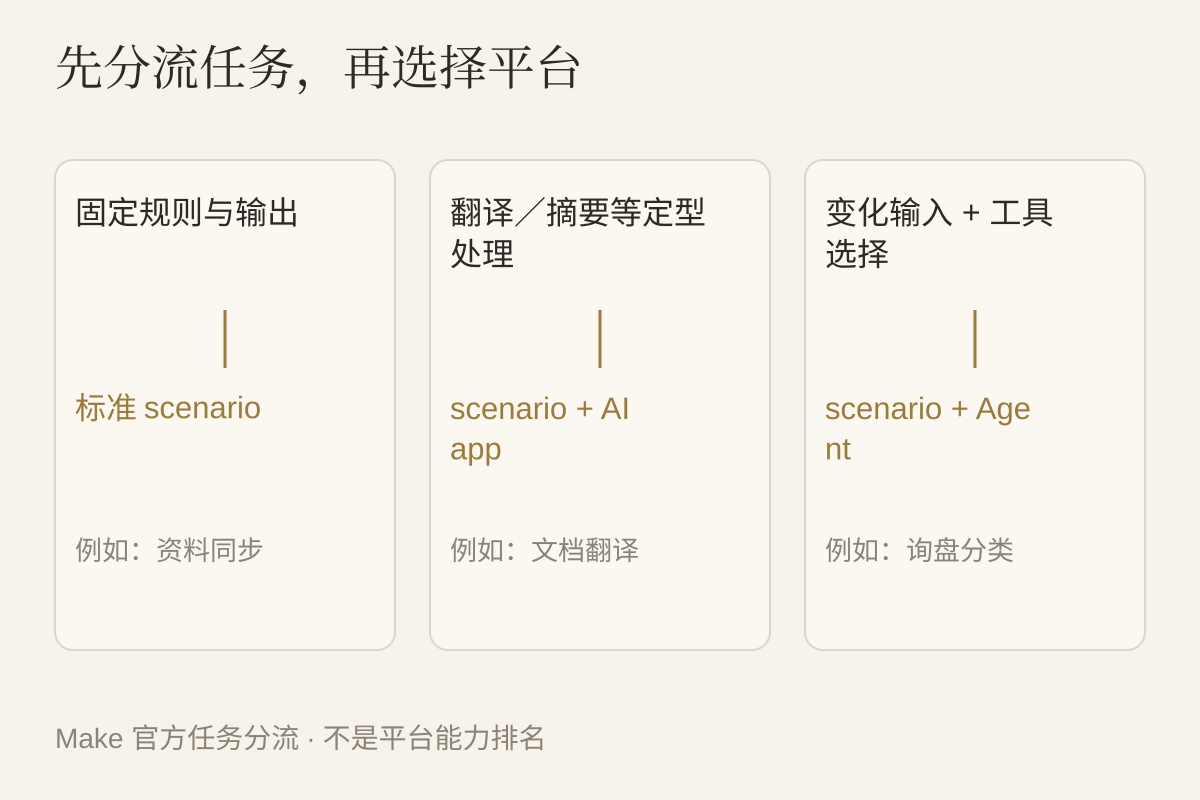
先把任务分成三类,而不是全部交给 Agent
Make 的新 Agent 入门文档给出了很实用的分流方式:
- **固定规则:**表单提交后同步 CRM、更新订单状态,使用标准 scenario。
- **固定参数的 AI 处理:**给定文本做翻译、转写、摘要,使用带 AI app 的 scenario。
- **变化输入与判断:**分类支持工单、筛选候选人、分析市场数据,使用带 Agent 的 scenario。
如果输出完全由输入规则决定,增加 Agent 会引入不必要的不确定性。反过来,客户需求不完整、工具调用要临时选择时,不能用几十条固定分支假装已经覆盖所有情况。
Make AI Agent (New) 的文档对应 2026 年 2 月 2 日发布的新版本,截至本次核验仍标为 open beta。公开说明提醒功能与价格可能变化。
在 Make,一封询盘如何进入 Agent
先搭一个只生成内部草稿的询盘流程,暂不发送客户邮件、不写正式报价。
**1. 用触发模块接住输入。**Make 的触发说明覆盖邮件、聊天、表单、webhook 和 mailhook,也说明可以按计划自主运行。触发模块决定请求从哪里来,并不是 Agent 自己猜测该处理哪条记录。
**2. 把本次需求和长期资料分开。**客户消息、附件是每次变化的 input 与 files;产品说明、FAQ、品牌政策可以作为 knowledge。文档将 knowledge 描述为保存在 Agent memory 中的参考文件,因此不能说 Make 没有记忆或不会用文件。
**3. 给 Agent 可调用的工具。**Make 的 tools 可以是 modules、scenarios、MCP server tools 和其他 agents。已配置的产品查询 scenario 可以成为工具,但需要核对它接受的输入、返回结果和写入权限,而不是随意暴露整个后台。
**4. 把判断结果交给后续模块。**可以要求输出产品分类、证据、缺失字段和回复草稿,再映射到内部审核位置。给 Agent 一个明确的输出要求,比要求“自己处理好客户”更方便检查和接手。
这里的维护重点是触发、字段映射、连接与工具契约。每个环节都应有负责人,尤其是客户附件格式变化、CRM 字段改名或旧查询工具返回空结果时。
Make 的可视调试,不只是看最终回复
新应用发布说明描述了 Scenario Builder 内的创建、运行、测试和调试:实时动画展示思考状态、耗时与工具调用顺序;Reasoning 面板显示用于排查决策的解释;可以添加 tools 与 knowledge、聊天测试并处理文件。
这些能力意味着 Make 的路线也能观察 Agent 行动,不能把比较写成“Make 黑箱、Buda 可见”。但可见信息的组织方式不同:Make 围绕场景与工具调用调试,Buda 把文件、网页、命令和代码产物放在同一个执行现场。
Reasoning 面板提供的解释不是正确性的独立证明。工具选对了,也可能引用过期资料;场景全部运行成功,也可能遗漏客户要求。验收仍要检查结果、来源和未解决问题。
在 Buda,让询盘形成一份可修订的工作包
Buda 的Agent Workspace将聊天、持久 Files、Terminal、AI Browser、Web Preview 和 Git 放在同一台云电脑的多个视图中。
同样的询盘可以先变成明确的任务包:客户原文、批准使用的产品资料、禁止承诺的条款、回复要求和交付目录。Agent 整理附件,必要时浏览公开资料或运行脚本,再生成需求表、来源清单与回复草稿。
负责人检查真实文件和中间产物,指出需要改的参数。下一轮保留工作文件,继续修订,而不是只复制一段完成消息。文件的存在不代表授权完成;连接邮箱、CRM 或外部工具仍要单独配置与核验。
Drive 与记忆也需要明确边界:一个 Agent 的持久文件与团队共享的 Space Drive 不是同一个位置。给第二位同事接手时,应明确哪些资料共享、哪个版本已接受,不能假设全部上下文会自动跨 Agent 出现。
比较维护对象,而不是比较谁“更智能”
| 维护问题 | Make AI Agents 路线 | Buda 工作区路线 |
|---|---|---|
| 输入从哪里来 | scenario trigger 与字段映射 | 任务输入、Drive 与已配置连接 |
| 如何查业务资料 | knowledge 与 modules/scenarios/MCP 等工具 | 文件、浏览器、脚本与已授权工具 |
| 失败后检查什么 | 场景步骤、工具顺序、输入输出、Reasoning | 文件、命令、网页过程、任务与产物 |
| 第二个人接手什么 | 场景配置、连接、工具契约与测试输入 | 工作目录、业务说明、版本与验收标准 |
| 输出怎样回业务系统 | 后续模块及映射,需核验授权 | 接受后的文件交付或已验证连接 |
如果核心问题是“某个事件发生后,几套系统如何同步、路由、再插入一段判断”,Make 的场景组织很自然。已有 Make 工作流的团队,不应只因为出现新 Agent 产品就整体迁移。
如果工作常变成多份文件、网页研究、脚本加工和跨轮修改,负责人需要直接打开成果并继续工作,Buda 的工作区更值得试用。这是对工作组织方式的判断,不是经过实测的效率排名。
用失败输入检查可维护性
不要只给两个平台一个干净样本。准备三种测试:缺少产品型号、附件与正文冲突、查询工具没有结果。两边都要求停止猜测、标出缺口,并留下草稿供人决定。
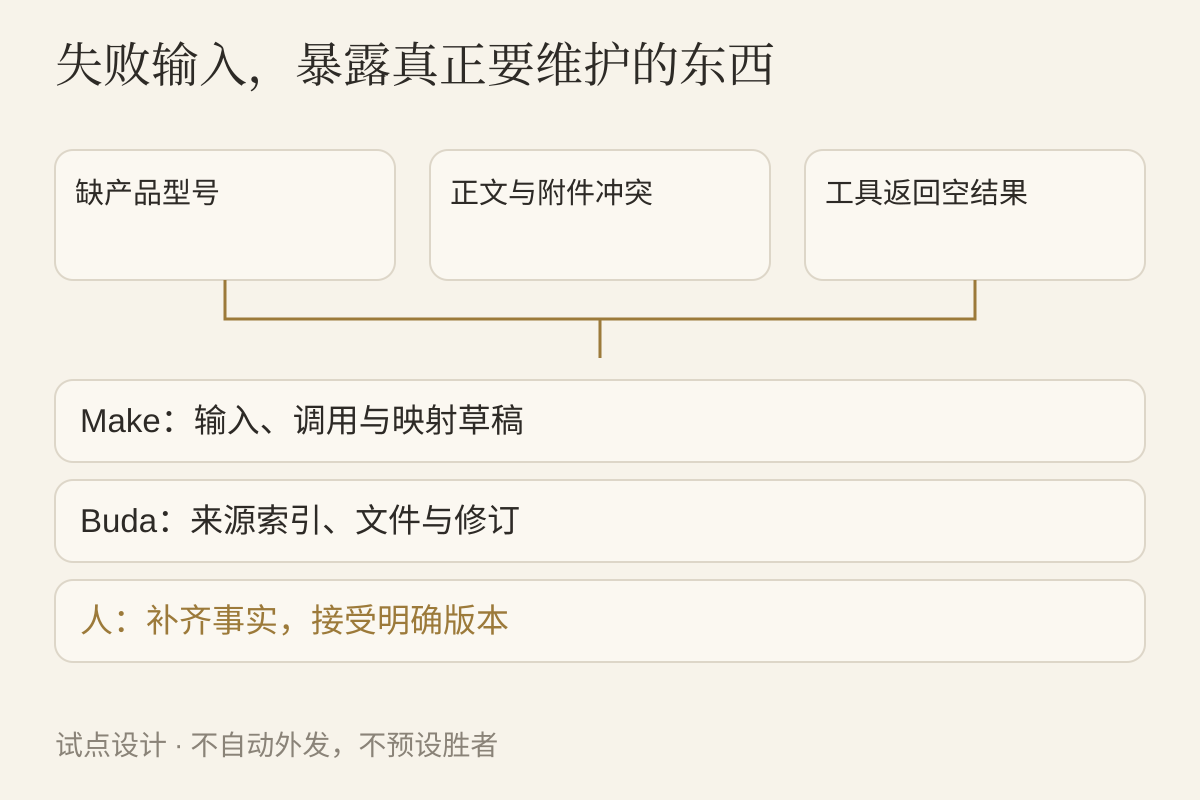
记录以下五件事:
- 能否追到原始输入与采用的资料版本。
- 缺失信息是否明确列出,而非被模型补全。
- 哪个工具失败,重跑是否会产生重复写入或重复发送。
- 第二个人是否无需借用原账号就能检查并接手。
- 人接受了哪个版本,下一次由谁维护。
计量连接配置、返工、检查和接手的实际耗时,再决定是否扩展。不预设 Make 更便宜或 Buda 更快;Make Credits、上游模型费用和 Buda Credits 也不能直接混成一个数字。
不必把同步流程和开放式产物绑在一起迁移
现有 Make 场景可以继续承担固定同步;需要研究和反复修改的任务,可以在 Buda 准备审阅产物。两边交接时先约定文件格式、记录 ID、资料版本、写回负责人和允许动作。
先从明确的文件交付做起,分别配置两边需要的连接与工具;不要让两个 Agent 同时修改同一客户记录。最小试点只生成内部草稿,确认交接后再评估正式写入。
在 Buda,先用真实但脱敏的输入形成一份可审阅工作包。重复的步骤再整理为 Skill;也可以在 Buda AI 的 Marketplace 搜索并安装适用 Skill。先让第二个人接手成功,再把“怎么做”接上“何时运行”。
搭建时最容易卡住的三个地方
instructions 写好了,为什么 Agent 还是查不到 CRM?
先确认负责查询的 module 或 scenario 已加入 tools,使用的连接账号能访问目标记录。用同一个客户 ID 单独测试工具,检查返回字段,再把结果交给 Agent。把“查 CRM”写进 instructions 只是提出任务,不会创建连接或补齐权限。
已有的 scenario,怎样改成 Agent 能调用的工具?
先缩到一个明确动作,例如“按产品编号查库存”,而不是“处理整笔销售”。定义必填输入、返回字段、查不到时的结果,并单独测试。涉及发送或写入的动作,与只读查询分开;在草稿试点里先不开放。Make 支持 scenario 作为工具,工具契约决定它能否被 Agent 正确使用。
怎样避免 Agent 猜缺失信息,或重跑时重复发送?
输出里固定保留“缺失字段”和“待确认项”,缺少产品型号时返回草稿,而不是生成报价。发送与正式写入放在独立步骤,由人接受后触发;每笔输入保留记录 ID,执行前检查是否已处理。再用缺型号、冲突附件、空查询结果各测一次,看系统是否按预期停在审核位置。