
Claude Fable 5.1 更新了什么:迁移风险与升级判断
Claude Fable 5.1 是 Anthropic 当前的 Fable 型号,面向高难度推理和长周期 Agent 任务。它没有提高输入、输出的目录单价,却把缓存读取价格降到了原来的四分之一,也加入了更适合长任务的控制能力。
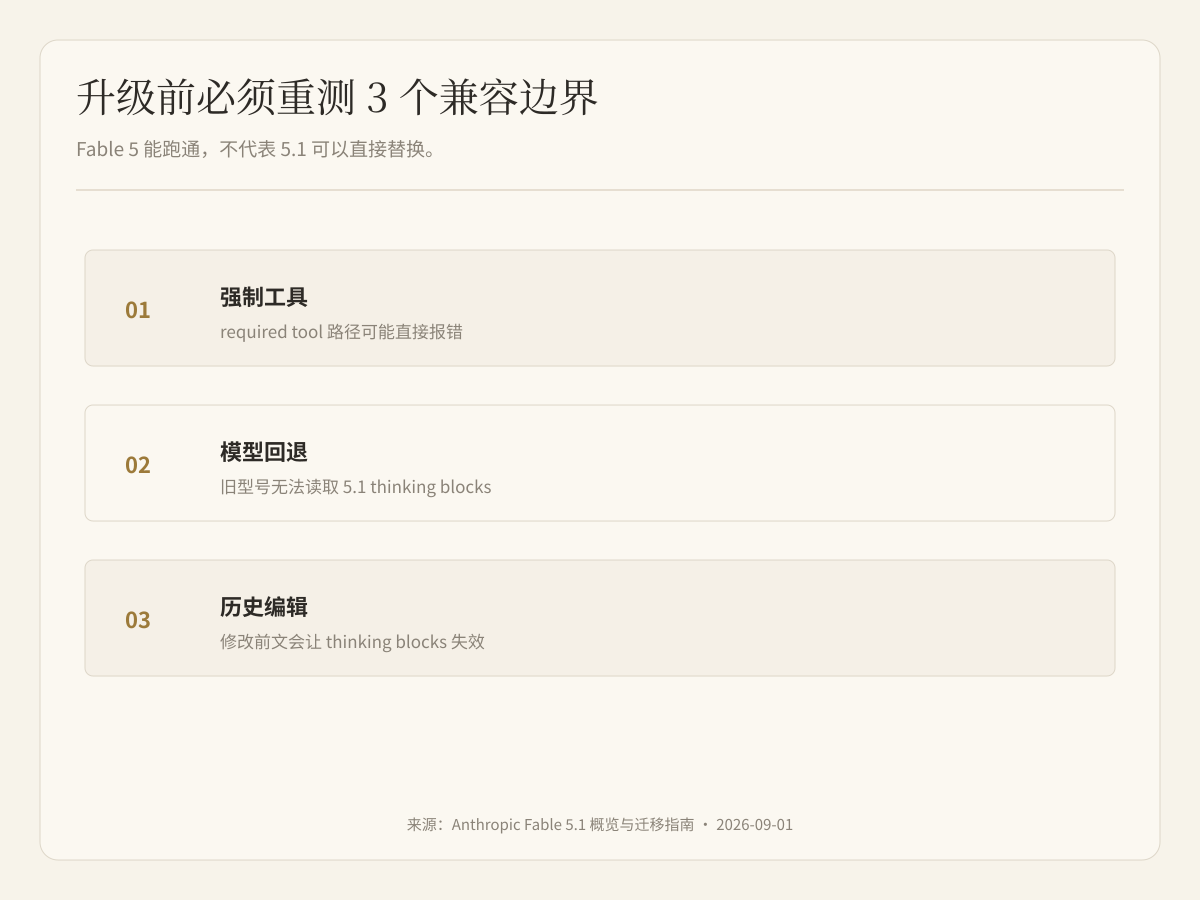
但这不是一次可以直接替换模型 ID 的小升级。官方同时列出了 3 项兼容性变化,分别影响强制工具调用、跨模型读取 thinking blocks,以及修改历史对话后的状态有效性。
先给结论:大多数任务仍应先从 Claude Opus 5 开始。只有当 Opus 5 在较高 effort 下仍达不到你的验收标准,才需要把 Fable 5.1 放进候选。 升级前先跑真实任务评测,不要只看一次演示。
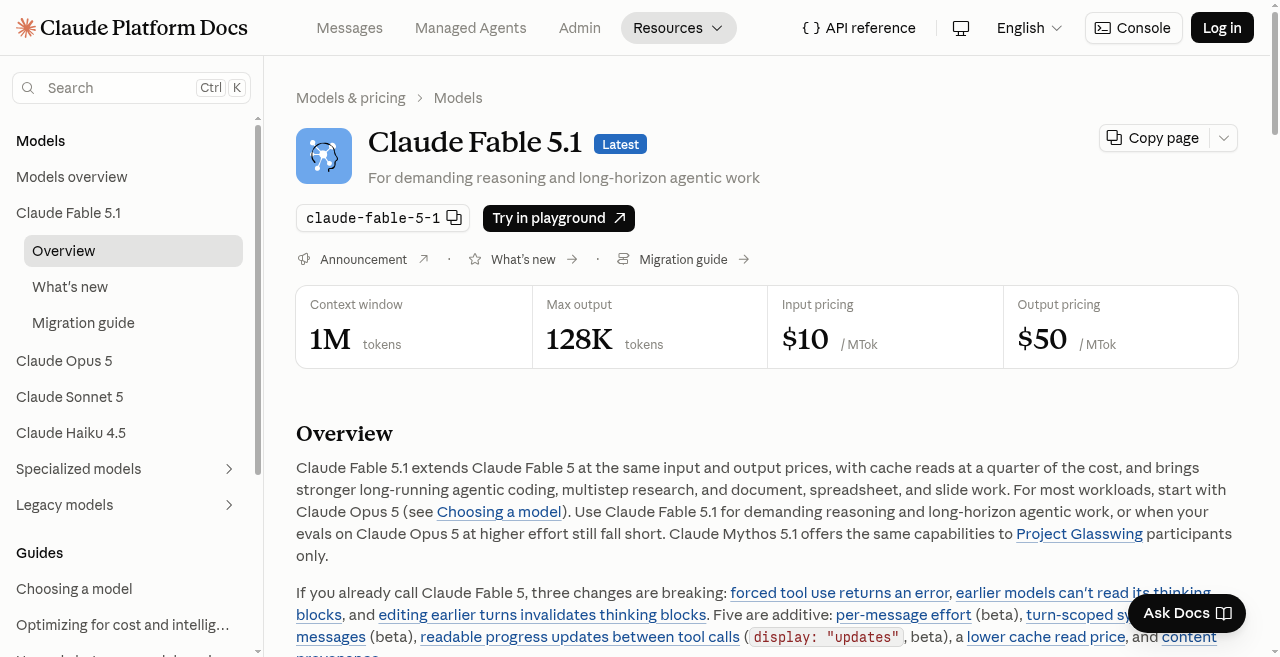
来源:Anthropic Claude Platform 文档,截图于 2026 年 9 月 2 日。
Claude Fable 5.1 是什么?
Anthropic 于 2026 年 9 月 1 日发布 Claude Fable 5.1。官方规格包括:
- 100 万 token 上下文窗口
- 最大输出 12.8 万 token
- 始终开启 adaptive thinking
- 可靠知识截止时间为 2026 年 6 月
- 适合长周期 Agent 编程、多步骤研究,以及文档、表格和演示文稿任务
Fable 5.1 的定位不是“所有任务的默认模型”。Anthropic 明确建议,大多数工作先用 Opus 5;只有 Opus 5 在更高 effort 下仍不够时,再考虑 Fable 5.1。
这也是更合理的 Agent 架构:昂贵模型承担少数高难度判断,便宜模型处理提取、格式化、常规工具调用和容易验证的步骤。
Fable 5.1 和 Fable 5 有什么不同?
| 项目 | Fable 5 | Fable 5.1 | 实际影响 |
|---|---|---|---|
| 状态 | Active,legacy | Active,latest | 新评测应以 5.1 为主 |
| 上下文 | 1M | 1M | 没有增加 |
| 最大输出 | 128K | 128K | 没有增加 |
| 上游输入/输出目录价 | $10 / $50 每百万 token | $10 / $50 每百万 token | 基础单价不变 |
| Cache read | $1 每百万 token | $0.25 每百万 token | 重复读取长上下文明显更便宜 |
| 长任务控制 | 旧能力 | per-message effort、turn-scoped system messages、可读进度更新 | 执行过程更容易控制 |
| 内容溯源 | 旧能力 | content provenance | 支持的输出更容易追踪来源 |
这里的 $10 / $50 是 Anthropic 上游 API 目录价,不是 Buda 用户价格。Buda 可能使用 Credits、倍率、最低扣费、工具调用和缓存等独立规则。本文也没有确认 Fable 5.1 已经在 Buda 上线。
升级前必须检查的 3 个兼容性变化
1. 强制工具调用可能直接报错
如果你的 Agent 强制指定某个 tool,旧模型下能运行的请求,在 Fable 5.1 中可能返回错误。所有 required tool 路径都要重新测试,不能只验证普通自动选择工具的路径。
2. 较早型号不能读取它的 thinking blocks
如果工作流在 Fable 5.1 和旧型号之间切换,旧型号可能无法继续读取 Fable 5.1 留下的 thinking blocks。模型路由和 fallback 必须用真实多轮任务验证。
3. 修改前面的对话会让 thinking blocks 失效
很多 Agent 框架会压缩历史、修订旧消息或从中间分支重试。到了 Fable 5.1,这类历史编辑可能让已有 thinking blocks 失效。要重点测试 transcript 编辑、context compaction、重试、分支和人工修订。
哪些任务值得升级?
下面几项同时成立时,Fable 5.1 才更可能值得:
- 任务持续时间长,包含多阶段判断和执行
- 错误成本高,返工会影响真实业务结果
- Opus 5 在合适 effort 下仍达不到验收标准
- 工作流反复读取大量稳定上下文,cache 命中率可观
- 最终结果或高影响动作仍由人审核
如果任务重复、低风险、追求低延迟,或者结果很容易自动验证,继续用更便宜的模型通常更合理。
Cache read 降价,不等于整项任务便宜 75%
长任务会反复读取系统指令、工具定义、文件和历史步骤。把 cache read 从 $1 降到 $0.25 / MTok,确实能降低一部分长期运行成本。
但总成本还包括:
- 未缓存输入
- 模型输出和推理 token
- 工具调用
- Subagent
- 重试和失败执行
- 人工审核
- 修正与返工
更实用的核算公式是:
单个验收通过任务的总成本 = 模型 + 工具 + 失败执行 + 重试 + 审核 + 返工
贵模型如果能减少错误,可能反而更便宜;便宜模型如果需要反复重跑,也可能更贵。
一份更稳妥的迁移清单
- 在测试环境固定使用
claude-fable-5-1。 - 准备一组来自真实业务的评测任务。
- 测试所有强制工具调用路径。
- 测试模型 fallback 和 thinking blocks 兼容性。
- 测试历史压缩、旧消息编辑、重试和分支。
- 比较验收通过率、总成本、延迟和人工修正次数。
- 先在一个有限工作流灰度,不直接替换全局默认模型。
- 保留不依赖不兼容 thinking state 的回滚方案。
对使用 Agent 的团队意味着什么?
模型越强,单次自主执行可能走得越远。相应地,权限、过程可见性、评测和人工审核也越重要。
Buda 负责的是这一层运行环境:Agent 在持久文件和真实工具上执行,人可以查看 Session 和产物,并在重要结果进入外部系统前保留审核权。模型选择只是系统的一部分。更重要的问题是:工作有没有边界,过程是否可见,结果能不能被人接管和验收。
进一步了解模型路由,可以阅读 如何为 AI Agent 选择合适的模型。旧版本背景见 Claude Fable 5 已在 Buda 上线。Fable 5.1 的 Buda 可用性和 Credits 请以当前产品页面为准。
常见问题
Fable 5.1 比 Fable 5 便宜吗?
上游输入和输出目录价不变,仍为每百万 token $10 / $50。Cache read 从 $1 降到 $0.25。真实总成本取决于缓存命中、输出、工具、重试和返工。
所有 Fable 5 工作都应该马上迁移吗?
不应该。先跑评测和兼容性测试,尤其是强制工具调用、混合模型 Session 和历史消息编辑。
Fable 5.1 是否全面优于 Opus 5?
不是。Anthropic 建议大多数任务先从 Opus 5 开始。只有高难度、长周期任务在 Opus 5 上仍未达标时,才需要评估 Fable 5.1。
Fable 5.1 已经在 Buda 上线了吗?
型号可用性和 Credits 会随产品更新,请以 Buda 当前模型列表为准。本文中的 Anthropic 目录价是上游参考价格,不是 Buda Credits。