
Claude Opus 5.5 有 100 万 Context,为什么 Agent 还是会忘事?
一个 Agent 在长会话里读完资料,第二天换个会话继续工作,却忘了昨天批准过哪一版。这不是“窗口还不够大”,而是决策只待在对话里,没有变成下一次工作能找到的记录。
Opus 5.5 提供 100 万 token 的 context window,最大输出 12.8 万 token。它能在一次请求中处理更多材料;但窗口里的信息不会自动成为可复用、可审计的团队记忆。
大窗口能解决当下阅读,不能决定明天该相信什么
当前上下文可以容纳任务要求、长文档和工具返回结果。随着任务推进,部分内容会被裁剪、总结,或被新的会话取代。即便每次都塞入全量历史,模型仍需判断哪份文件是最新、哪个结论被批准、哪条数字后来已被修正。这些是版本和责任问题,不是容量问题。
因此不要把“Agent 看过”当成“团队已经保存”。前者只说明某次推理用到了材料;后者需要一个有位置、有时间、有来源和更新规则的记录。
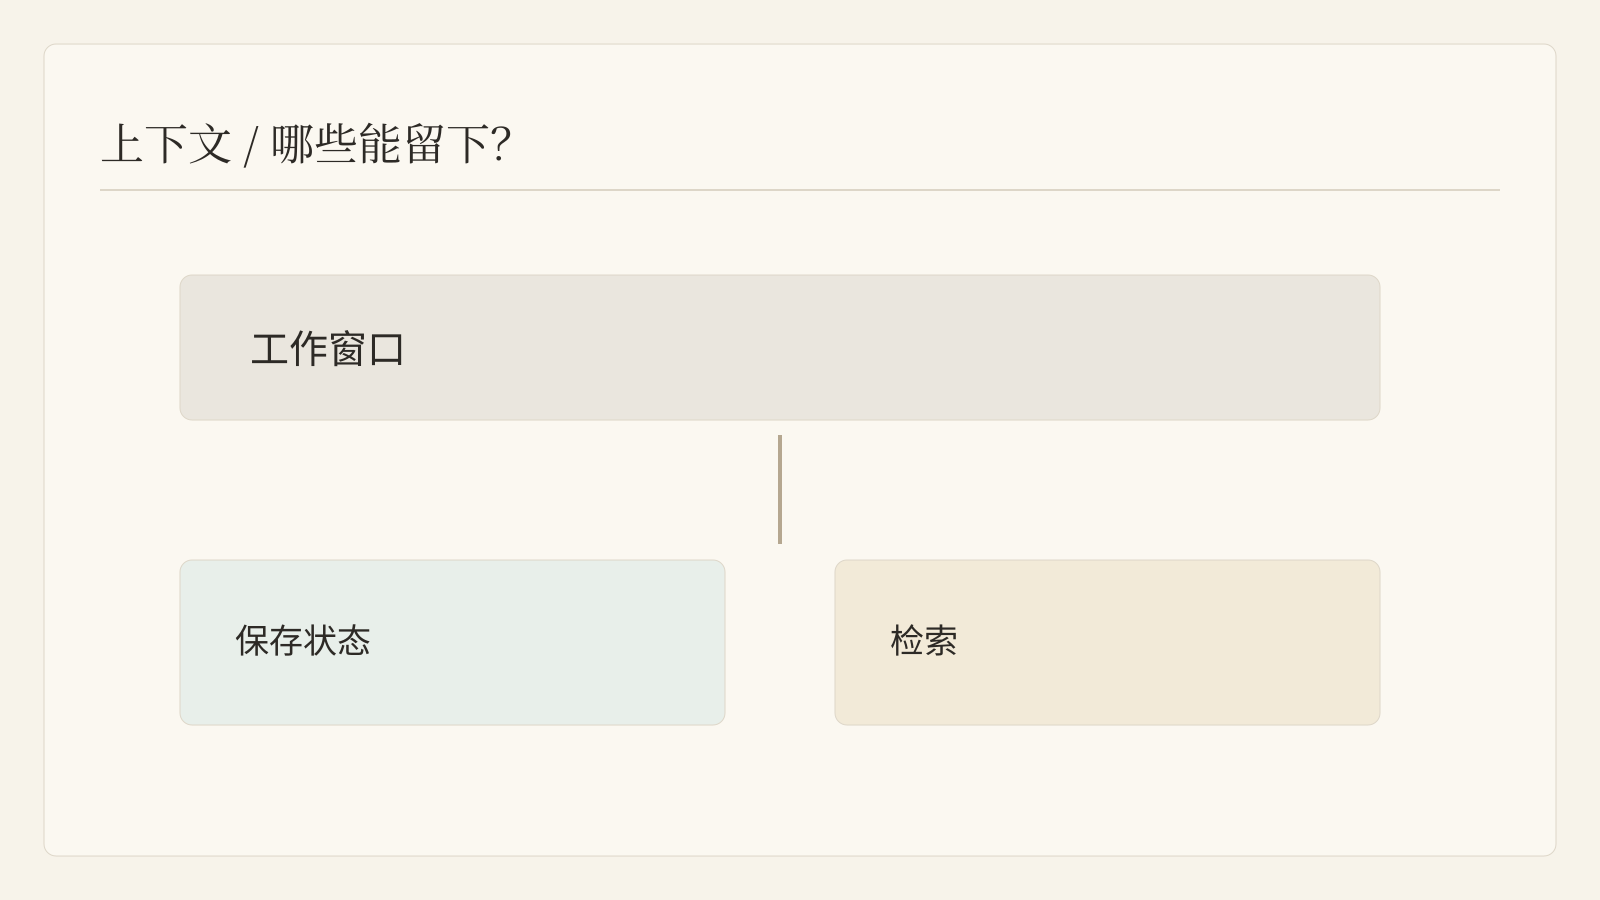
四种状态,分别放在该放的地方
工作上下文放当前步骤需要的指令与证据,可以按任务重新组装。进度状态写明已执行什么、哪些测试失败、哪些文件已修改、下一步从哪里开始;这样任务中断后不必靠回放全部对话恢复。
持久知识保存已确认的事实、决策和来源,也记录谁负责更新与何时复核。审计历史保留批准过程、修改差异和最终版本;它不能随着一次“帮我总结会话”就被无声覆盖。
例如制作多语言文章:上下文里可以放当前语言的草稿和风格规则;进度里记已完成的语言与待改段落;持久记录保存最终标题、链接和已确认事实;审计历史说明哪个版本经过审核。下一个编辑不需要通读所有聊天,也能找到正确的起点。
Preserved thinking 不是一种记忆数据库
Anthropic 的迁移说明要求工具调用后的 thinking blocks 按原样返回,且先前消息与工具定义应保持一致。随意改写历史,可能使这些块失效。这个约束服务于对话完整性,不等于模型会把每次推理自动整理成组织知识。
如果工作要跨会话、跨模型或跨 Agent,交接应写出人可检查的结论和未决事项,而不是依赖某段专有的 thinking 内容。把内部推理当作长期记录,不仅难以检索,也很难解释给后来负责审核的人。
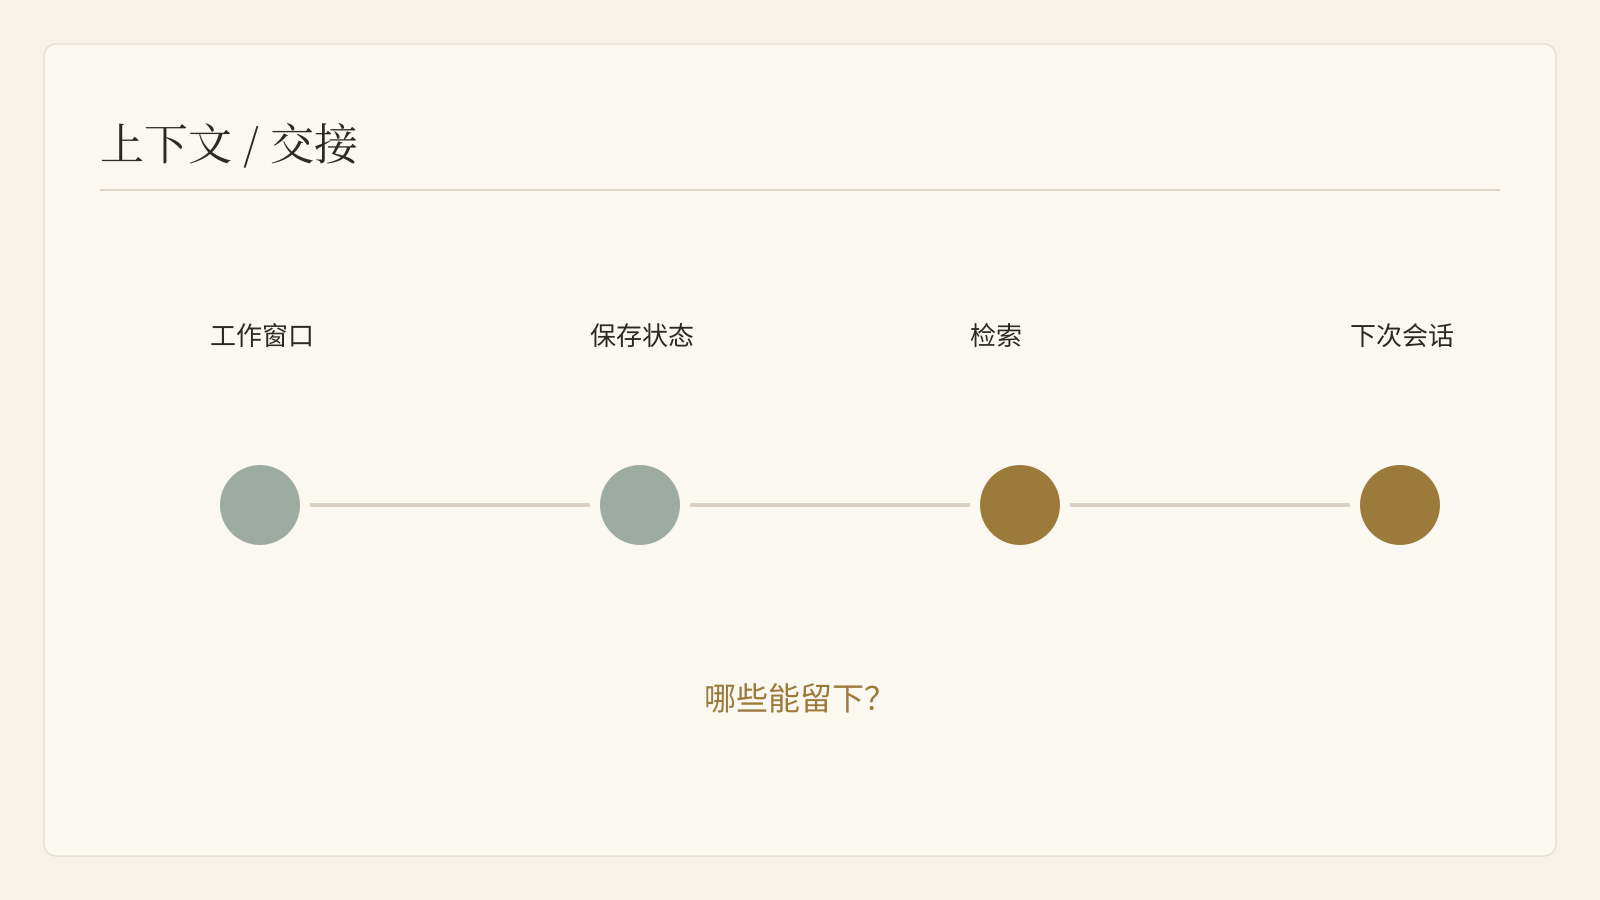
一次可复现的交接怎么做
开始时确定目标、输入材料、权限、完成标准和文件位置。执行中在关键节点留下产物,而不是等最后一轮才说“做完了”。每次交接至少包含:已完成动作、可打开的结果、验证方法、失败与未确定事项、下一步和需要人批准的动作。
随后故意中断会话,换一个 Agent 接手:它能否不依赖原对话找到正确文件?能否说清哪条数据有来源、哪一版被认可?能否从上次失败处继续而不重复已做的外部动作?这些问题比单纯问“能塞下多少 token”更能检验工作流的记忆质量。
Buda 的文件、会话、工具记录和可审核产物为交接提供可见的工作面。真正可靠的长期状态仍要由文件和记录承接,并由人决定哪些结论可以进入可信版本。
在 Buda 中使用 Opus 5.5
Claude Opus 5.5 已在 Buda 上线,可在 Agent 的模型选择器中选择,继续使用原工作区和文件。更大的模型上下文不会让对话自动变成永久记忆;关键决定、证据与交接检查点仍应保存到文件或可信记录中。