
Anthropic 在 2026 年 9 月 22 日发布了 Claude Opus 5.5。表面看,这是一次“更强、更快、更便宜”的模型更新;真正影响 Agent 工作流的,却是 thinking、工具调用、computer use 和会话历史的接口变化。
只看榜单,容易漏掉迁移成本。只看 token 单价,也会漏掉重试、工具循环失败和人工审核的成本。
先看结论
Anthropic 将 Opus 5.5 定位为面向长时间 Agent 编程和知识工作的模型,API model ID 是 claude-opus-5-5。它有 100 万 token 上下文、最多 12.8 万输出 token,并且 adaptive thinking 始终开启,不能关闭。
| 变化 | Claude Opus 5.5 | Claude Opus 5 | 团队真正要验证什么 |
|---|---|---|---|
| 标准输入价 | 每百万 token 4 美元 | 5 美元 | 加上文件、工具和重试后的总输入 |
| 标准输出价 | 每百万 token 20 美元 | 25 美元 | thinking 与可见输出都占输出预算 |
| Cache read | 每百万 token 0.20 美元 | 0.50 美元 | 长会话里的真实命中率 |
| 默认 effort | medium | high | 默认档是否已经够用 |
| Thinking | 始终开启 | 部分 effort 可关闭 | 现有请求与响应处理是否兼容 |
| 上下文 | 100 万 token | 100 万 token | 工具结果和保留 thinking 后还剩多少 |
Anthropic 表示,Opus 5.5 在默认设置下的典型工作负载成本比 Opus 5 低 40%,输出速度快 30% 以上。这是厂商基于其测试给出的估算,不是所有工作流都能直接兑现的折扣。Prompt 结构、effort、缓存、工具调用和重试率都会改变结果。
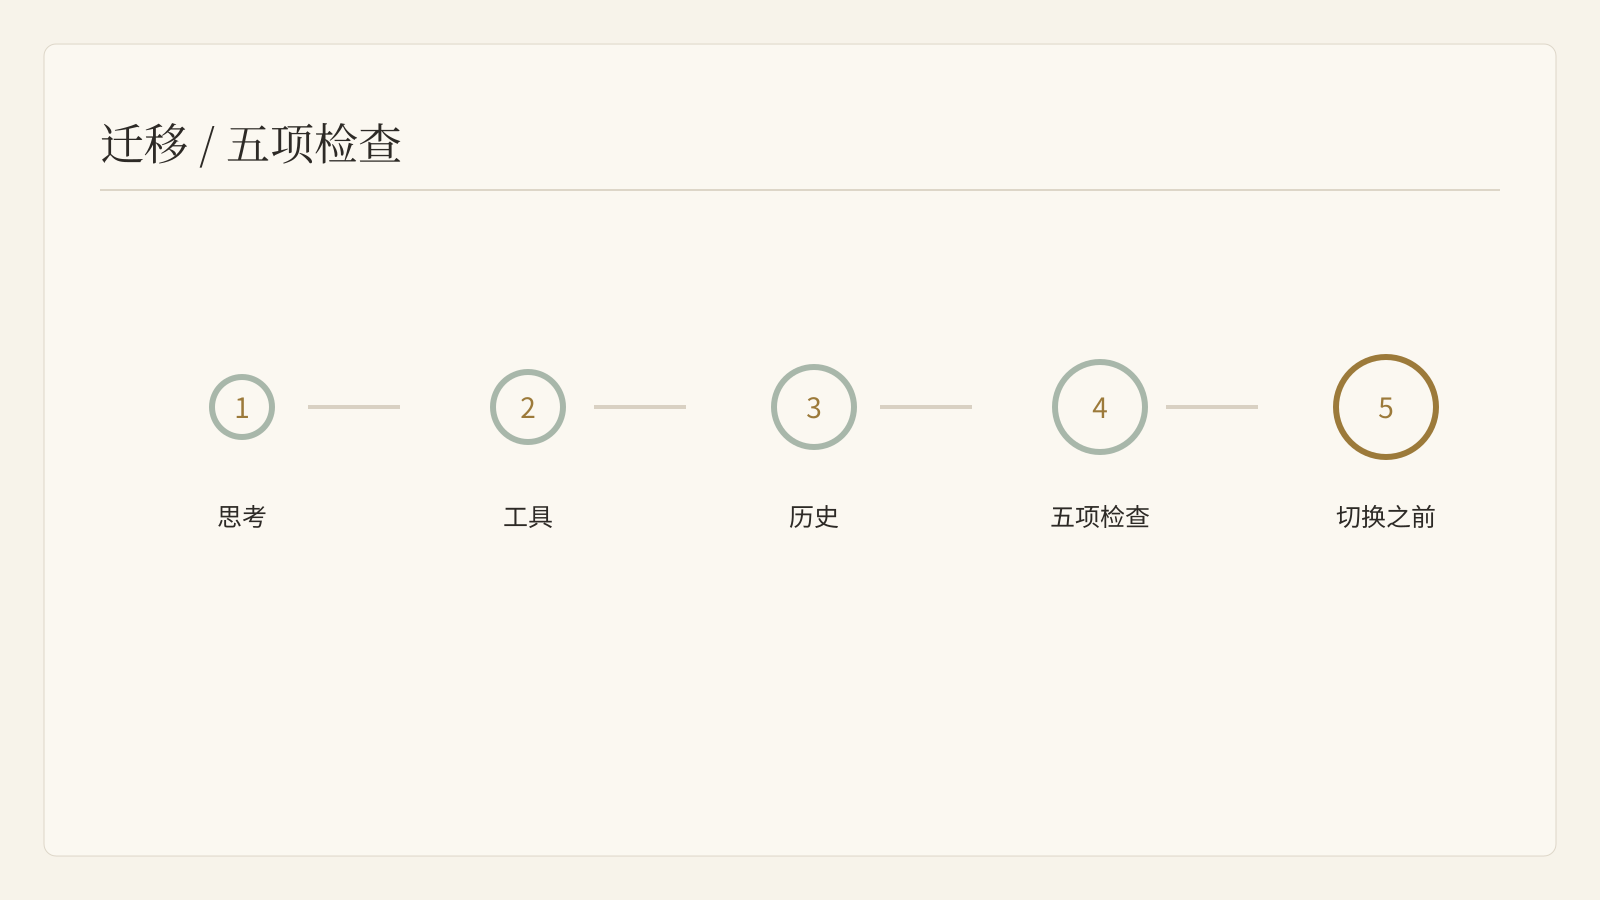
最大变化不在 benchmark
一个 Agent 工作流不只有模型。Harness 决定放入什么上下文、开放哪些工具、执行什么权限、如何回传工具结果,以及任务要拿出什么证据才算完成。
Opus 5.5 改了其中几个关键接口。
Thinking 不能再关
Adaptive thinking 始终开启。你可以用 effort 控制深度,但发送 thinking: {"type":"disabled"} 会报错。
如果现有工作流为了节省成本或兼容旧解析器而关闭 thinking,就必须重测。Thinking token 即使不展示给用户,也会按输出 token 计费,并计入 max_tokens。迁移时既要看费用,也要看是否更容易被截断。
Opus 5.5 默认使用 medium effort。为了追求发布页上的最高分,一上来就把所有任务调到 max,并不是稳妥做法。先从默认档开始,只有验收测试证明质量确实不够时,再提高 effort。
强制工具调用可能直接报错
Opus 5.5 不接受强制 any 或指定工具名称的 tool_choice。Anthropic 建议使用 auto,配合 strict tool definition 或 structured output。
如果现有循环假设“这一轮必须调用某个工具”,迁移测试必须覆盖这条路径。不要等到定时 Agent 在生产环境连续返回 400 才发现。
Computer use 要切换到新 toolset
在 Claude API 和 Google Cloud 上,Opus 5.5 不接受旧的 computer_20251124,需要使用 computer_toolset_20260801。
这是请求协议兼容性,不是 Prompt 写得好不好。Benchmark 也无法替你检查浏览器或 computer harness 用的是哪一版工具。
Thinking block 变成会话完整性的一部分
Opus 5.5 使用 preserved thinking。签名 thinking block 之前的 system instructions、tools 和 messages 必须保持不变。随意重建、改写旧会话历史,可能让 block 失效。
长时间运行的 Agent 应尽量把历史当作 append-only 数据,或者使用 Anthropic 支持的 context management 机制。状态会更明确,但“为了省 token 手工改一下旧消息”会更危险。
进度文字可能突然消失
默认 display: "omitted" 时,工具调用之间的进度更新可能进入 thinking block,但文本为空。原来依赖这些中间文字展示“Agent 正在做什么”的界面,看起来会像卡住。
Anthropic 提供了 beta 的 updates display mode,让产品只显示面向用户的进度,不暴露 reasoning summary。这是产品集成问题,不是模型分数问题。
发布说明证明了什么,又没证明什么
Anthropic 报告 Opus 5.5 在 Agent 编程、computer use、知识工作和业务流程上提升明显,也表示它在自动行为审计中的表现好于 Opus 5,并在一项边界测试里更少尝试越过 containment boundary。
这些是有价值的一手证据,但不能推出“所有工作流都更安全、更准确”。Anthropic 自己也提醒,前沿模型之间的 benchmark 差距越来越难直接映射到真实使用;发布页里不少结果来自高 effort 或 max effort,部分评测还会受 safeguard fallback 影响。
真正的问题不是“它赢了几个榜单”,而是“在我们的工具、权限、数据和验收标准下,它能不能产生更多被接受的结果”。
一次公平的迁移测试
找一个已经有 Opus 5 稳定基线的工作流。可以是仓库修改、带来源的研究报告,或者从表格到演示文稿的交付。固定输入文件、工具、时限、权限和验收清单。
先用 Opus 5.5 默认 medium effort 运行。记录总输入、总输出、cache read、工具次数、重试次数、总耗时和审核修改量。只有没过验收时,再提高 effort。
审核人要检查产物,而不是相信模型说“完成了”。代码任务看 diff、测试和日志;研究任务核对关键数字与引用;业务文档检查结构、事实和模板是否真的满足要求。
有效的结论不是“新模型感觉更聪明”,而是“通过率提高、审核时间下降,或每个被接受产物的总成本下降,同时严重错误没有增加”。
为什么工作流层仍然重要
Buda 把文件、浏览器、终端、tool calls 和最终 artifact 放在同一个可检查的 workspace 中。这样评测模型时,团队比较的是通过验收的结果、失败循环和审核成本,而不是排行榜。
FAQ
Opus 5.5 比 Opus 5 便宜吗?
Anthropic 的标准 API 目录价从 Opus 5 的输入每百万 token 5 美元、输出 25 美元,降至 Opus 5.5 的 4 美元和 20 美元。单价降低 20%;具体任务还要把缓存、思考输出、重试和工具循环算进去。
Opus 5.5 的上下文更大吗?
没有。Anthropic 当前文档中,两者都是 100 万 token。5.5 的重点更偏向效率、行为和集成接口,而不是扩大上下文数字。
所有 Opus 5 工作流都该立刻升级吗?
不该。先验证请求格式、工具循环、computer-use 版本、历史处理、成本和最终产物,再决定是否迁移。
在 Buda 中使用 Opus 5.5
Buda 用户可以直接在 Agent 模型选择器中选择 Claude Opus 5.5,正式模型 ID 为 claude-opus-5-5。此前保存的 Opus 5 模型选择会自动升级为 Opus 5.5,不需要重建 Agent,也不会移除现有文件。上文的 API 迁移规则针对直接接入 Anthropic 的开发者,不是每位 Buda 用户都要额外执行的配置步骤。