Claude Opus 5.5 价格详解:为什么 4/20 美元不等于一次 Agent 任务成本
Token 单价只是第一层,effort、缓存、重试、工具与审核共同决定任务总成本。

Claude Opus 5.5 价格详解:一次 Agent 任务到底要花多少钱?
一次任务连续调用模型十几次,最后还要有人检查和返工。看到 Opus 5.5 输入每百万 token 4 美元、输出 20 美元的目录价,并不能据此估出这次交付的成本。决定账单的是上下文怎样重复、工具循环走了几轮,以及最后的产物有没有过验收。
先把单价算明白
按 Anthropic 公布的标准 API 价格,Opus 5.5 的输入和输出分别是每百万 token 4 美元与 20 美元;Opus 5 是 5 美元与 25 美元。单价降低了 20%。缓存读取的价格分别是每百万 token 0.20 美元与 0.50 美元;Opus 5.5 的五分钟和一小时缓存写入分别是 5 美元和 8 美元。使用 Fast mode 或 Batch,则要按各自价格和处理时延重新算。
Anthropic 还称默认设置下的典型任务成本下降约 40%,并称输出速度提升超过 30%。前者不只是“单价打八折”,还包含其测试中使用的 token 和步骤变化。这是厂商测试结果;团队自己的任务如果重试增加、缓存失效或验收率下降,账单不会自动下降 40%。
一次任务为什么会把同一份材料付费多次
以修改一个中型代码仓库为例:Agent 首先阅读需求和仓库规则,随后搜索文件、修改代码、运行测试、读取错误,再改一次。每轮都可能带上系统指令、工具定义、已有对话、代码片段和测试输出。不是只有最初的问题消耗输入 token;失败后的重复上下文也在计费。
缓存可以降低重复读取稳定材料的成本,但要记录实际命中率和写入次数。过早拆分缓存前缀、频繁调整工具定义或反复注入整份仓库,都可能让预期中的缓存优势消失。长上下文是容量,不是应把全部历史放进每一次请求的理由。
输出也不只包括屏幕上看到的最终答复。Opus 5.5 的 adaptive thinking 始终开启,effort 可以调节思考深度;思考 token 消耗输出预算。默认 medium effort 是一个可复测的起点,先用真实任务验证,再决定哪里需要提高。
用一张任务账本代替价格印象
对每个任务,至少分开记四笔:模型费用(含输入、输出和缓存)、付费工具或外部 API、运行时间,以及审核和返工。再记录提交了多少次、测试通过了几次、最终有多少产物被接受。
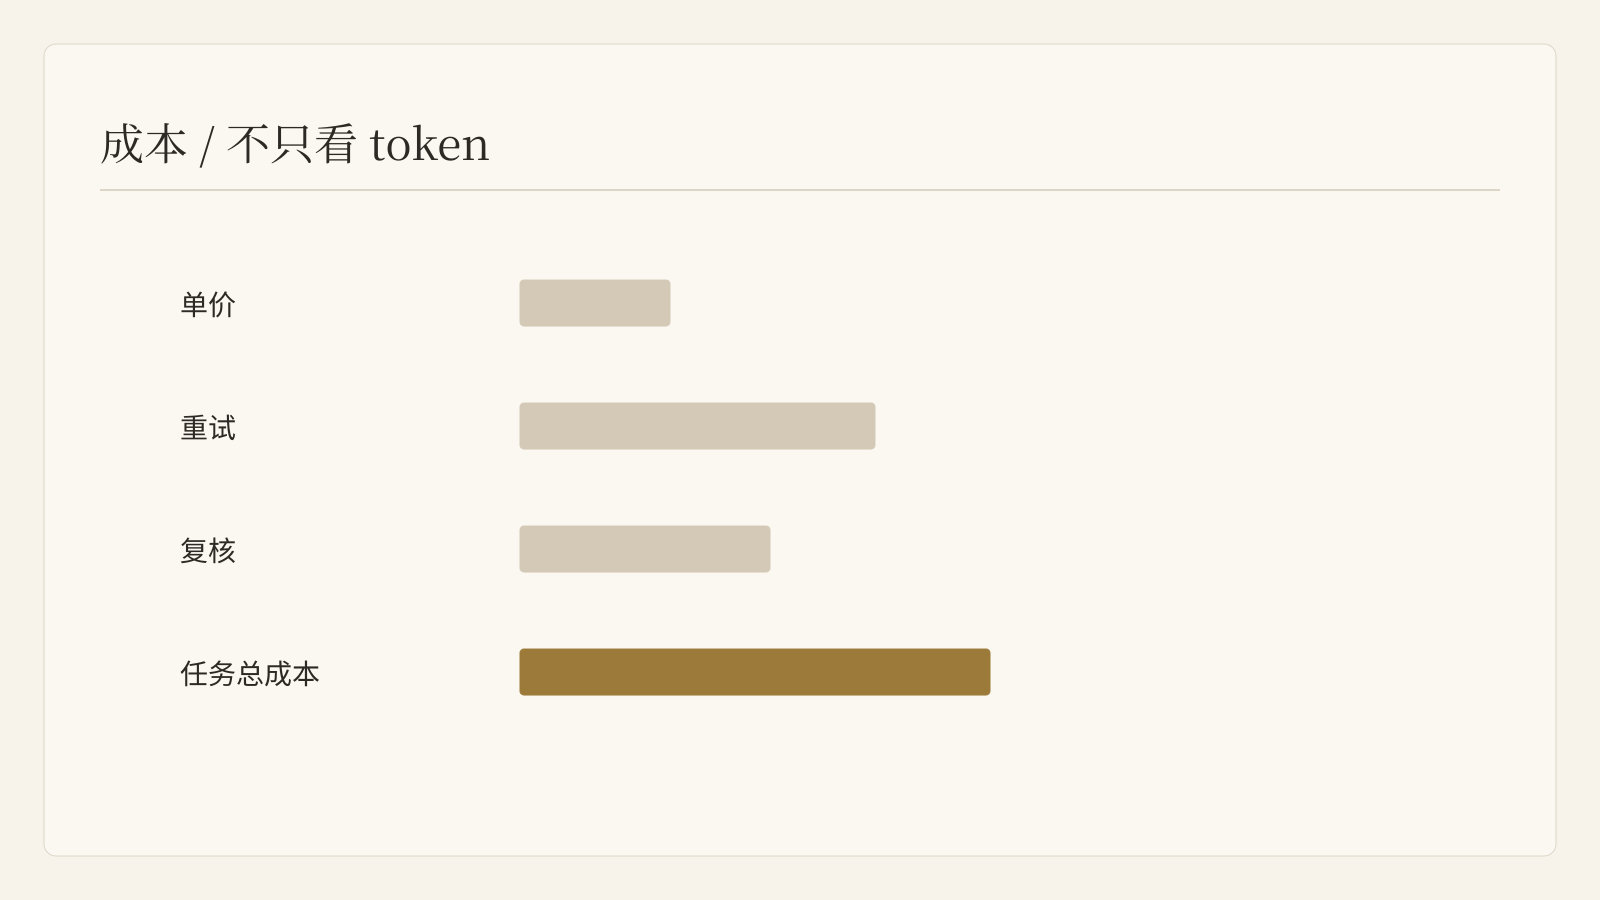
一个实用口径是:每个通过验收的产物总成本 = 全部尝试的模型与工具成本 + 审核返工成本,再除以最终通过验收的产物数。如果五次尝试只交付三份可用结果,不能拿五次请求的平均价格冒充“每份交付成本”。人工时间也不要随手折成 token;两项应同时展示,内部需要做采购决策时再按本团队的人力口径折算。
同一任务怎样公平比较 Opus 5 与 5.5
选取已经做过、有验收标准的任务,而不是专门为新模型写的演示提示词。固定材料、工具权限、时限和测试;分别记录两种模型的输入、缓存读取、输出、工具调用、失败循环、总耗时、审核修改量和最终通过率。高风险任务还要记录严重错误,不能用便宜抵消不可接受的错误。
可以按任务分组看:仓库级代码修改看补丁、测试和回归;资料研究看事实和引用;跨应用流程看中途失败能否恢复;业务材料看成稿是否满足模板和审批。每组先在默认或相近的 effort 设置下比较,再针对明显受益的任务提高 effort。不要用厂商各自的 benchmark 百分比替代自己工作流的验收记录。
什么时候值得用 Fast mode 或缓存
如果客服响应、现场协作或实时操作的延迟本身影响业务结果,才有必要比较 Fast mode 的加价与等待时间。能排队的批量处理可以测 Batch 的费率,但要把交付时限列进验收。重复使用的规则、工具说明和背景材料适合评估缓存;经常变化的任务输入则要按实际命中率决策。
Buda 的文件、终端、浏览器和产物记录可以把执行过程与审核结果留在同一处。采购判断仍应基于真实交付:任务通过率、全部调用成本、失败恢复和审核时间,而不是模型选择器里的一行单价。
Buda Credits 与使用权限
Claude Opus 5.5 已面向具有有效付费订阅的 Space 开放。仅购买额外 Credits 不会替代这个订阅模型所需的访问权限。
Buda 展示倍率为 1.3×,相对 Claude Sonnet 5 的 1.0× 基准。它不是每个任务的固定扣费;实际 Credits 取决于输入、输出、缓存、工具调用和最低扣费规则。Anthropic API 美元价格属于另一套计价体系。