
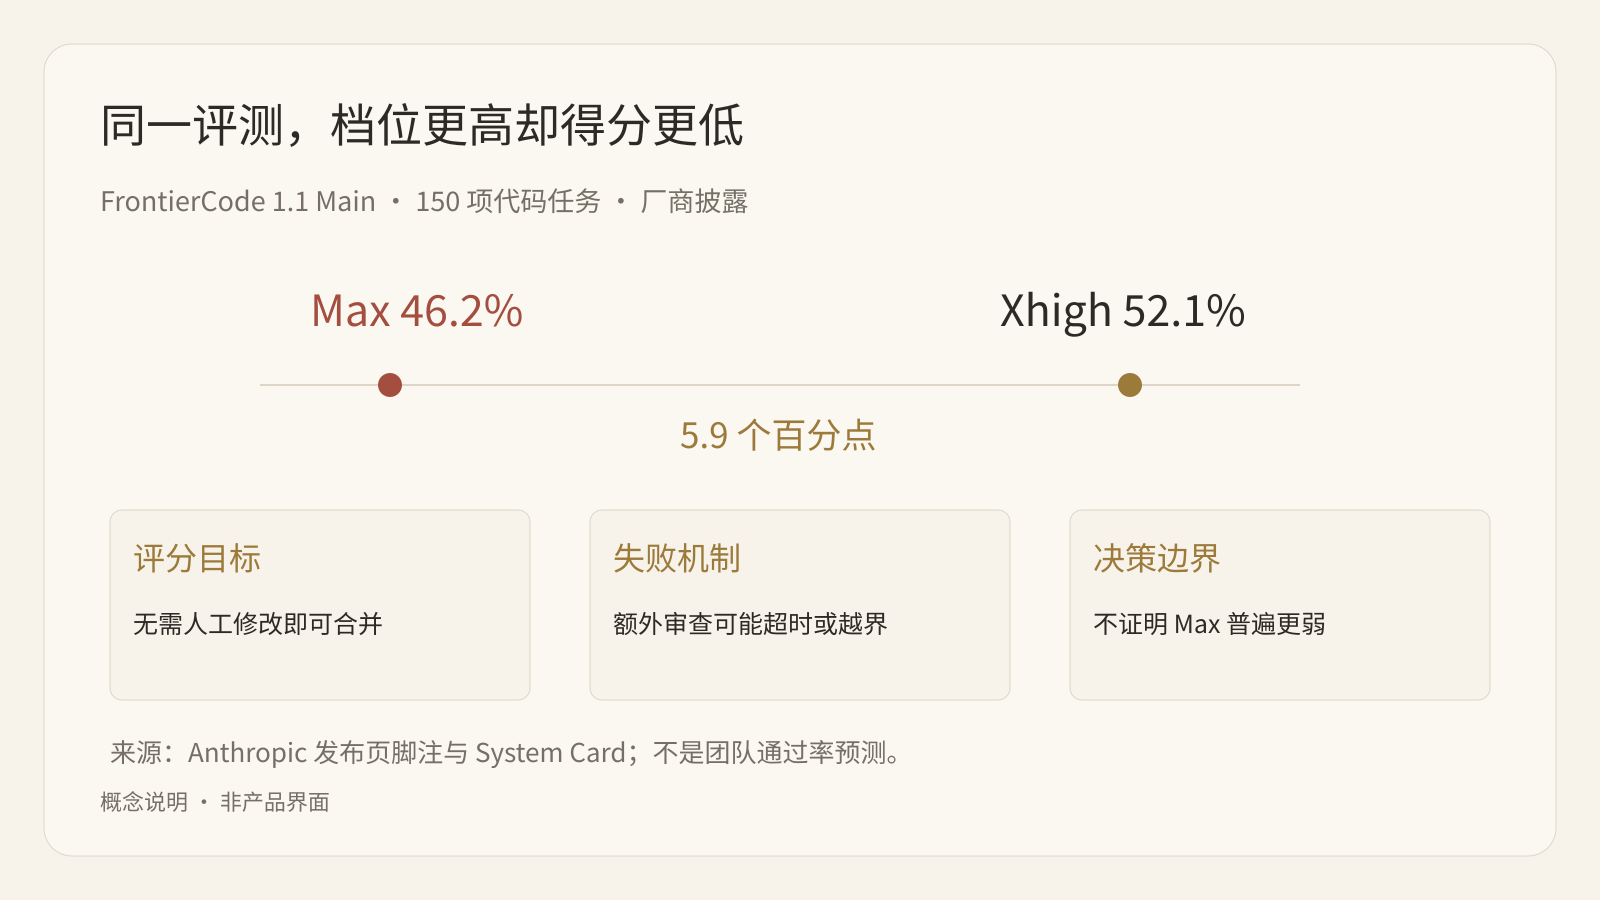
Anthropic 公布的 FrontierCode 1.1 Main 结果里,Claude Sonnet 5.5 在 Xhigh effort 下得到 52.1%,Max 下却是 46.2%。更高档位没有得到更高分,差了 5.9 个百分点。
这个结果关乎 Agent 如何完成工作,而不只是“想得够不够久”。FrontierCode 评估无需人工修改即可合并的代码;超出任务范围的修改,即使本身不错,也会被惩罚。选 effort 时,完成标准和停止条件需要与推理深度一起考虑。
这次落差,发生在什么样的评测里?
系统卡介绍,FrontierCode 来自 Cognition 的 150 个软件工程任务,基于开源仓库的真实 PR。Agent 拿到仓库、问题说明和测试规范,在没有人工介入的容器里完成补丁;评分同时检查阻塞性的功能条件和代码质量要求。
发布页的脚注进一步解释:Max 下 Sonnet 5.5 更常启动 Claude Code 的 code-review skill,让多个子 Agent 分头审查。Cognition 检查的两个案例中,这造成了超时,或引入任务范围之外的修改。
所以,这组数字支持的结论是:在该评测及执行环境里,更多自主审查可能损害最终可合并性。它不是“Max 普遍更弱”的证据,也不是所有模型、所有工作流都该使用 Xhigh 的理由。
Effort 会影响执行方式,不只是答案长度
官方提示文档指出,较低 effort 在长任务里可能更早停下来询问用户;Low 下也可能跳过实际验证。较高 effort 则可能开展额外审查、补充文档或改动相关文件。
这两种失误方向不同。前者把未完成工作交回给人,后者把明确任务扩大成未经授权的项目。单看生成速度或 token,容易把“少做了必要检查”误判为高效率,也可能把“多做了不需要的事”误判为更负责。
先把任务分成三部分:必须完成的交付物、必须执行的检查、必须停止或请示的边界。例如修一个导出错误,要求改动相关逻辑、运行覆盖该行为的测试并报告结果;不自动增加新功能,不顺手重构其他模块。评估 effort 时,必须同时检查这三部分。
起点可以不同,但不能继承旧档位的含义
Sonnet 5.5 重新校准了 effort,同名档位不等于 Sonnet 5 的同一思考量。官方建议:Claude API 一般从 High 开始;边界明确的 Agent 编码、多步工具任务从 Medium 开始,较难或更长的任务再试 High;低延迟聊天可从 Medium 或 Low 开始。
Xhigh、Max 应留给已经测得质量收益的任务。两者需要 adaptive thinking,不能与 between_tools 配合。这里说的是上游接口与提示建议,不是 Buda 模型选择器的默认值或可配置项。
一个团队可以维护“任务类型 → 初始档位 → 验收条件”的表,而不是全员固定 Max。报价资料整理、长文推理、代码修复的失败成本不同,最佳起点也不应由一个排行榜统一决定。
用停止规则约束额外工作,而不是禁止必要检查
提示可以这样写:
完成指定修改后,运行能够覆盖该行为的实际检查;检查通过后停止并报告。不要自行启动额外 reviewer 子 Agent、扩展功能或修改无关文件。如认为更深的审查必要,列为建议。若检查无法运行,写明未运行项与原因,不得把任务标为已验证完成。
这不是让 Agent 少负责,而是让职责可验收。必要测试仍要执行;新增审查则需要授权。对高风险任务,可以明确把独立复核设为要求,不必一概禁止。
Anthropic 的提示测试还报告,在 Max 编码任务中,限制自行启动 reviewer 子 Agent 的指令使会话成本降低约三分之一,质量没有变化。这是该厂商测试的结果,不是通用折扣,也不是 Buda 测量。可复制的是控制变量的实验方法,而非承诺同样的节省。
一次校准实验,至少记录这五列
选一组代表性任务,固定输入、工具权限、提示、时间预算和验收规则,在两个或三个相邻档位重复评估。每次从相同起始状态出发,避免前一次产生的文件或缓存结果污染下一次。
记录:验收是否通过、是否超范围、端到端时间、实际执行消耗、人工返工。低档位快但没通过,不能算低成本交付;高档位通过但附带未经授权的写入,同样不能直接算成功。
若要合并成成本指标,可在同一计费口径里计算“全部尝试成本 / 通过验收的任务数”,并把人工返工另列。全失败的一组没有可计算的单次成功成本。美元、Credits 和人工分钟不能不经换算就相加。
对交互式工具会话,官方还提示修改顶层 effort 会使 prompt cache 失效;按轮次调整的 beta 功能需要 adaptive thinking。做实验时,应记录缓存与会话策略,否则可能把缓存差异当作档位差异。
便宜的一次尝试,可能对应更贵的一次交付
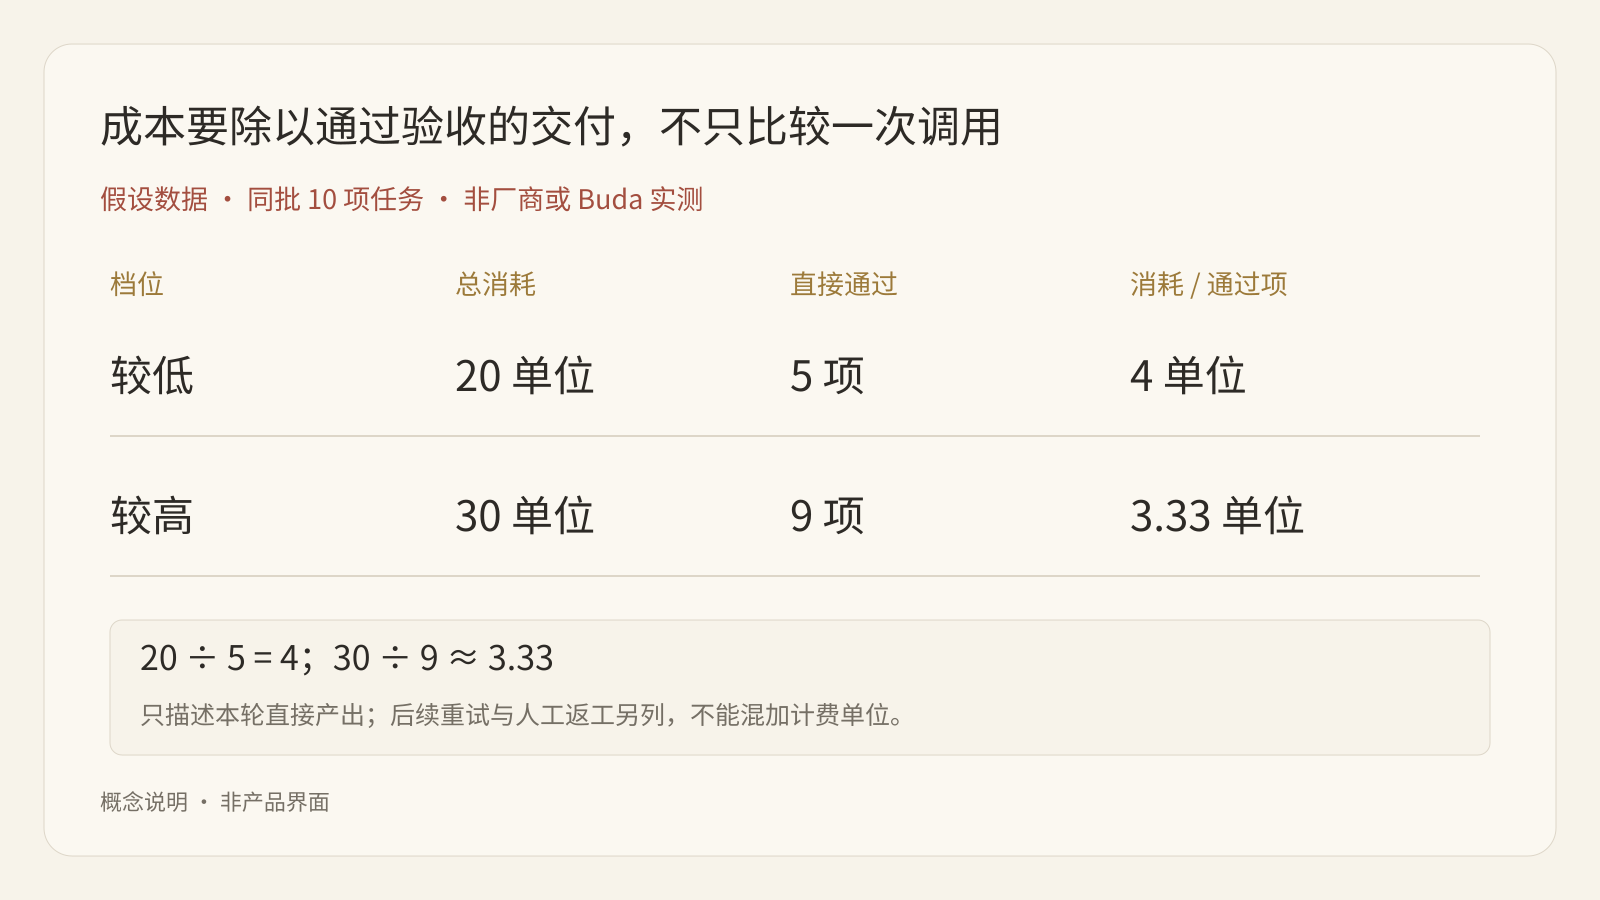
下面是一组用于说明计算方法的假设数据,不是 Anthropic 或 Buda 的实测。把 10 项独立任务分别交给两个档位,每项只运行一次,输入、工具和验收规则相同。
| 本轮实验 | 较低档位 | 较高档位 |
|---|---|---|
| 全部尝试的执行消耗 | 20 单位 | 30 单位 |
| 无需返工且满足范围约束的任务 | 5 项 | 9 项 |
| 每项尝试平均消耗 | 2 单位 | 3 单位 |
| 每项直接验收交付的消耗 | 4 单位 | 约 3.33 单位 |
较低档位的单次消耗少三分之一,但直接可用的产出少得更多。这里计算的是这一轮的“消耗/直接验收产出”,不是尚未运行的重试成本,也不是最终把 10 项全部交付的成本。要回答后一个问题,还得跟踪失败任务的后续尝试和人工修复。没有这些记录,不能承诺一组数字代表完整项目预算。
反过来,高档位也可能因为范围扩大而落败:必要测试已通过,它继续修改公共模块、重写文档或运行额外审查,消耗增加且引入新风险。这时该修的首先是权限、任务范围和停止条件,而不是把“认真”一概调低。
用失败分类决定下一轮,而不是只看平均分
校准记录应把失败拆开。相同的“不通过”,可能对应完全不同的处理方法:
- 缺输入: 没有给出正确接口说明或期间。先补材料,升档无法可靠补出未知事实。
- 验证缺失: 改了代码但没运行要求的测试。明确工具可用性和完成条件,再比较档位。
- 判断不足: 输入充分、检查可运行,仍漏掉关键约束。可以试升档,但用相同验收标准验证收益。
- 越界执行: 修复目标之外改了文件、字段或业务规则。收紧范围与授权,不把更多修改当成更高质量。
- 提前请示: 长任务中停止并询问。判断是合理的授权边界,还是明确任务尚未完成;只有后者应计为完成能力不足。
在一个业务流程中,平均值还可能掩盖重要少数。九份摘要合格、一份关键合同漏掉责任条款,不能因为整体通过率高就自动扩大使用。高风险任务可设置独立人工复核,不让统计上的平均通过替代逐项责任。
把校准结果写成一条有条件的运行规则
可复用的规则不是“所有任务 Medium”,而是“输入完整、只读工具、明确交付清单的资料整理从 Medium 起;关键字段缺失时停止;通过来源和字段检查才交付;多轮仍无法满足标准时按约定升级或交人工”。这是一条建议的流程规则,不是模型能力保证。
修改档位、提示或工具权限后,应重新跑保留的回归样本。比较时至少记录模型 ID、平台、档位、提示版本、工具版本、是否新会话以及缓存状态;无法保持条件一致的实验,先用于发现问题,不做精确的节省比例宣传。
需要区分两个默认语境:Claude Platform/API 与 Claude 应用、Claude Code 的默认设置不应混写。本文引用的 High 是 API 提示文档口径;它不意味着其他客户端默认 High,也不意味着 Buda 暴露同名控件。团队自己的实验要记录实际设置,不能用推测的默认值填表。
从“最大档位”改成“最小充分档位”
日常流程先选能稳定满足验收标准的最低档位,再给复杂任务升级。无法通过时,先看失败类型:缺输入要补材料,权限不够要调整授权,停止太早要明确完成条件,推理不足才可能需要提高 effort。
Buda 可以承接 Agent 的执行环境与可复用流程;把输入要求、工具边界和验收清单写进流程,比每次口头要求“认真一点”更容易复查。这里建议的是工作流设计,不是声称 Buda 自动提供这组 effort 控件或复现了上游跑分。
FAQ
Max 应该被禁用吗?
不应该。复杂任务可能受益,前提是在自己的任务与执行环境里测得增益。
Xhigh 的 52.1% 可以预测团队通过率吗?
不可以直接套用。它来自特定代码任务、评分规则和工具环境。
降 effort 就一定省钱吗?
一次尝试可能更便宜,但失败、重试和返工会改变最终交付成本。
不让额外审查,会漏掉必要测试吗?
停止规则应明确要求必要检查通过,再禁止未经请求的新增审查。两者不能混为一谈。