
Buda 的 Gemini 模型迎来 Gemini 4 Argon,支持 Low、Medium、High 三档思考深度。在 Agent 的聊天输入框选择模型,再按任务难度调整思考档位,不必为换一个模型重建工作空间。
这次更新最实用的变化不是让每次回答都更长,而是让你决定:哪些工作尽快做完,哪些问题值得多花一些推理。
三档怎么选?
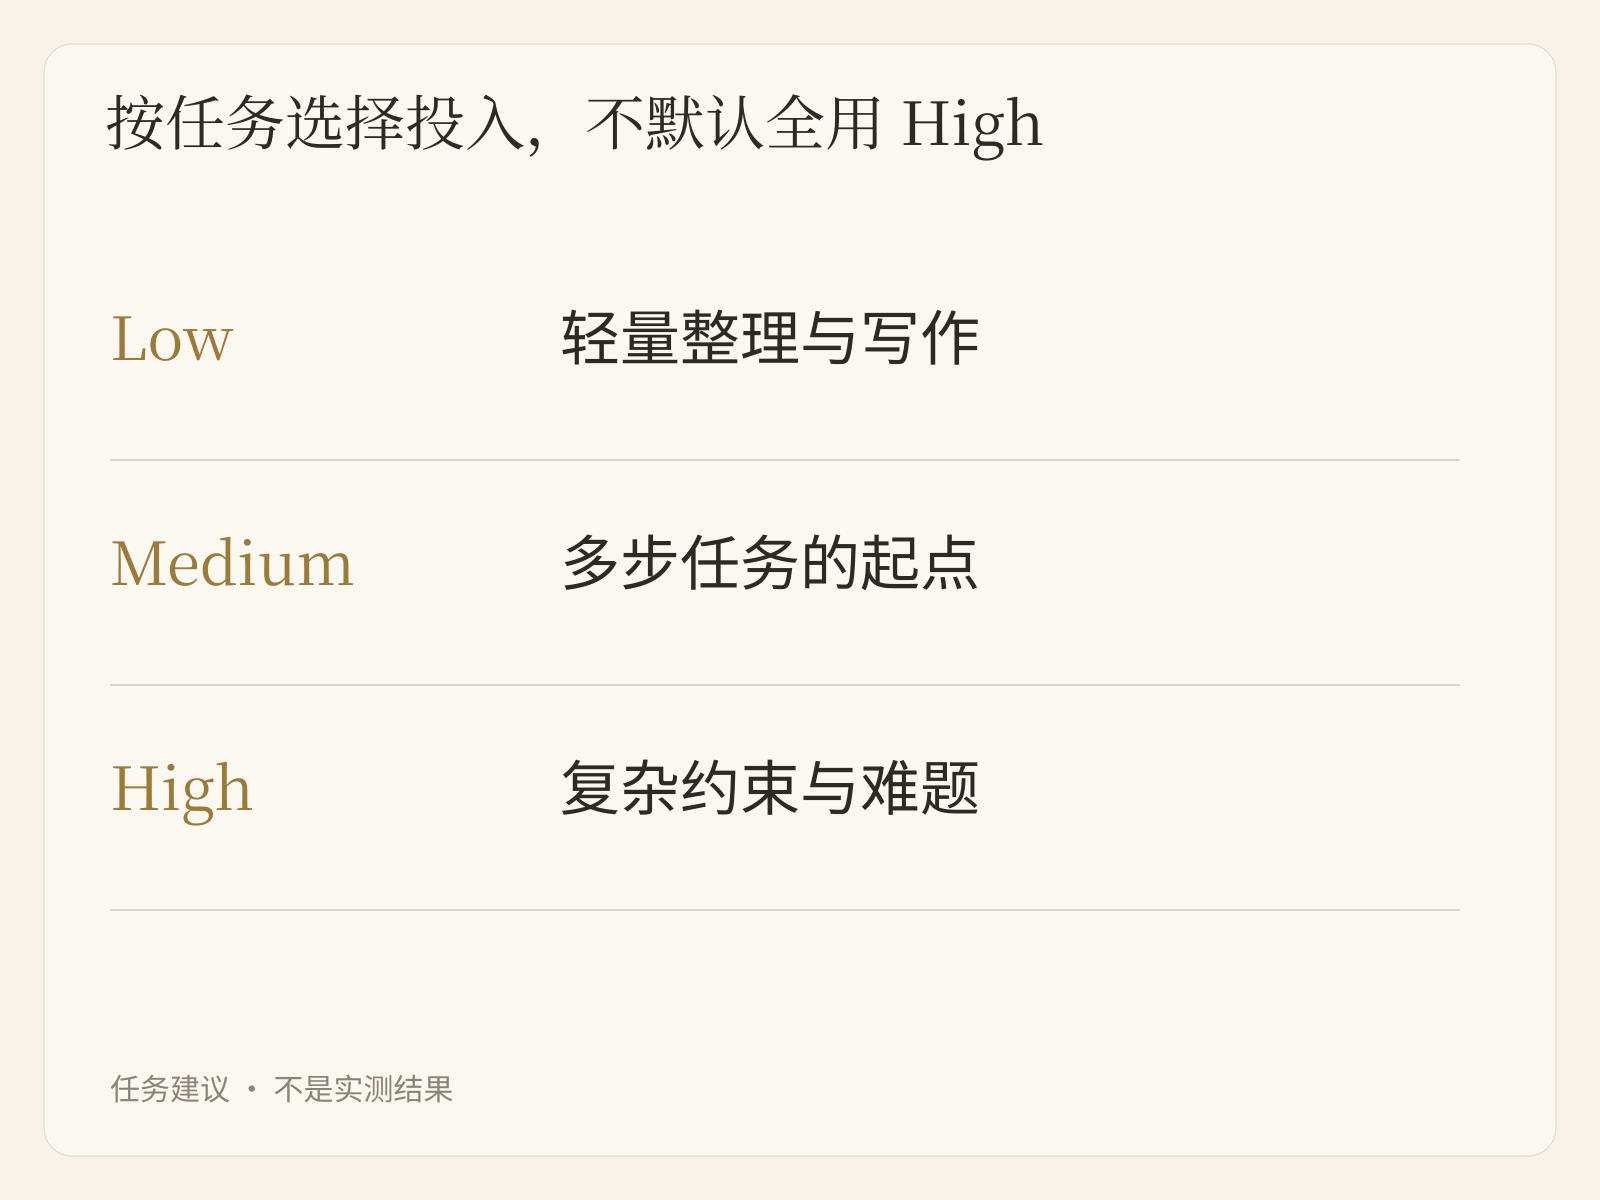
Google 将 Argon 定位于复杂代码、Agent、多步数学与科学问题,并在模型说明中建议:用实际任务评估三档,选择能达到质量标准的最低一档。
| 档位 | 适合从哪里开始 | 检查重点 |
|---|---|---|
| Low | 清晰材料的整理、轻量分析与写作 | 信息是否遗漏,格式是否符合要求 |
| Medium | 多份资料比对、常规代码与多步任务 | 推理是否连贯,依据是否支撑结论 |
| High | 棘手代码、复杂约束、难数学与科学问题 | 关键假设、边界和验证结果 |
Medium 是 Google 推荐的通用起点。High 通常消耗更多 token,首个输出也可能更慢;它适合难题,不是所有任务的默认升级。表中的任务选择是使用建议,不是 Buda 实测的速度或成功率。
给复杂工作更多空间,不把长输出当交付
Argon 的输入、思考与输出共享 1,048,576 tokens 的总窗口。它不是“百万输入再加百万输出”,也不是 Agent 的永久记忆。本次 Buda 接入的输出上限配置为 65,536 tokens。
Google 的 long decode 能在特定 API 路径下延长单次生成;这不意味着 Buda 模型选择器开放了百万 token 输出。日常使用先看任务需要:跨文件审阅需要保留材料关系,代码修改需要测试与差异,研究需要来源和待确认项。最终交付包仍应清晰可查。
更大的窗口也不保证所有 Drive 文件会自动全部进入某次请求。把必要文件和任务范围指清,比一次堆入无关材料更有用。
在原有 Agent 里开始
- 打开承担任务的 Agent,在聊天输入框的模型选择器中选择 Gemini 4 Argon。
- 先从 Medium 开始;轻任务尝试 Low,复杂推理再比较 High。
- 指定已授权的资料、输出文件、核验标准与禁止动作,再运行任务。
- 检查实际产物、依据和未完成项,决定保留当前档位还是调整。
换模型不会另建一套 Drive。现有文件、背景和流程仍属于原 Agent 工作空间;模型选择与工具权限是两件事。读写、外发或部署的授权不会因选择 High 自动扩大。
用一份有明确终点的任务试用
例如,让 Agent 对照一份产品变更说明和现有操作文档,找出需要修订的段落:
只读指定的变更说明与操作文档。列出受影响段落、对应依据、建议修改和待确认问题,保存修订草稿。没有依据的内容不要补成事实。不改正式文档,不外发、不发布。最后给出草稿位置与需要人工决定的事项。
这是建议试用,不是已完成的演示。用同一批材料比较档位时,关注遗漏、错误、返工和等待时间,不只看答案长度。产物达标后再扩展范围。
Agent Workspace把对话、文件和执行工具放在一起;Drive 与记忆保留下一次工作可以继续使用的资料。模型负责本次推理,持续工作还需要这些上下文和可复用流程。
常见问题
是否需要新建 Agent?
不需要。直接在现有 Agent 的输入框选择模型,继续使用已授权的工作资料。换模型不会建立新的文件权限边界。
High 一定比 Medium 更合适吗?
不一定。先固定材料和验收标准,比较错误、遗漏和返工。Medium 达标就不必为简单任务增加推理投入;High 也不能代替事实核查。
能一次输出百万 token 吗?
本次 Buda 接入配置的输出上限是65,536 tokens。Google 的共享窗口与 long decode 是不同概念,不能把上游扩展能力直接当成当前聊天出口的上限。
Credits 怎么看?
当前 Buda 价格页列出的 Gemini 4 Argon Credits 倍率为 0.7x。倍率用于模型间的相对消耗比较,不是每次任务的固定扣费。
以Buda 价格页和账号内实际用量为准。输入、输出、缓存、工具调用和最低扣费规则共同影响消耗,思考档位也会改变 token 使用。先用一个范围明确的任务比较结果与用量,再决定是否常用。
从一件需要认真判断、又能明确验收的工作开始。选择合适的档位,把资料与交付要求说清,让 Agent 执行,再检查结果。