
一次评测调用返回 finish_reason=CONTINUATION,可见正文却为空。脚本把它判成失败,再发一句“继续”,随后得到另一条生成轨迹。问题不是模型忘了说话,而是客户端把同一次生成的续接误当成了新的对话。
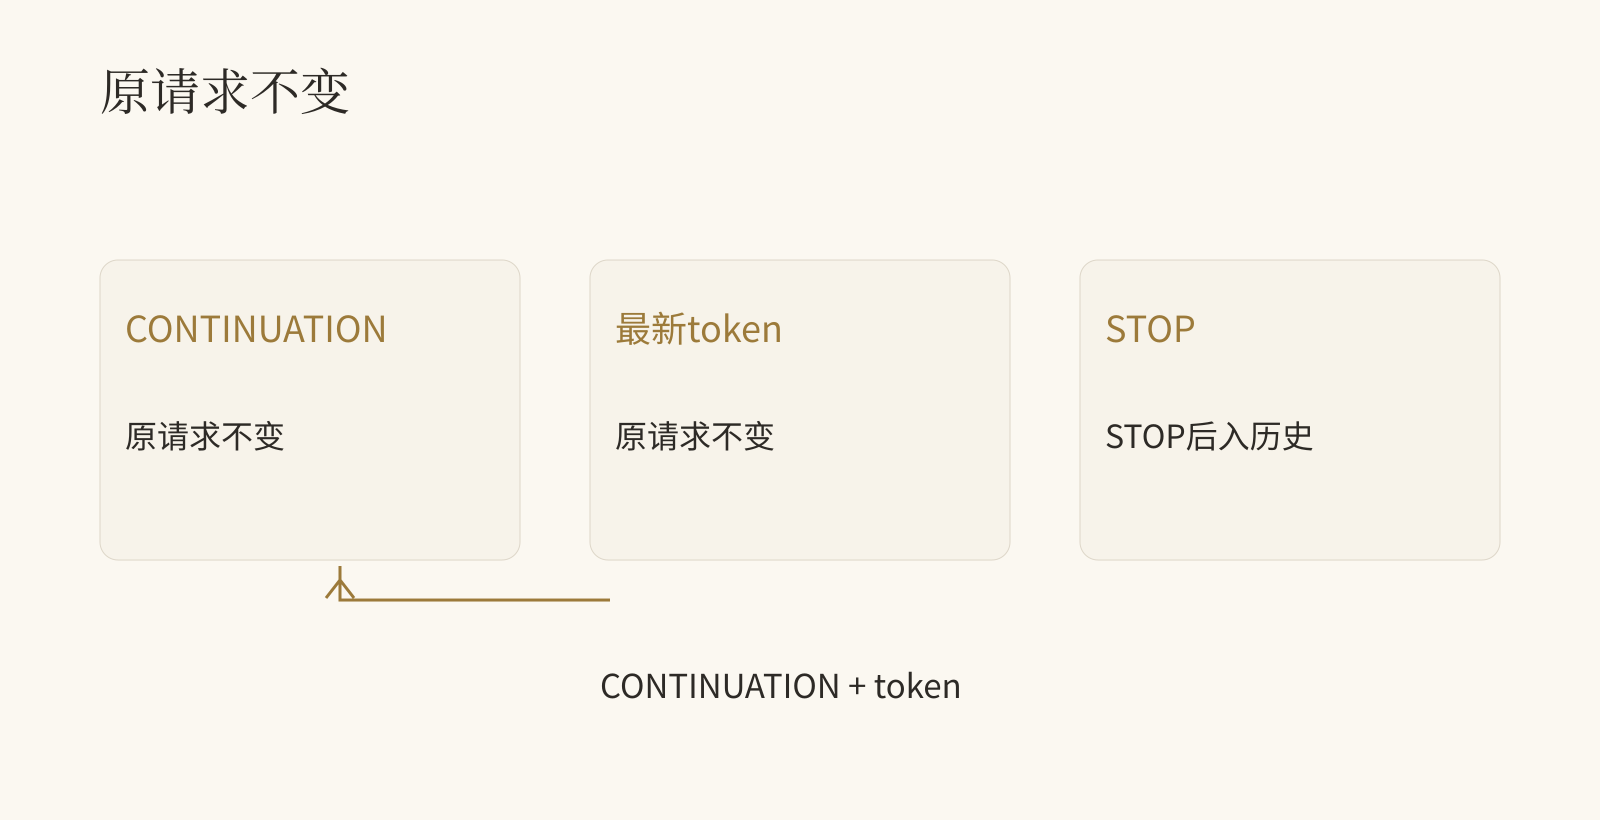
Gemini 4 Argon 的 long decode 用 continuation token 恢复生成状态。自管客户端需要携最新 token 重送原请求;多数应用可以让支持该协议的 Google Gen AI SDK 负责续接。
一个总额度,拆成多次请求
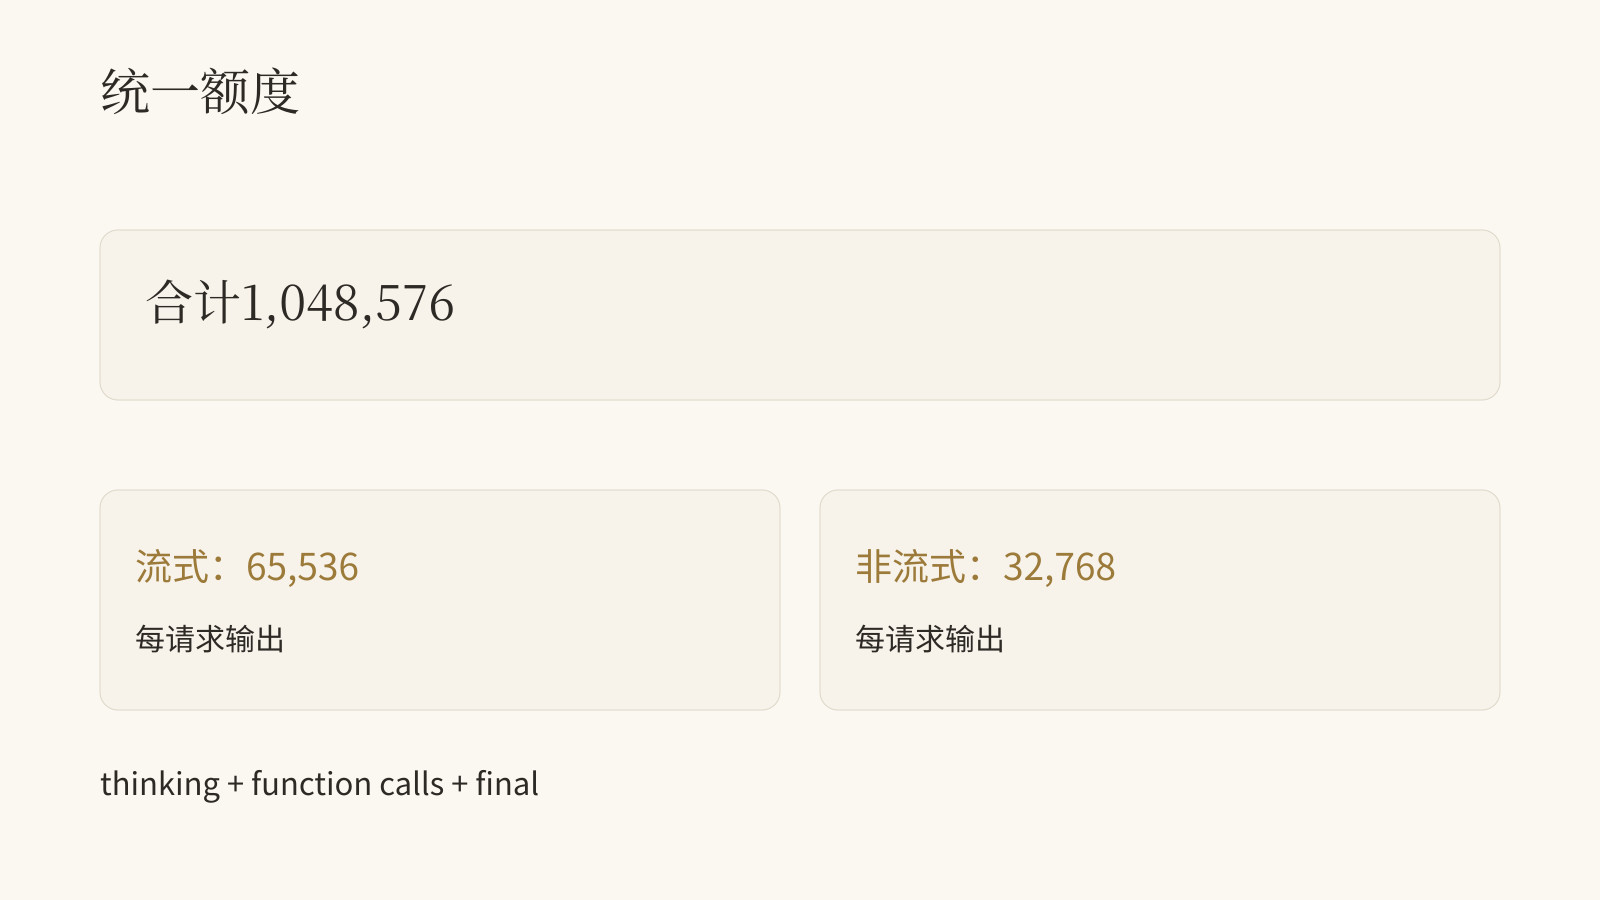
开发者指南规定,输入和输出共享 1,048,576 token。输出包含 thinking、函数调用和最终正文,不是输入一百万再加输出一百万。
流式单段最多 65,536 输出 token,直接 HTTP 非流式单次最多 32,768。Long decode 把一次生成拆成多次请求,仍受统一额度与请求输出预算限制。假设输入占 200,000 token,算术上剩余输出上限为 848,576;这不是实际生成长度预测。
10 月 13 日公告给出发布背景。迁移客户端时,先看当前协议与响应字段,不把能力榜单当接口说明。
先决定谁负责续接
| 路径 | 配置 | 边界 |
|---|---|---|
| Google Gen AI SDK | Python google-genai>=2.30.1,JS @google/genai>=2.29.1,合适的输出预算 | 支持自动续接;最终用量可能已累计。 |
| 自管流式 REST | v1beta1 的 streamGenerateContent | 自己处理 checkpoint、断流与分段统计。 |
| 自管非流式 REST | v1beta1 的 generateContent | 每请求最多 32,768 token,自己管理有界循环。 |
目前 GenerateContent long decode 只支持 v1beta1,不支持 v1。SDK 默认使用 v1beta1,显式改版本时要检查。Interactions API 不支持 long decode;通过 interaction ID 延续普通对话是另一种操作。旧 SDK 与 OpenAI compatibility layer 无法用这些 token 取得长生成。
需要 long decode 时,流式 max_output_tokens 超过 65,536,非流式超过 32,768。不要习惯性开到最大:低延迟聊天、提取和多数短工具轮次不需要这么长。
自管循环必须保留原输入
首次请求前冻结 contents、system_instruction、tools 和生成配置。续接时重送这些字段与最新 token,不追加部分输出,不换成“继续”提示词,也不半途改任务。token 包含原提示词 hash 与生成状态。
下面是控制流伪代码,不是已跑通的 API 客户端。extract、final_usage 等辅助方法需按实际 SDK 或 REST 响应实现。
original = immutable_copy(authorized_request)
latest_token = absent
for segment in bounded_segment_count:
    response = call_v1beta1(original, latest_token)
    save_redacted_segment_metadata(response)
    accumulate_parts(response)
    reason, token = extract(response)
    if reason == STOP:
        assemble_one_model_turn()
        finish()
    if reason == CONTINUATION and token exists:
        check_elapsed_time_and_total_budget()
        latest_token = token
        continue
    stop_for_explicit_handling(reason, token)
Thinking-only 段可能返回 parts: [{"text": ""}]。有 CONTINUATION 和 token 时,正文空不等于失败;token 缺失或 finish reason 异常,也不能进入盲重试。
带 token 的 MAX_TOKENS 表示请求的生成预算用尽。指南说明可提高 cap 继续,但提高预算应当是一项明确决定:记录截断,按获准新预算继续,不能偷偷加额度。只有 STOP 后才把所有段组合成一个 model turn,放进后续对话历史。
三种计数不要混起来
Python SDK 的 generate_content、generate_content_stream 最终响应或 chunk,其 usage_metadata 会累计各次续接的计费 token。不要把重复累计值再相加。
自管 REST 的用量在每请求内累计;取每次请求最终的 prompt、cached-content、candidate、thought 计数,再跨请求相加。不是把每个流式快照都相加。保留单请求账本与汇总,才方便对账。
续接会重新 prefill 已生成的片段,所以累计 prompt_token_count 会增长。原始上下文测量使用 initial_prompt_token_count,等生成结束、没有 continuation token 后再做 compaction。中途改历史会破坏原请求约定。
符合条件的连续续接可享隐式缓存上下文 95% 折扣:至少 6,144 token,文档 TTL 为 15–20 分钟。它不是整项任务打 95 折扣,thinking、输出及其他计费仍要算;缓存条件不满足时成本也会变。显式 context cache 不受支持。
旧参数要逐项移除
有效 thinking level 是 LOW、MEDIUM、HIGH;普通 Argon 默认 MEDIUM,cyber-permissive 默认 HIGH。thinking_budget、MINIMAL 返回 HTTP 400。frequency_penalty、presence_penalty、candidate_count 也返回 400;自定义 temperature、top_k、top_p 则被忽略,不能靠改它们可靠调优。
FunctionResponse 要与前一组 FunctionCall 的 ID、名称和顺序对应。工具执行与生成重试分开:断流不意味着已完成的付款、发送或数据库写入可以重做。
先测停止规则,再放大任务
建议用短响应 STOP、thinking-only 续接、多段原输入不变、预算耗尽、旧 SDK 或错误 endpoint、工具副作用之后断流六类样本。检查请求指纹、终止、用量汇总与副作用日志。这是建议测试,不是本次真实 API 实测结果。
把迁移清单和脱敏调用轨迹留在 Drive。Agent Workspace可承接文件与获准代码执行;是否支持协议取决于真实客户端,不从模型选择器或 wrapper 推断续接已实现。
哪些任务不用 long decode?
单次响应能在分段上限内完成的摘要、分类和短工具轮次。输入很大时,可留给输出的统一预算也更小。
为什么不能发“继续”?
新提示词会开启新的请求,不是恢复原生成状态。用 token 携原请求续接,完整结束后再把输出写入历史。
成本面板读什么?
Python SDK 取最终累计值;REST 取各请求最终值之和。标明统计方式并保留 segment ID,避免同一用量算两次。
先用小规模受控请求证明能续、能停、能算账,再增加输出预算。额度更大不是客户端自动更可靠。