
一项代码迁移可能需要读多轮性能分析、改写实现、运行测试,再回头修复回归。财务研究也不是写一份长报告:它需要查来源、比较口径、解释异常,最后交给人判断。
Google 在 2026 年 9 月 30 日发布 Gemini 4 Argon,把重点放在这些持续、多步骤的专业任务上。值得关注的变化是更长的执行轨迹,以及工程和知识工作中的具体实例。对准备试用的团队,接下来的问题是:选什么任务、留下什么证据、什么情况下才算通过。
公告说了什么,访问范围在哪里?
Google 官方公告将 Argon 描述为面向复杂工作流的前沿模型,涉及软件工程、法律、财务与网络防御。公告首先通过 Fairwind Program 向一批可信网络防御者开放,再逐步扩大测试与访问。
截至本文 10 月 8 日核验的公告,其广泛开放路线仍以逐步扩展为表述,并提到后续从付费 API 客户和 Google AI Ultra 订阅用户开始。这不是“所有人现在都能打开应用使用”的证据。具体入口、额度和是否获准访问,应以账户当时显示及最新产品文档为准。
本文讨论的是 Google 已披露的上游能力和试点方法,不从发布公告推断任何第三方产品的模型可用性或计费方式。
1M 是输出上限,不是上下文或永久记忆
公告明确把 输出 token 上限从 64K 扩大到 1M。这个变化意味着单次轨迹有更多生成空间,可能容纳更长的推理和多步工作,但它与能读入多少材料的上下文窗口不是同一参数,也不表示 Agent 自动具有永久记忆。
更长的输出并不要求人读完所有中间内容。试点应另外指定最终交付格式:简明结论、可打开的文件、变更列表、测试记录,以及需要人决定的事项。否则输出能力扩大后,审核负担也可能跟着扩大。
三个工程实例,告诉团队该观察什么
Google 报告了一组数据中心内存优化:Argon agents 分析 profiling telemetry,识别并应用优化;上线后释放超过 300 TiB 内存。公告另提到预计总节省可达 500 TiB–1 PiB。已释放和预计值必须分开,不能把预测写成落地结果,更不能将这个规模按比例套到普通公司的服务器上。
第二类是 C/C++ 到 Rust 的迁移,从核心库到大型代码库。Google 特别写明,这些关键系统的改写需要自动与人工审计、仿真测试和审查后才进入生产。这里的经验不是“模型强了就可以无人上线”,而是让模型扩展执行量,让检测与接受仍有明确步骤。
第三个例子是 libgav1。Google 说 agents 在已有 Rust port 上替换了约 32K 行 SIMD 代码,经过多轮 profile-guided experiments 和编译器输出分析,用安全 Rust 促成自动向量化。最终相对那个 Rust port 快 2.7 倍,保持相同视频输出,并接近优化后的 C++。
2.7 倍的比较对象是特定 Rust port,不是所有软件、所有语言或原始 C++ 版本。这个实例说明试点可以检查什么:基线实现、性能 profile、输出一致性、安全属性和回归测试。可迁移的是验证方法,不是收益数字。
评测数字是筛选信号,不是公司收益预测
公告披露 DeepSWE v1.1 为 77.9%,AutomationBench 为 51.3%,并列出财务、法律和长视频理解评测。它们可以帮助选择值得观察的工作类型,但不同评测的任务、工具条件和评分方法并不相同,不能把它们合成一项通用“工作成功率”。
特别是 AutomationBench 的 51.3%,不应被解释成你的公司有 51.3% 的岗位或任务能直接自动化。本篇只把数字视为 Google 披露的特定评测结果,没有在 Buda 或本文环境中复现这些测试。
团队自己的验收应该落在能看见的成果上,而不是把所有希望寄托在排行榜。代码、财务研究和法律材料需要的证据也不同。
给三类长任务建立不同的验收包
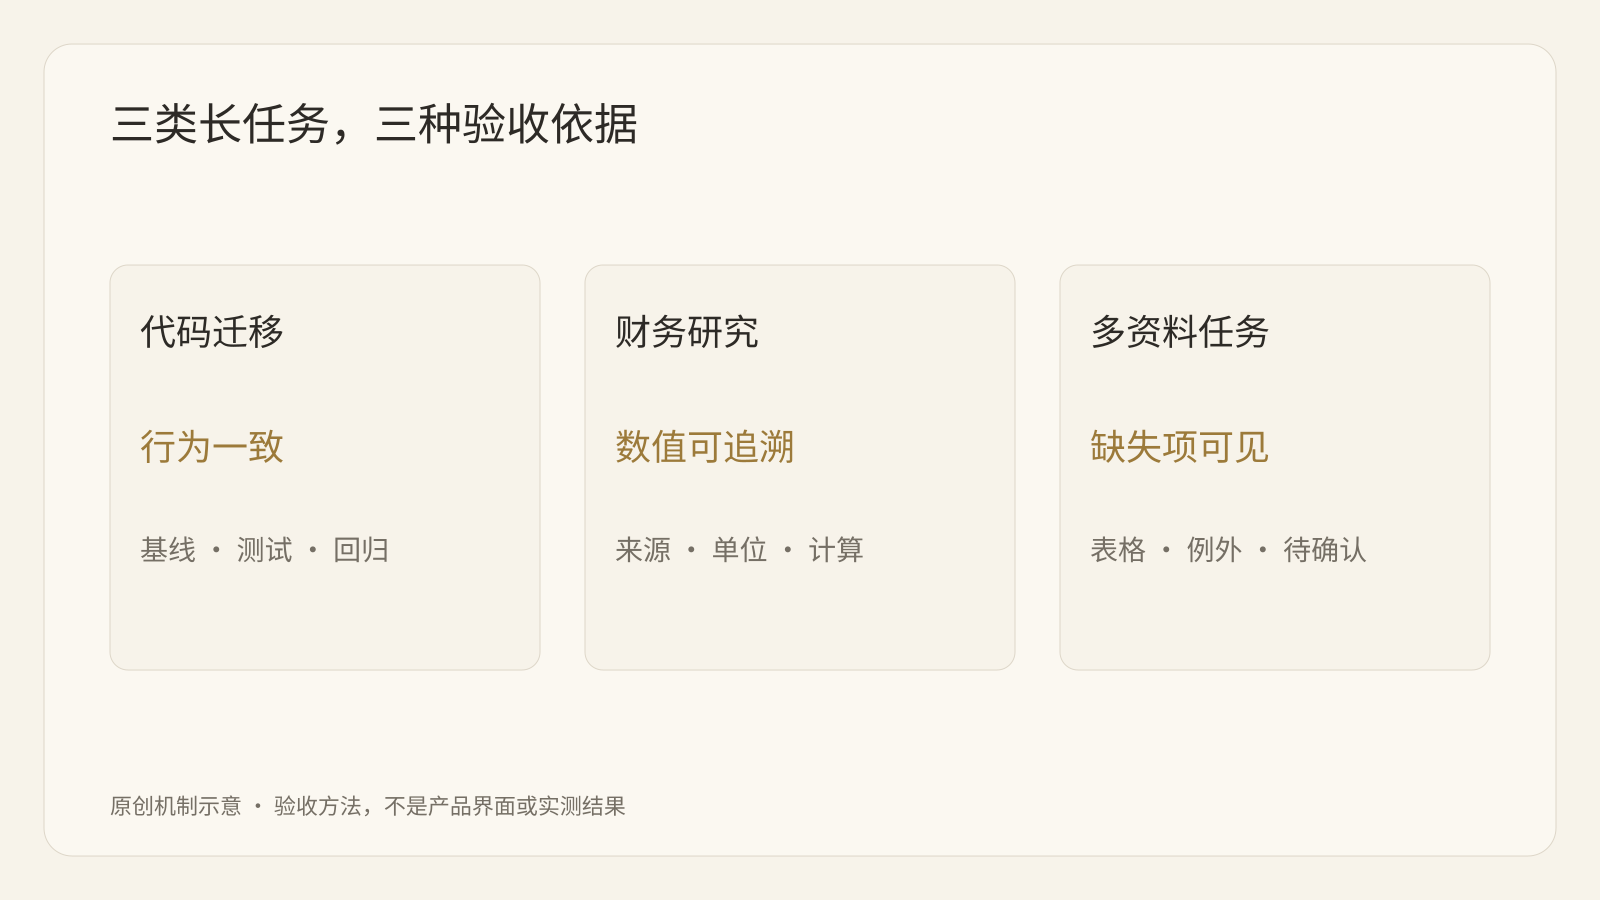
代码迁移:保留相同的行为,再谈性能
选择非关键模块或脱敏副本。固定基线版本、输入数据和测试集合,要求交付 diff、构建命令、回归结果和性能测量方法。先验证输出一致性与边界行为,再测延迟、吞吐或内存。未覆盖的操作系统、依赖和输入必须列出。
出现数据不一致、测试回退或范围外修改时,任务停止在待修复状态,不因 Agent 自评“通过”而合并。上线与回滚必须由有权限的人决定。
财务研究:每个关键数值都能回到来源
准备一组公开或可授权使用的报告,指定币种、期间、单位和比较口径。要求输出结论表、来源链接、计算步骤与异常说明。审阅者应能从表格中的一个数值,回到对应原文或计算记录。
验收不是“报告写得专业”,而是关键数值可追溯、口径一致、推断与事实分开。投资、税务或客户建议仍由合格人员判断。不要为了长任务测试而输入没有授权的财务或个人数据。
多资料业务任务:结果与例外分开交付
可以用一个构造场景试点:将一批供应商公开资料整理为比较表,标出无法验证的条目,再生成待审核的采购说明。最终包包括数据表、来源、未解决问题和说明草稿。
验收要检查是否漏项、是否引用了过期资料、是否把未知值填成确定结论。报价确认、采购和对外发送不是整理任务的默认权限,应另外授权。
网络防御是受限能力,不是普通团队的随手测试
公告讨论可信防御者的漏洞发现、验证与修补,并说明部分访问条件不同。普通团队不应把这一段理解为可以任意探测外部目标。
如果确实开展安全试点,必须有明确的目标授权、隔离环境、最小权限和专业审核。本文不给漏洞利用操作流程,也不从防御评测推断所有生产环境都安全。试点优先选择已有授权、可恢复、低风险的任务。
先把执行轨迹变成可检查的工作
Buda 的 Agent Workspace把对话、持久文件、Terminal、浏览器、预览与 Git 放进同一云端环境。对长任务而言,可用这些表面组织来源、运行过程和产物,让人检查版本、文件与测试,而不是只接收最后一条“完成”。
这是工作组织方式,不是本文证明了 Argon 在 Buda 上可用,也不代表已复现 Google 的实例。无论使用哪一种模型或执行平台,都应先写明输入、权限、交付物与接受条件,再扩大任务范围。
FAQ
1M 指上下文窗口吗?
本公告明确写的是输出 token 上限。不能把它写成输入上下文或永久记忆。
现在所有开发者都能使用 Argon 吗?
本文核验的公告以 Fairwind 的可信防御者、逐步扩大访问为起点,并提到后续付费 API 和 Google AI Ultra 路线。它不是所有账户已获访问的证据,需核对当时账户和最新产品资料。
libgav1 的 2.7 倍能推广到自己的代码吗?
不能直接推广。它针对一个特定 Rust port 和实验过程。应以自己的固定基线、测试与 profile 测量。
51.3% 是否代表企业任务自动化比例?
不是。它是公告披露的 AutomationBench 分数,适用该评测口径,不是岗位或公司流程比例。
长任务结束后,最先看什么?
先看产物、来源与测试是否齐全,再看异常和未覆盖项。中间输出长度与 Agent 的自评不是验收证明。
让第一轮测试可以被否决
好的试点不只写“通过条件”,也写失败条件:来源不足、关键数值错误、回归失败、越权操作,任何一项发生都不能接受结果。先选一项复杂但可恢复的任务,把判定写清,再观察模型能完成多少执行工作。
资料核验:2026 年 10 月 8 日。模型、访问和数值依据 Google 9 月 30 日公告,均为上游披露;三类验收方法与供应商场景为本文设计,未作为实测收益或客户案例。