GPT-5.6 Luna 价格:Buda 积分倍率降至 0.07x
GPT-5.6 Luna 价格在 Buda 以 0.07x 积分倍率呈现。本文解释 Credits 如何计算、Luna 适合什么任务,以及 Buda 最近新增的 AI 模型。

GPT-5.6 Luna 在 Buda 上的相对积分消耗大幅降低了。
它的展示积分倍率从 0.4x 降到 0.07x,对照基准是 1.0x 的 Claude Sonnet 5。同时,Buda 已经把 Luna 设为 Auto 默认模型。没有手动选模型时,日常 Agent 任务会优先从积分倍率最低的 GPT-5.6 路线开始。
对需要反复跑提取、分类、分流、监控和初稿的团队来说,这不是一个小数点变化,而是让 Agent 长时间工作更划算了。
GPT-5.6 Luna 的积分消耗具体怎么变了?
Buda 对外公开的变化是模型的积分倍率:
| Buda 模型对比 | 调整前 | 现在 |
|---|---|---|
| GPT-5.6 Luna 积分倍率 | 0.4x | 0.07x |
| Auto 默认模型 | 较早的 GPT 路线 | GPT-5.6 Luna |
| 免费方案使用 | 可用 | 可用 |
Buda 定价页现在显示 GPT-5.6 Luna 为 0.07x。Buda Credits 官方文档对倍率的定义是:它只用于和 1.0x 基准模型做相对比较,不是每条消息的固定价格。
上游模型费率调整是目录倍率变化的依据,但 Buda 不把上游每百万 token 单价当作面向用户的直接计费单位。用户实际消耗的是 Buda Credits,扣除多少仍由这次任务真正执行的工作决定。
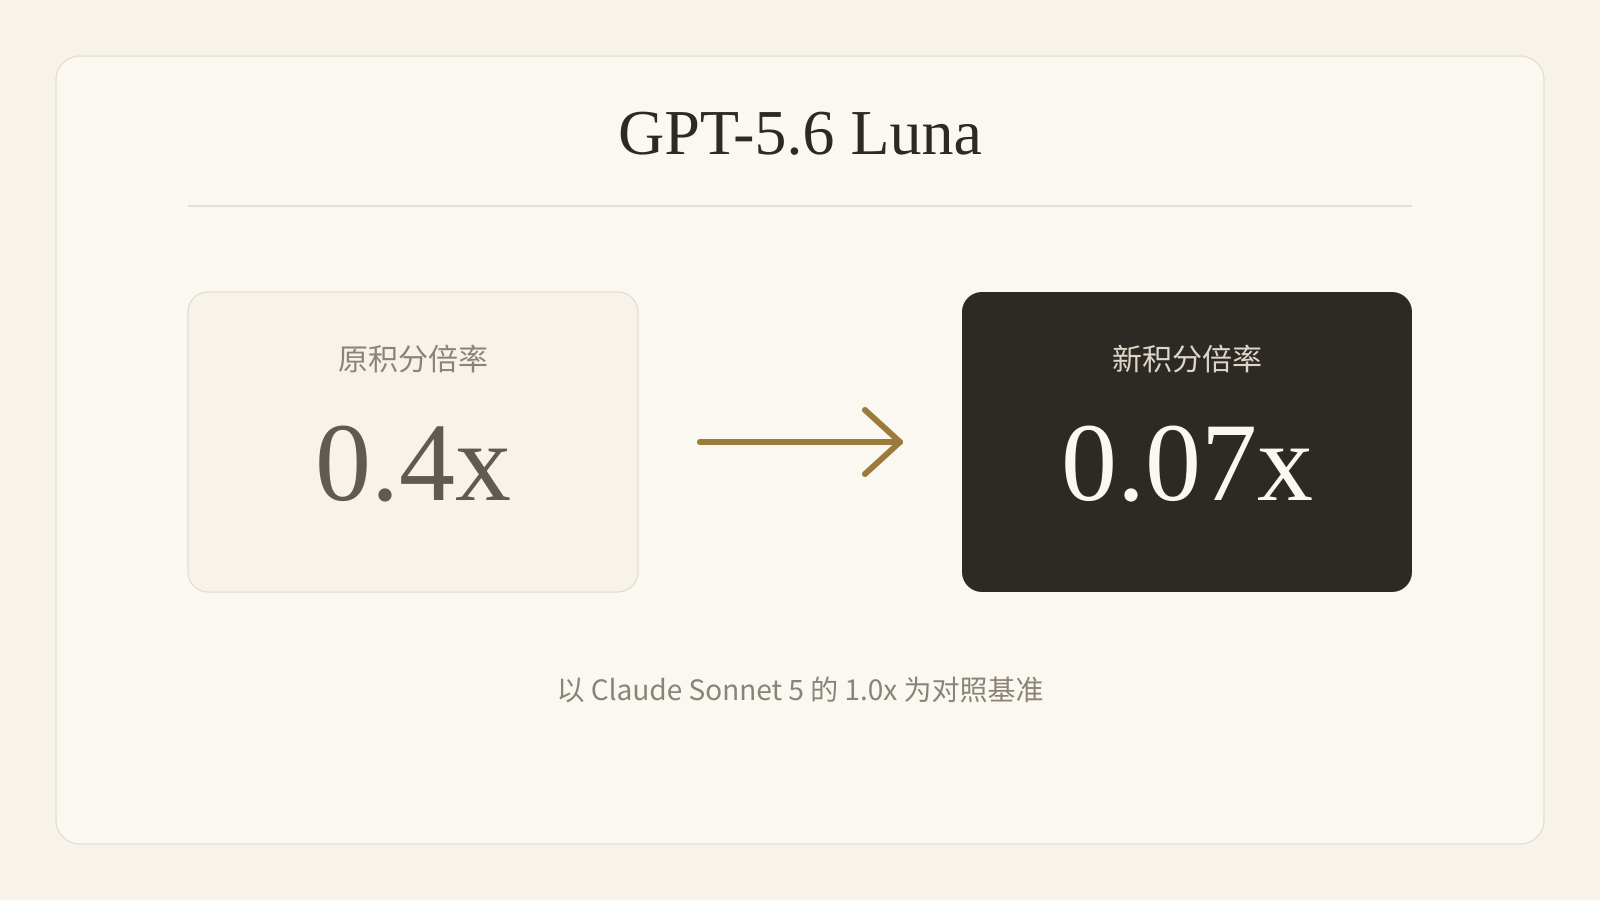
0.07x credit 到底是什么意思?
它是对比倍率,不是每条消息固定扣 0.07 credit。
Buda 以 Claude Sonnet 5 的 1.0x 作为展示基准。Luna 标成 0.07x,表示在相同的模拟 token 结构下,它的混合目录成本约为基准模型的 7%。
实际扣除的积分仍取决于输入、输出、缓存和工具调用。很小的 token 请求最低会扣 1 credit;如果 Agent 使用 Web Search、Browser 等工具,还会产生对应的工具积分。
真正有价值的结论是:对 token 用量较高的常规任务,同样一笔 Buda 积分现在能让 Luna 跑更久。
GPT-5.6 Luna 现在是 Buda 的 Auto 默认模型
Buda 的 Auto 选项现在会解析到 GPT-5.6 Luna。
用户不手动选模型时,日常执行会先走 Luna。旧 Agent 如果保存了已经下架的 GPT-5.4 或 GPT-5.5,也会回落到 Auto,不会因为旧模型 ID 直接中断工作流。
但 Auto 不等于所有任务都应该留在 Luna。更合理的做法是先用低成本模型完成常规执行,再把困难、模糊或高风险的步骤升级给更强模型。
哪些 Agent 任务最适合 GPT-5.6 Luna?
Luna 适合高频、结构清晰、结果容易复核的任务:
- 给客服消息、用户反馈或销售线索分类
- 从文档、网页和表格里提取字段
- 把任务分发给正确的 Agent 或队列
- 汇总常规监控结果和定时更新
- 按已确认模板起草标准回复
- 运行 heartbeat 检查和重复 Automations
- 先整理数据,再交给更强模型处理异常
遇到复杂研究、困难代码、模糊决策或高风险最终输出,可以切换到 GPT-5.6 Terra、GPT-5.6 Sol、Claude Sonnet 5 或其他更合适的模型。
高效的 Agent 工作流从来不是“全程只用一个模型”。更好的结构是:低成本执行,按需升级,关键节点由人审核。
Buda 最近还上新了哪些 AI 模型?
Luna 降价只是最近一轮模型更新的一部分。Buda 近期新增或升级了这些新一代模型:
| 模型 | Buda 积分倍率 | 使用门槛 | 适合场景 |
|---|---|---|---|
| GPT-5.6 Luna | 0.07x | 免费,Auto 默认 | 高频常规执行 |
| Gemini 3.6 Flash | 0.5x | 免费 | 快速通用 Agent 任务 |
| GPT-5.6 Terra | 0.7x | 免费 | 均衡的日常工作流 |
| Claude Sonnet 5 | 1.0x | 免费 | 通用推理和内容生产 |
| Claude Opus 5 | 1.7x | 需订阅 | 深度推理和困难审核 |
| GPT-5.6 Sol | 1.9x | 需付费方案 | 复杂 GPT 工作流 |
| Claude Fable 5 | 3.3x | 需订阅 | 最高成本的 Claude 专项工作 |
Gemini 3.6 Flash 已经取代模型选择器里的 Gemini 3.5 Flash。GPT-5.6 Sol、Terra、Luna 取代了较旧的 GPT-5.4 和 GPT-5.5 路线。Claude Sonnet 5 和 Opus 5 也分别接替了旧一代 Sonnet 与 Opus。
这张表不是模型排行榜。倍率最高,不代表最适合。Buda 把模型分层摆出来,是为了让 Agent Manager 只在“更强判断确实会改变结果”的地方花更多积分。
GPT-5.6 Luna、Terra、Sol 怎么选?
三个 GPT-5.6 版本对应不同层次的工作:
- **Luna,0.07x:**速度和重复执行
- **Terra,0.7x:**均衡的日常工作
- **Sol,1.9x:**困难推理和高风险输出
一个实际工作流可以让 Luna 先收集和标准化信息,Terra 产出完整初稿,Sol 只检查少量困难异常,最后由人做决定。
你可以查看完整的 Buda GPT-5.6 模型页面,或在 Buda 定价页 对比当前模型门槛和积分倍率。
FAQ
GPT-5.6 Luna 在 Buda 上多少钱?
它没有一个固定的“每条消息价格”。GPT-5.6 Luna 的展示积分倍率是 0.07x,对照 Claude Sonnet 5 的 1.0x。实际积分取决于输入和输出长度、缓存用量,以及运行过程中调用的工具;很小的 token 请求最低扣 1 credit。
免费版 Buda 可以使用 GPT-5.6 Luna 吗?
可以。GPT-5.6 Luna 和 Terra 都对免费方案开放,GPT-5.6 Sol 需要付费方案。
GPT-5.6 Luna 是 Buda 默认模型吗?
是。Buda 当前的 Auto 模型会解析到 GPT-5.6 Luna。
0.07x 是不是每条消息只扣 0.07 credit?
不是。它是相对展示倍率。Buda 会根据 token 和工具用量计算积分,小请求最低扣 1 credit。
Buda 最近新增了哪些模型?
近期新增和升级包括 GPT-5.6 Sol、Terra、Luna,Gemini 3.6 Flash,Claude Sonnet 5、Claude Opus 5 和 Claude Fable 5。不同模型的方案门槛不同。
先用 Auto 低成本启动,再把真正困难的步骤切给更强模型。打开 Buda Dashboard,让工作流把算力花在值得的地方。