
GPT-6 Astra 的 105 万 Context 不是永久记忆
GPT-6 Astra API 支持最多 1,050,000 tokens context,足以放进大型仓库、长研究链路或大量文档。但这仍然不是永久记忆。
OpenAI 还为 Codex 加了另一层能力:active window 满后,Astra 可以跨窗口保留 notes,并搜索更早的 messages 与 tool outputs。这是 harness 能力,不会自动把所有旧信息变成可信记录。
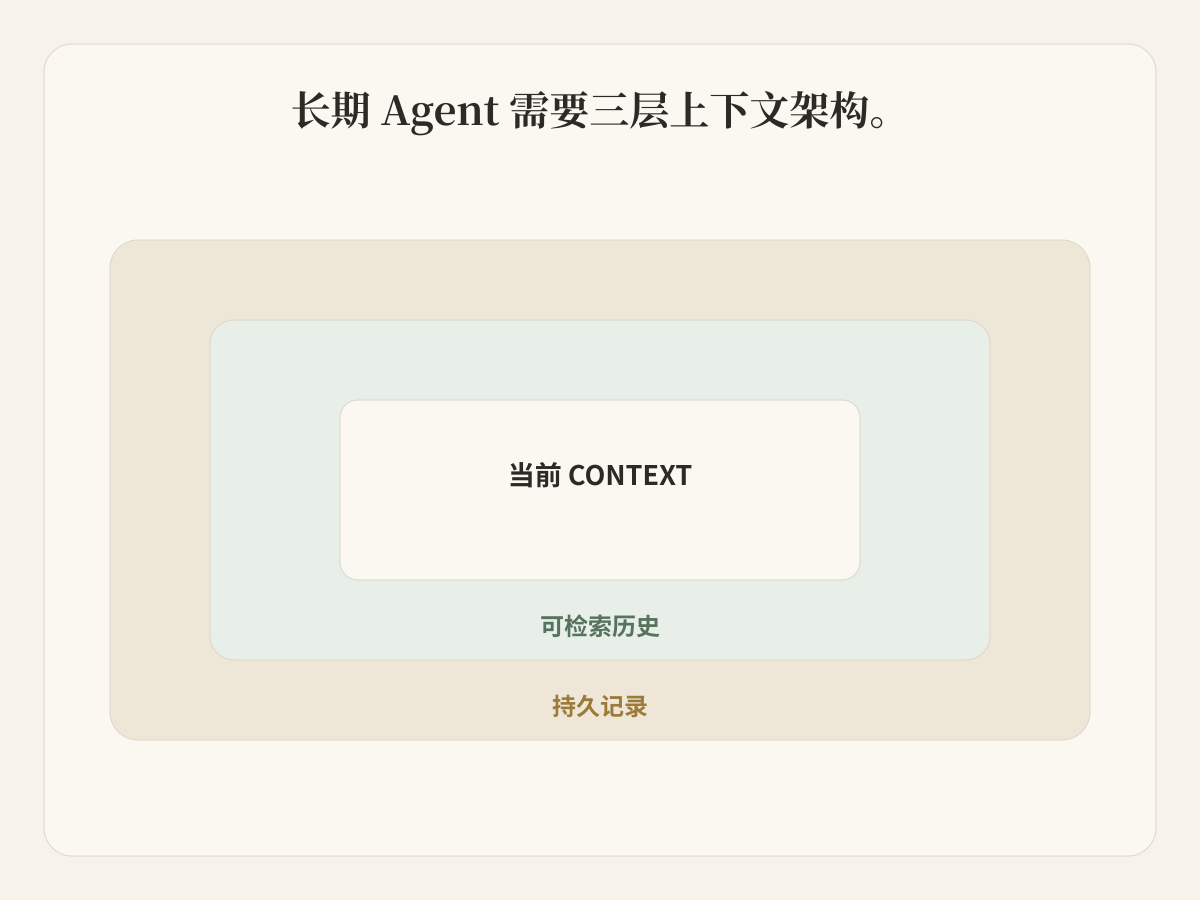
正确架构有三层:当前 Context、可检索历史、持久 Source of Truth。
第一层:Context Window 是工作注意力
模型页写明 1,050,000 context window 与 128,000 max output。OpenAI 还报告 Astra 在 512K–1M 的 8-needle MRCR 测试中达到 96.3%。这是厂商模型测试,不代表百万 Token 里的每个事实都能被稳定找回。
大 Context 可以减少裁剪,但解决不了过期指令、版本冲突、来源标记不清和无关信息成本。输入超过 272K tokens 后,API 还会使用更高价格倍率,所以“全部塞进 Prompt”不是免费架构。
把 Context Window 当成当前步骤的工作注意力,而不是仓库。
第二层:Codex 可以检索旧窗口
OpenAI 表示,过去 Codex 会用 compaction 压缩长 session,失败原因或组件细节可能在摘要中丢失。Astra 可以跨窗口保存 notes,并搜索更早的消息和工具输出,包括没有进入 notes 的细节。发布时它仍是 experimental config,并计划成为 Astra 默认能力。
可搜索历史比反复压成一份有损摘要更好。但检索只能回答“以前说过或观察过什么”,不能回答“现在批准的决定是什么”。旧测试可能已经失效,旧需求可能被覆盖,旧消息也可能只是一项提案。
第三层:持久文件承载权威状态
长期任务需要模型窗口之外的稳定对象:当前 brief、批准后的 requirements、source files、decision log、test evidence 和最终 deliverable。它们需要名称、负责人、日期与 review 状态。
Buda 给每个 Agent 持久 Drive 和云电脑,并围绕工作提供 files、browser、terminal、Git、Skills、Channels 与 Automations。这是 workspace persistence,不是“模型永远不会忘”。人可以直接审核真实产物,不必相信一段重新拼接的对话。
| 问题 | Context Window | 可检索历史 | 持久记录 |
|---|---|---|---|
| 用来做什么 | 当前推理 | 找回旧观察 | 保存已验收状态 |
| 可能失败 | 注意力、冲突、成本 | 漏检、旧结果 | Owner 与 review 不清 |
| 适合放什么 | 当前任务包 | 旧消息与工具输出 | Brief、来源、决定、证据 |
| 谁决定真假 | 模型解释 | Harness 检索 | 明确负责人审核 |
建 Context Packet,不要做 Context Dump
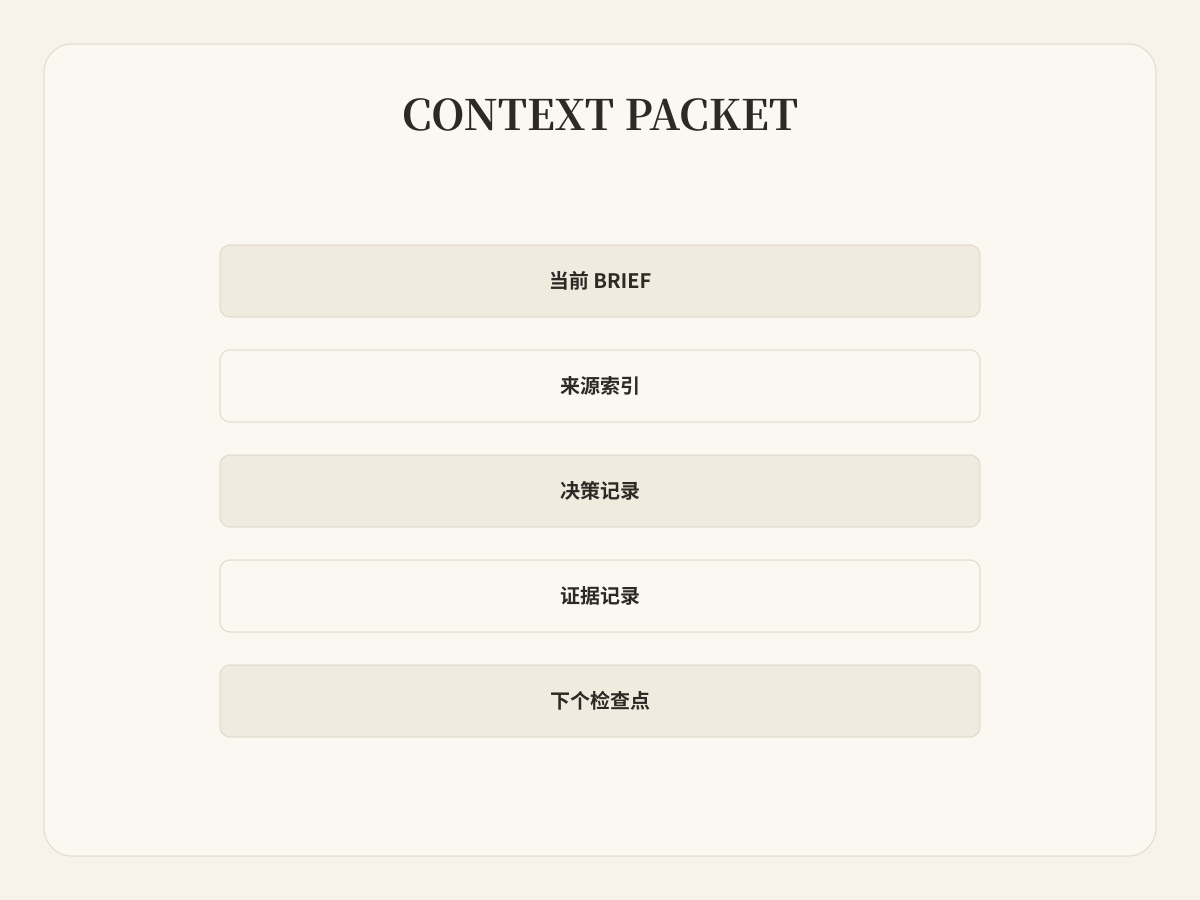
长期任务只维护一个小而清晰的任务包:当前 brief、权威 source index、decision log、evidence log,以及下一个人工 checkpoint。Active window 放这个任务包和当前步骤所需材料;搜索历史负责找细节;持久文件负责保存批准状态。
什么时候真的需要百万 Token
当大量文件之间的关系必须同时进入推理时,大窗口很有价值,例如仓库级重构、合同对比、文献综合、多文档调查,以及用大规模来源核对最终产物。
但任务一旦跨天、换负责人或产生重要决定,记录就必须独立于某次模型调用长期存在。
开始长期 Agent 前先问四个问题
- 哪些文件是权威来源?
- 哪些旧决定仍然有效?
- 哪些历史只能作为背景,不能视为批准?
- 哪个输出必须由人验收?
GPT-6 Astra 扩大工作注意力,Codex 改善跨窗口连续性,持久 Workspace 保存人真正需要负责的工作。三者不要混为一谈。
了解 Buda Agent Workspace 如何保存文件与执行现场