
同一批资料,第一次问能答,隔几天再问,答案却换了一套说法。你得重新打开 PDF、找原句、对版本;之前读过的材料,并没有替下一次判断省下多少功夫。真正缺的往往不是更多收藏,而是一份能持续维护、随时回查依据的知识。
Karpathy LLM Wiki 把这件事拆成明确的文件操作:原文留下,知识页可以更新,新的证据来了要检查旧结论,普通提问则不悄悄改库。它由 Astro-Han 的源仓库维护。值得先弄清楚的,是一份材料如何进入知识库,以及它改变结论时,哪些页面必须一起变。
先看懂:原文、知识页、索引与日志
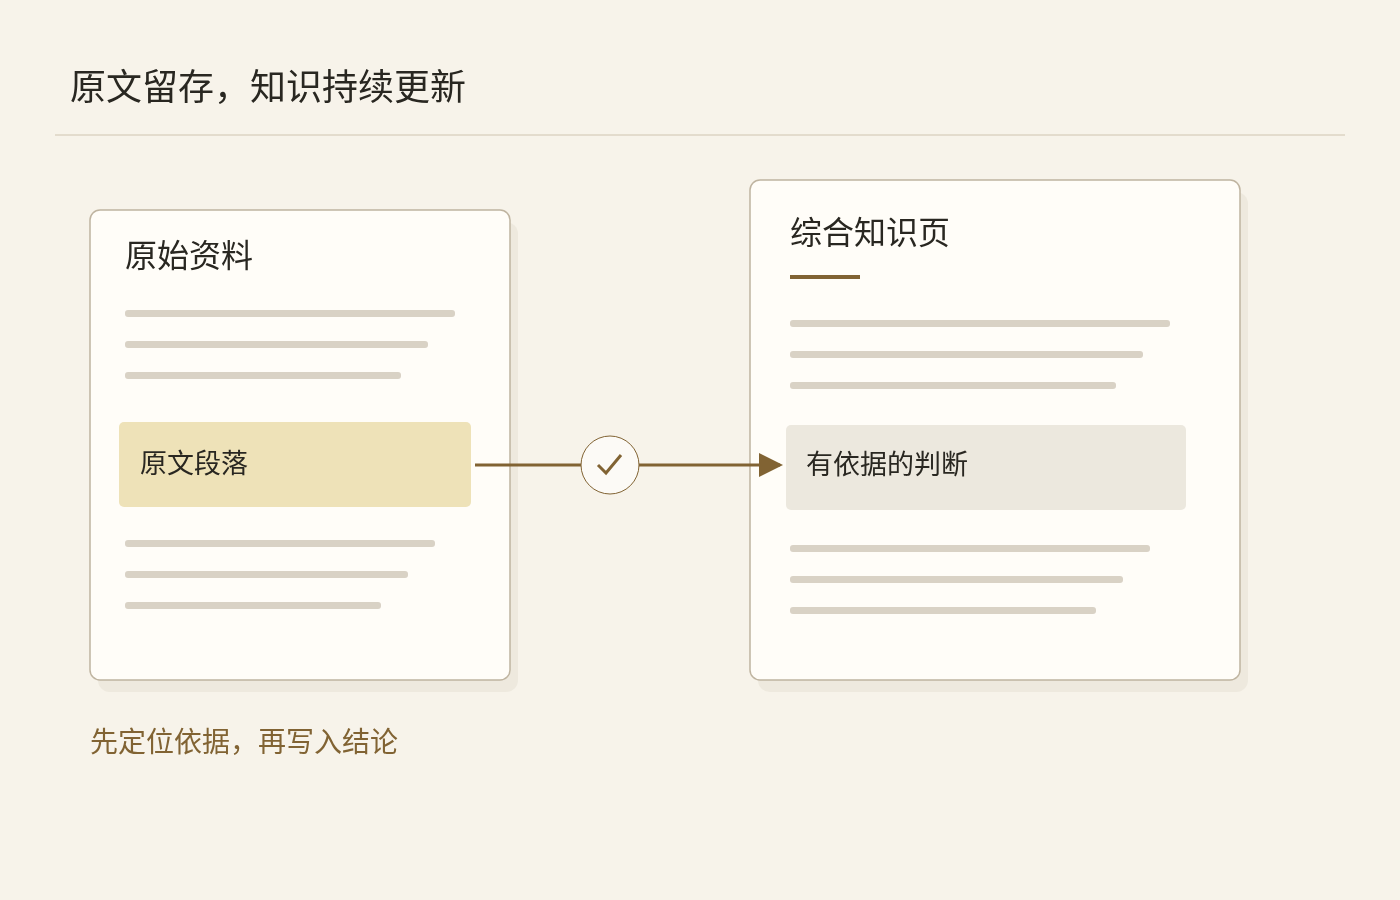
它将文件分成两层:raw/ 保存不可改写的原始材料,wiki/ 保存可以持续更新的知识文章。原始材料记录来源 URL、采集日期和发布日期,并保留原文;知识文章按概念组织,不是每存一篇文章就生成一份同名摘要。
wiki/index.md 是全局索引,负责让人和 Agent 找到文章;wiki/log.md 只追加操作记录,说明发生了什么。这四个角色要分清:原文提供证据,知识页形成综合,索引指路,日志保留变化。文件持续积累不意味着模型权重自动学会了这些内容。
当新材料推翻旧说法,应该修改综合判断,同时保留原始证据,不能把旧原文改成符合新结论的版本。
第一步:安装 Skill,收录一份真实材料
在 Buda AI 的 Marketplace 搜索并安装 Karpathy LLM Wiki,先核对维护者和源仓库。选择专门的项目目录,提供 Agent 实际能读取的材料。扫描 PDF、登录后网页或受限链接,仍要先解决文本提取与访问权限;安装 Skill 不会自动打通外部账号。
可以这样交代:“在这个项目中,用 Karpathy LLM Wiki 收录这份材料。保留原文和来源信息,先搜索已有知识,再判断新建、更新或标记争议。完成后列出改动文件,以及重要判断对应的原文位置。”
首次收录只创建缺失的目录、索引和日志,不覆盖已有文件。查询与检查遇到空知识库时,应先要求收录,不能悄悄初始化后假装已经有知识。
第二步:判断新建、更新,还是保留争议
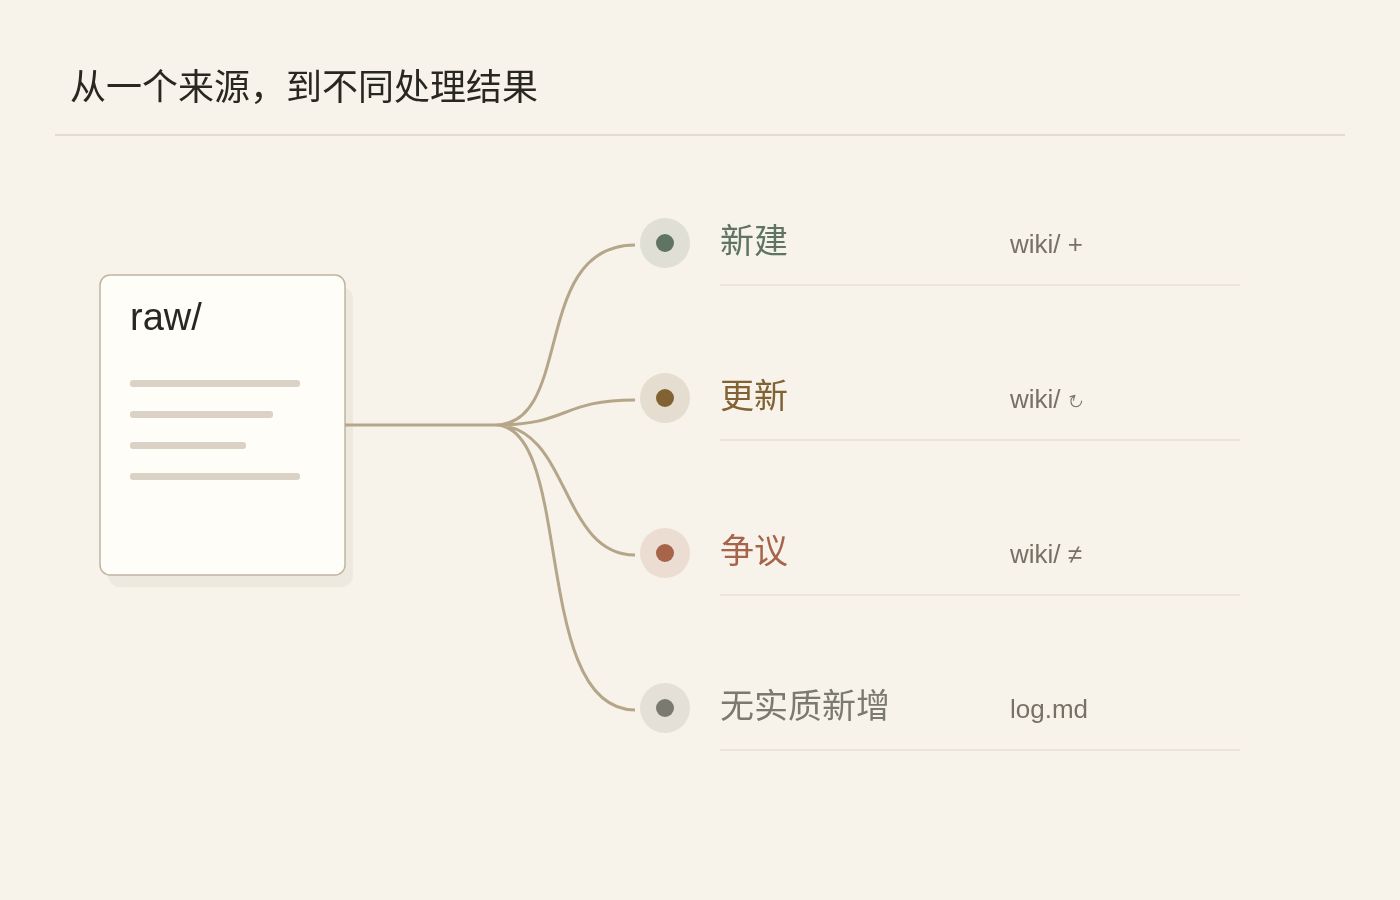
材料先进入原文目录,再按实体和同义词搜索知识页。确实增加概念时新建,同一核心论点补入现页,来源冲突时标记争议。新建、更新和争议可以同时发生;没有实质新增时,则保留原文、记入日志后停止。
这一步决定知识库会越用越清楚,还是堆满重复摘要。不要用文章数量作为验收目标,更不要为了让每次运行都有“成果”而强写一页。
写入数字、日期和直接引语前,要先在关联原文中找到字面依据,数值形式保持一致;推导值必须能看到组成部分。它约束的是结论与材料的关系,不能代替对来源可靠性的判断。
第三步:把变化同步到相关知识页
新材料可能影响多个主题。级联更新要搜索全文里的实体、别名和相关主张,不能只看索引。已被新信息替代的旧说法保留并标注 Outdated;来源相互矛盾则标注 Disputed,跨页争议互相链接。历史归档页是当时的快照,不参与级联改写。
检查输出时,重点看三件事:哪些知识页被影响、每个变化有何来源、其他页面是否还在沿用旧结论。随后更新索引中的知识日期,向日志追加本次记录。
第四步:查询知识,按需归档回答
Query 先看索引,再用同义词做全文搜索,引用找到的知识文章回答。普通问题不写文件。只有明确要求把回答归档,才新建归档页,引用作为依据的知识页,再更新索引和日志。
这样,一次对话中的综合回答与直接依据原文编译的知识页不会混为一谈。归档也不是把原文章覆盖成刚才聊天的版本。
第五步:检查链接与事实依据
Lint 可以处理部分结构问题,例如补齐漏掉的索引项、修复只有唯一候选的移动链接;有多个可能目标时应报告。仓库的 check_evidence.py 检查关联原文中的高信号字面值,疑似不匹配仍要回到上下文判断。事实冲突、过时判断和来源缺口以报告形式交给人,不自动改事实。
字面匹配成功,只说明这句话能追到材料,不保证材料本身正确。完整的一轮,应留下原文、明确的分流结果、有依据的知识页、更新的索引与追加日志。
可以用 Buda 的 Drive 与文件工具搭建这套流程,先围绕一个主题跑通并人工抽查,再扩大资料范围。执行脚本前核实际环境和完整 Skill 文件;具体格式可查源仓库。
从一份要反复使用的资料开始
打开 Karpathy LLM Wiki Skill 页面,在 Buda AI 的 Marketplace 搜索并安装到一个 Agent。给它一份真实资料,先检查原文、知识页和来源链接,再让它接着处理下一份;从第一轮就把可回查的知识留下。