Anthropic 于 2026 年 9 月 28 日发布 Claude Sonnet 5.5。它是 Opus 5.5 的补充:Sonnet 更适合目标和范围已经明确的执行任务;复杂、开放、需要持续判断的工作,Opus 仍然更强。
衡量一次执行,不是看回答写得多漂亮,而是看文件能否打开、测试是否通过、结果有没有可核查的依据。
探索 Buda
把等待时间留给更有用的修改。
¹ Anthropic 测试显示,相比 Sonnet 5,输出速度提升 30%+,单次任务成本最多下降 30%。节省来自使用更少的 tokens,不是 token 单价下调;实际结果随任务和思考强度变化。
更快进入下一轮
明确需求后,初稿、反馈和修改之间的等待更短。输出速度是模型指标,不意味着所有业务流程都能提前 30% 完成。
代码执行明显增强
Terminal-Bench 4.0 得分为 70.6%,Sonnet 5 为 10.3%。它值得用真实 bug 和测试来评估,但基准分数不是团队自己的任务通过率。
成品更接近交付要求
官方强调文档、幻灯片、表格、图表理解与设计能力。给 Agent 原始资料、模板和验收标准,比一句“做得专业一点”更有效。
与 Opus 分工,而非一概替换
官方评估中,较低和中等思考强度适合日常执行。是否增加思考,应看合格结果、耗时和消耗,而不是默认把参数调到最高。
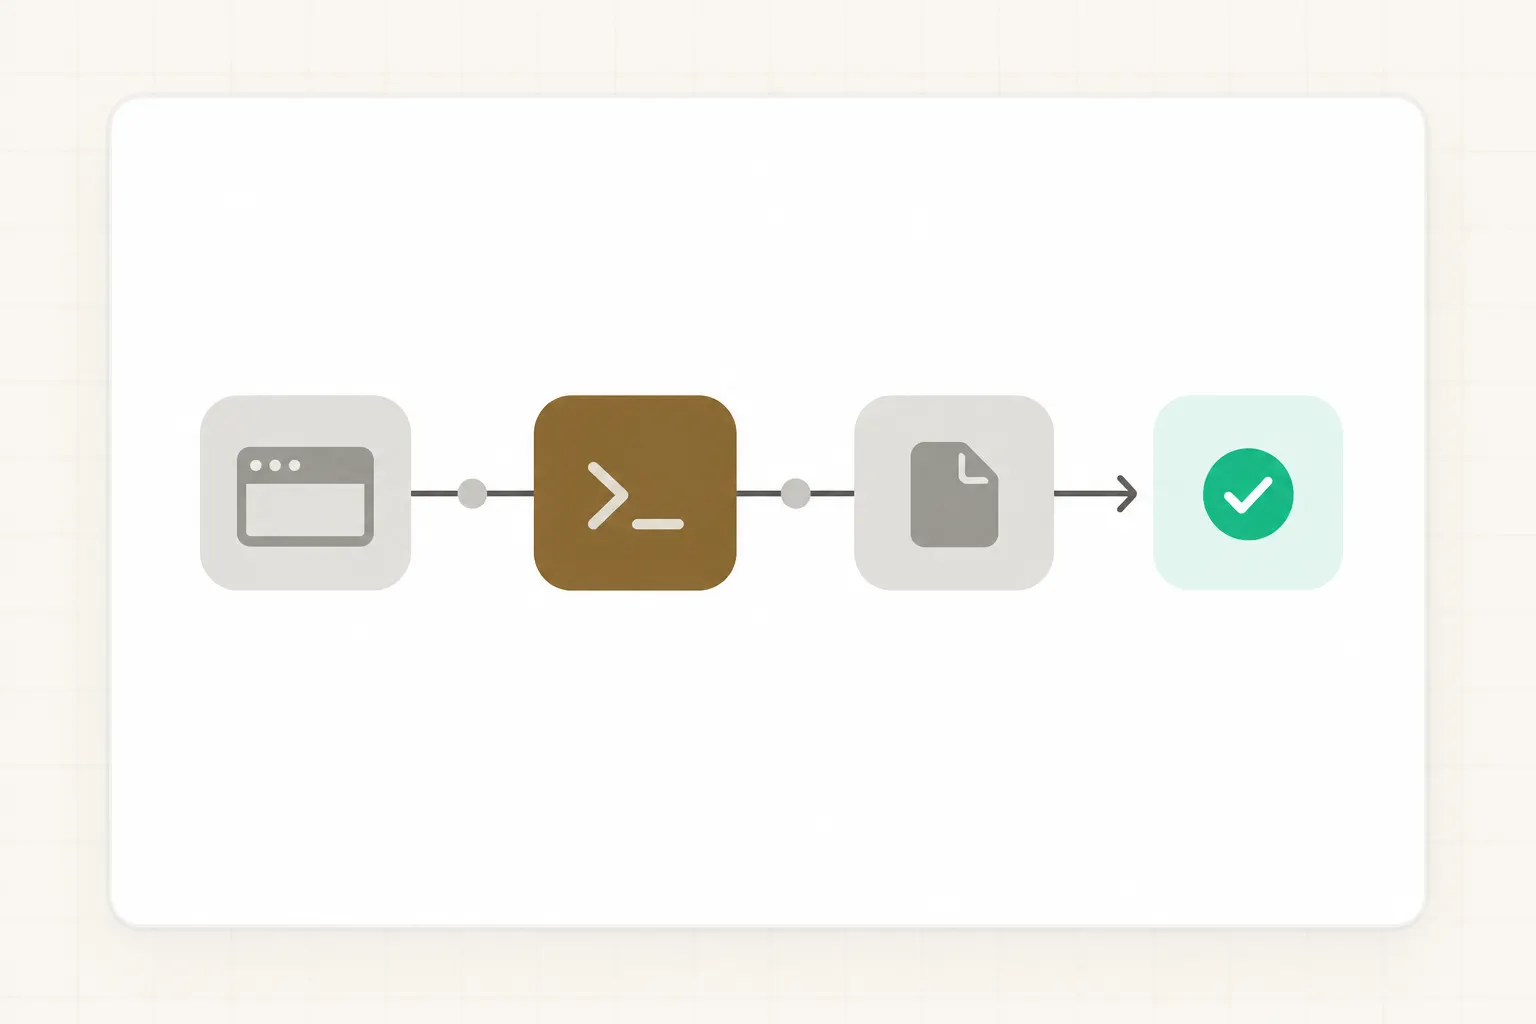
明确的执行交给 Sonnet,困难的判断留给 Opus。
选择依据是任务里的不确定性,而不是某一项排行榜的胜负。
| 任务 | Sonnet 5.5 | Opus 5.5 | 人的判断 |
|---|---|---|---|
| 可复现 bug,有明确测试 | 优先评估 | 根因不清时再考虑 | 确认范围与测试 |
| 有来源和模板的文档 | 优先评估 | 适合处理证据冲突 | 核对事实与计算 |
| 短周期设计反馈 | 侧重迭代速度 | 适合复杂取舍 | 确认视觉质量 |
| 开放研究或架构设计 | 承接明确的后续执行 | 优先用于持续判断 | 确定方向与风险 |
这是任务选择建议,不代表自动模型路由,也不代表 Agent 之间已内建自动接力。
需求范围越清楚,结果越容易验收。
先写清必须改变和必须保持不变的部分。Buda 可把源文件、过程产物和可见工具调用放在一起;重要操作前,再检查测试、证据和最终文件。
| 人工审核 | 需求范围越清楚,结果越容易验收。 |
|---|---|
| 1 | 定义交付物与验收标准 |
| 2 | 提供源文件和允许使用的工具 |
| 3 | 检查差异、证据和最终文件 |
| 4 | 明确授权重要的外部操作 |
下一轮修改,不必重新搭一遍上下文。
Buda 是云端 AI Agent 工作空间。Drive 中的资料和可检查的执行过程,让任务能够沿着上一次的结果继续,而不是每次都从新聊天开始。
| 工作空间 | 实际用途 |
|---|---|
| Drive | 保存原始资料、模板和工作产物 |
| Agent 会话 | 保留任务上下文,查看工具调用 |
| Browser 与 Terminal | 在支持的套餐中查看网页、运行命令 |
| Skills 与连接工具 | 复用做事方法和已授权的集成 |
Claude Sonnet 5.5 常见问题
Claude Sonnet 5.5 是什么?
这是 Anthropic 于 2026 年 9 月 28 日发布的 Sonnet 更新,重点是更快的输出、更强的代码与知识工作,以及比 Sonnet 5 更高的执行效率。
成本下降 30%,是 token 降价了吗?
不是。官方表示 token 单价与 Sonnet 5 相同;测试中的任务成本下降来自消耗更少的 tokens。Buda Credits 使用独立计费体系。
它应该替代所有 Opus 5.5 任务吗?
不应该。Sonnet 适合范围明确的执行和快速迭代;Anthropic 仍认为 Opus 在复杂、开放、需要持续判断的工作上更强。
团队怎么判断是否值得使用?
用相同输入、验收测试和审核流程比较一小组真实任务,记录合格产物、完成耗时与实际消耗,不只看输出速度。
Buda 给模型工作流增加了什么?
持续保存的文件、Agent 会话、工具执行和可检查的交付物。当前可选模型和套餐入口以 Buda 价格页为准。
模型更强,就可以跳过人工审核吗?
不可以。准确率和速度不会转移责任。人仍然要定义权限、核对重要结果,并决定什么可以离开工作空间。