GPT-6 Astraの料金を解説:10ドル/50ドルだけでは完成タスクの費用は分からない
cache、長い入力、処理モード、再試行、ツール、人のレビューを含めて、合格タスクの費用を計算します。

GPT-6 Astraの料金を解説:10ドル/50ドルだけでは完成タスクの費用は分からない
GPT-6 AstraのStandard API価格は、100万tokenあたり未cache入力10ドル、出力50ドルです。しかし、これだけではAgentの予算を決められません。
完成タスクにはcacheの作成と読取、ツール料金、推論と出力、再試行、長い入力の割増、人のレビューが含まれます。管理すべき数字は合格タスクあたりの総費用です。
Standardの計算式
入力が27.2万token以下の場合、未cache入力は10ドル/MTok、cached inputは1ドル/MTok、cache writeは12.50ドル/MTok、出力は50ドル/MTokです。
text費用 = 未cache入力 × 10 + cache読取 × 1 + cache書込 × 12.50 + 出力 × 50(ドル/MTok)
APIが返す利用区分を使い、同じtokenを重複計上しないようにします。Web searchやcomputer useなどは別のツール料金が加わる場合があります。
四つの請求例
税、プロバイダー上乗せ、地域処理、ツール料金は除外します。
1. 一回の分析:0.40ドル
未cache入力2万token、出力4000tokenなら、0.020 × 10 + 0.004 × 50 = 0.40ドルです。出力単価は未cache入力の5倍なので、短く構造化した成果物を指定する効果は大きくなります。
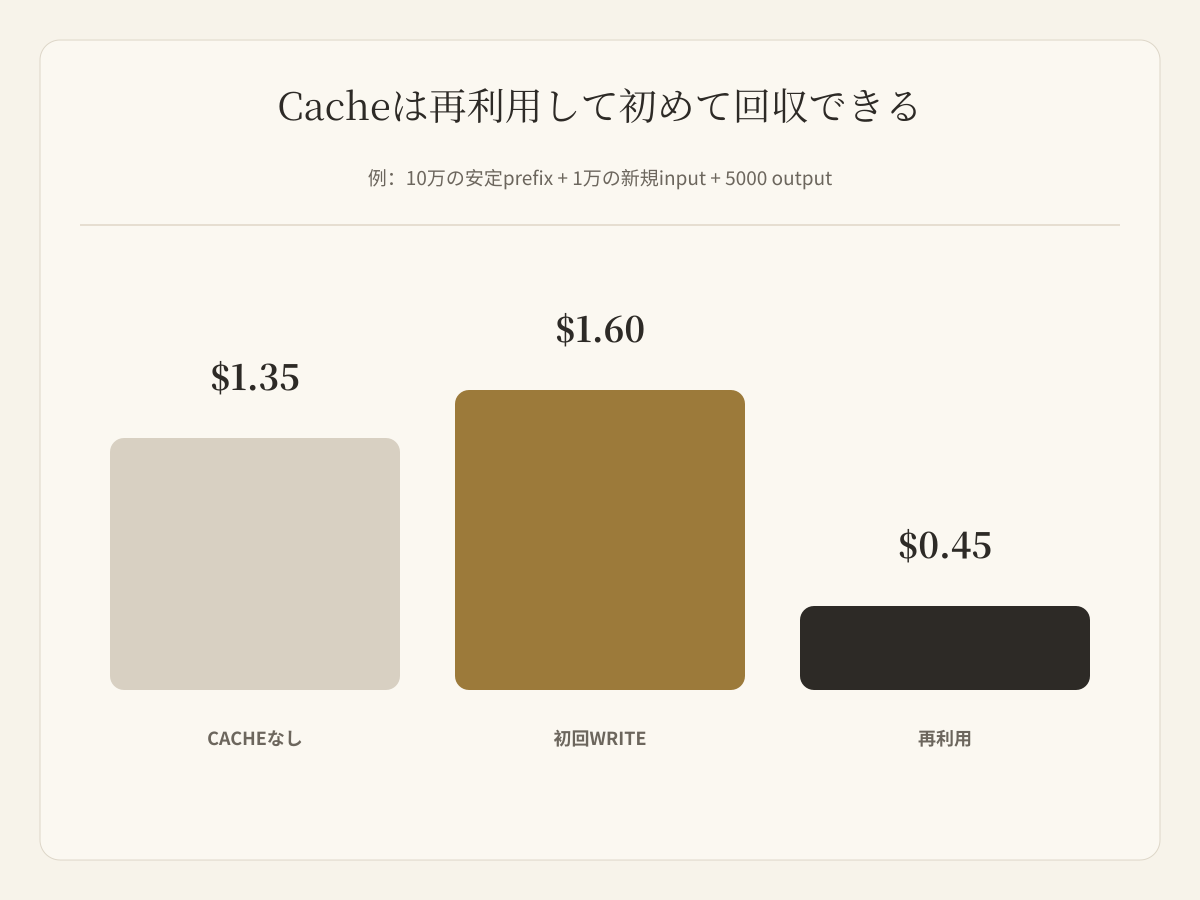
2. 10万tokenのprefixを再利用:初回1.60ドル、以降0.45ドル
10万tokenの安定した規則やcontextに、新規入力1万tokenと出力5000tokenを加える例です。
- cacheなし:
1.10 + 0.25 = 1.35ドル - 初回cache writeの例:
1.25 + 0.10 + 0.25 = 1.60ドル - 次回cache hit:
0.10 + 0.10 + 0.25 = 0.45ドル
初回は高くなりますが、次の再利用でcacheなしより0.90ドル安くなります。prefixが対象条件を満たし、変化せず、実際に再利用されることが前提です。
3. 入力30万token:4ドルではなく7.50ドル
入力が27.2万tokenを超えると、リクエスト全体の入力とcacheは2倍、出力は1.5倍のrateになります。
未cache入力30万token、出力2万tokenなら、0.300 × 20 + 0.020 × 75 = 7.50ドルです。headline rateだけなら4ドルとなり、3.50ドル不足します。
105万tokenのcontext windowは容量上限であり、使用目標ではありません。retrievalと選択的contextは引き続き費用管理に必要です。
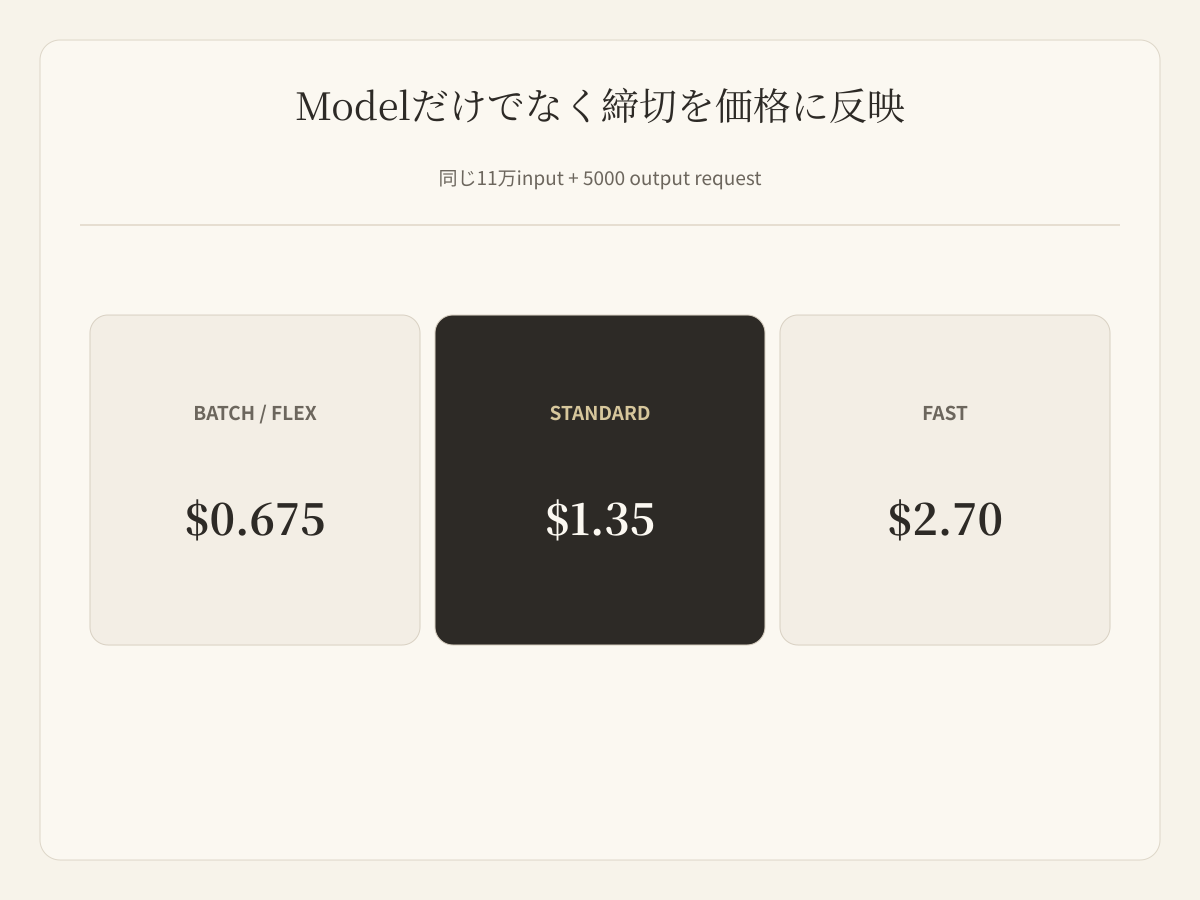
4. Standard、Batch/Flex、Fast:1.35、0.675、2.70ドル
未cache入力11万、出力5000tokenの同じ処理は、Standardで1.35ドル、50%のBatchまたはFlexで0.675ドル、2倍のFastで2.70ドルです。締切と遅延の価値で選びます。
合格タスクあたりの費用
簡易式は次の通りです。
合格タスクあたり期待model費用 = 平均試行費用 ÷ 初回合格率
0.40ドルで合格率80%なら0.50ドル、0.20ドルで合格率40%でも0.50ドルです。人の修正時間はまだ入っていません。
本番ではmodel、effort、mode、各token区分、tool fee、retry、fallback、初回合格率、review時間、合格成果物あたり総費用を記録します。
OpenAIは一部のcodingとcomputer-useでAstraのtokenや時間削減を報告しています。一方、Artificial AnalysisはCoding Agentで高いtoken効率を認めつつ、一般Intelligence Indexの最大effortではGPT-5.6 Solよりタスク費用が75%高いとしています。仕事とharnessによって、高い単価を効率で回収できるかが変わります。
費用を制御する六つの方法
- 難しい推論やツール復旧が合格率を変える段階だけにpremium modelをrouteする。
- 成果物、schema、長さ、終了条件を指定して高価な出力を抑える。
- 規則、例、不変contextを安定したprefixにする。
- 大きなwindowを埋めず、必要な資料をretrievalする。
- 遅延可能な仕事はBatch/Flex、速度に価値がある場合だけFastを使う。
- APIだけでなくreviewと手戻りを計測する。
Budaでの考え方
ここで示した数字はOpenAI APIの価格であり、Buda Creditsではありません。
GPT-6 AstraはまだBudaで利用できません。提供開始後はmodel selectorと公開料金ページに対象範囲とCredit倍率が表示されます。実際のCreditsは入力、出力、cache、tools、最低課金規則で変わる場合があります。
関連:GPT-6 Astraリリースガイド、GPT-6 AstraとClaude Fable 5.1の比較。現在のBudaモデル倍率は公開料金ページで確認できます。
FAQ
一回のrequestはいくらですか
固定価格はありません。APIの利用区分ごとに計算し、27.2万入力を超えたら長入力rateを適用し、toolとinfrastructure料金を加えます。
cacheは必ず安くなりますか
読取は安いですが、作成は通常入力より高価です。安定したprefixを再利用して初めて節約できます。
27.2万を超えた部分だけ割増ですか
いいえ。OpenAIによれば、割増はリクエスト全体に適用されます。
Fastは費用効率が高いですか
Fastは2倍のrateで低遅延を買う選択肢です。時間短縮の価値がpremiumを上回る場合に限ります。
OpenAIの価格はBuda Creditsと同じですか
同じではありません。別の料金体系です。