GPT-6 AstraとClaude Fable 5.1を比較:長時間Agentに合うのはどちらか
独立総合指数はFable、複数のツール作業はAstraが優位です。仕事、実行環境、キャッシュ、レビュー費用で選びます。

GPT-6 AstraとClaude Fable 5.1を比較:長時間Agentに合うのはどちらか
GPT-6 AstraとClaude Fable 5.1の表面的な仕様はよく似ています。約100万トークンのコンテキスト、最大12.8万トークンの出力、Standard API価格は100万トークンあたり入力10ドル、出力50ドルです。
しかし、同じ仕事に同じように使えるわけではありません。
結論は明確です。難しい推論、多段階の調査、大きなキャッシュ済みプレフィックスを繰り返し読む仕事ではFable 5.1を先に評価します。実際のソフトウェアを操作し、長いツール処理を復旧しながら成果物まで作る仕事ではAstraを先に評価します。 最終的なルートは一つのランキングではなく、自社の合格タスクで決めます。
独立総合評価ではFable 5.1が先行
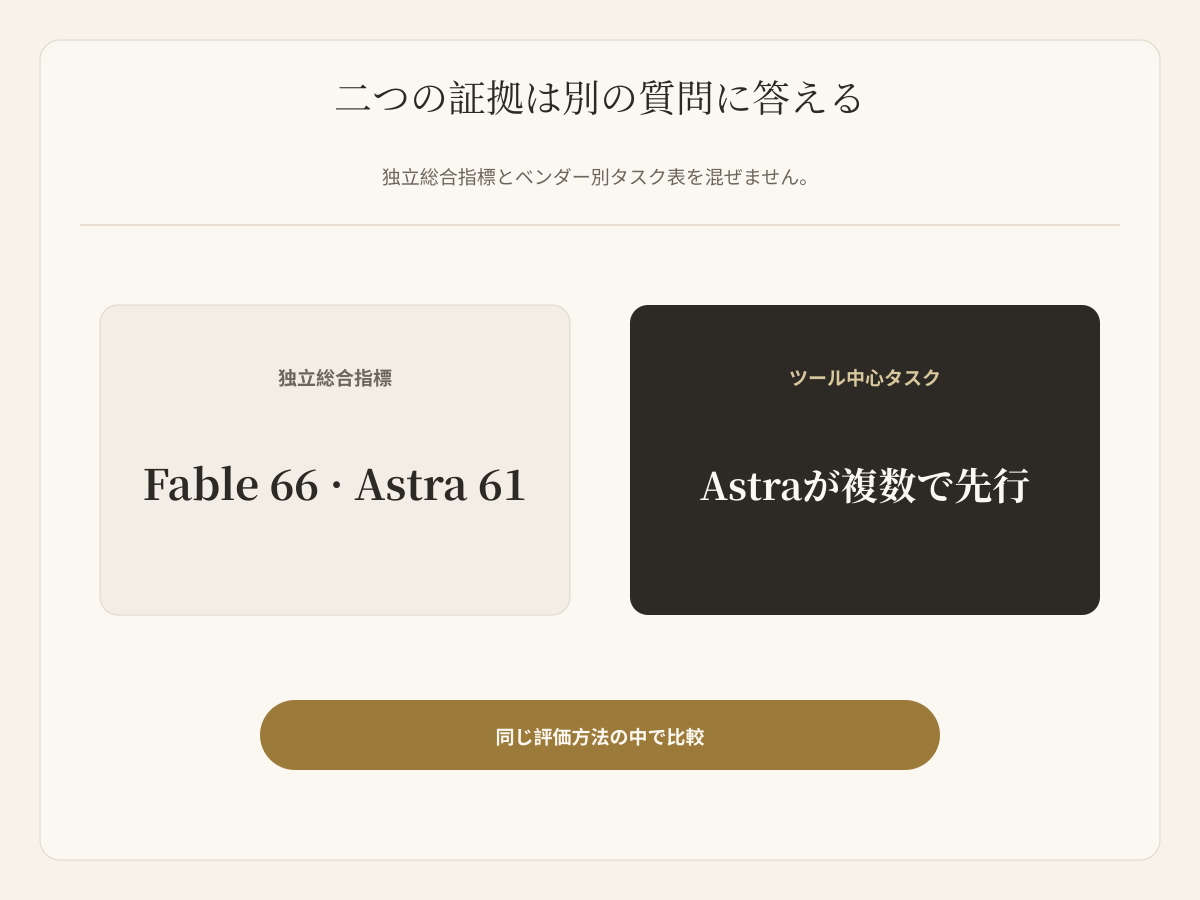
Artificial AnalysisのIntelligence Indexでは、最大effortのClaude Fable 5.1が66、GPT-6 Astraが61です。Coding Agent IndexでもFable 5.1は70、Astraは67です。
同じ評価方法で測った独立指標として有用ですが、すべての仕事でFableが勝つという意味ではありません。Fableの設定には最大effortとdefault fallbackが含まれます。Coding Agent Indexの実行環境もClaude CodeとCodexで異なります。これは単独モデルではなく「モデルとAgent実行環境」の結果です。
Artificial AnalysisによるAstraの評価も一方向ではありません。GPT-5.6 Solよりtoken効率が大きく改善し、Coding Agentの費用効率は高い一方、一般知能タスクでは値上げが効率改善を上回り、タスク費用が上がりました。
OpenAIの表ではAstraが複数のツール作業で優位
| 評価 | GPT-6 Astra | Claude Fable 5.1 | 注意点 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 55.8% | OpenAI表。Terminal Agent設定の影響あり |
| AutomationBench | 41.4% | 31.4% | SaaSワークフロー実行 |
| BenchCAD | 95.9% | 84.3% | Claude値には文書化された変更あり |
| Terminal-Bench Science | 64.6% | 52.6% | ツールを使う科学ワークフロー |
| Artificial Analysis Intelligence Index | 61.2 | 65.7 | OpenAI表が引用した独立指標 |
| Artificial Analysis Coding Agent Index | 67.0 | 67.2 | この時点ではほぼ同等 |
Astraがコンピューター操作やTerminalで先行しながら、Fableが広い独立総合指標で先行することは両立します。
同じ価格でも運用費用は違う
- Astraのcached inputは1ドル/MTok、Fable 5.1のcache readは0.25ドル/MTokです。
- Astraは入力が27.2万tokenを超えると、リクエスト全体の入力とcacheが2倍、出力が1.5倍になります。
- 両方に50%のBatch割引があります。Astraには50%のFlexと、適用価格の2倍になるFastもあります。
- Fable 5.1はadaptive thinkingが常時有効で、会話途中にeffortを変更できます。
- Fable 5.1のdefault fallbackは実際に測るシステムを変えます。
- ツール、再試行、拒否、レビュー、手戻りはtoken単価以上に総費用へ影響します。
100万tokenを入れられることと、毎回入れるべきことは同じではありません。検索と安定したcache設計は必要です。
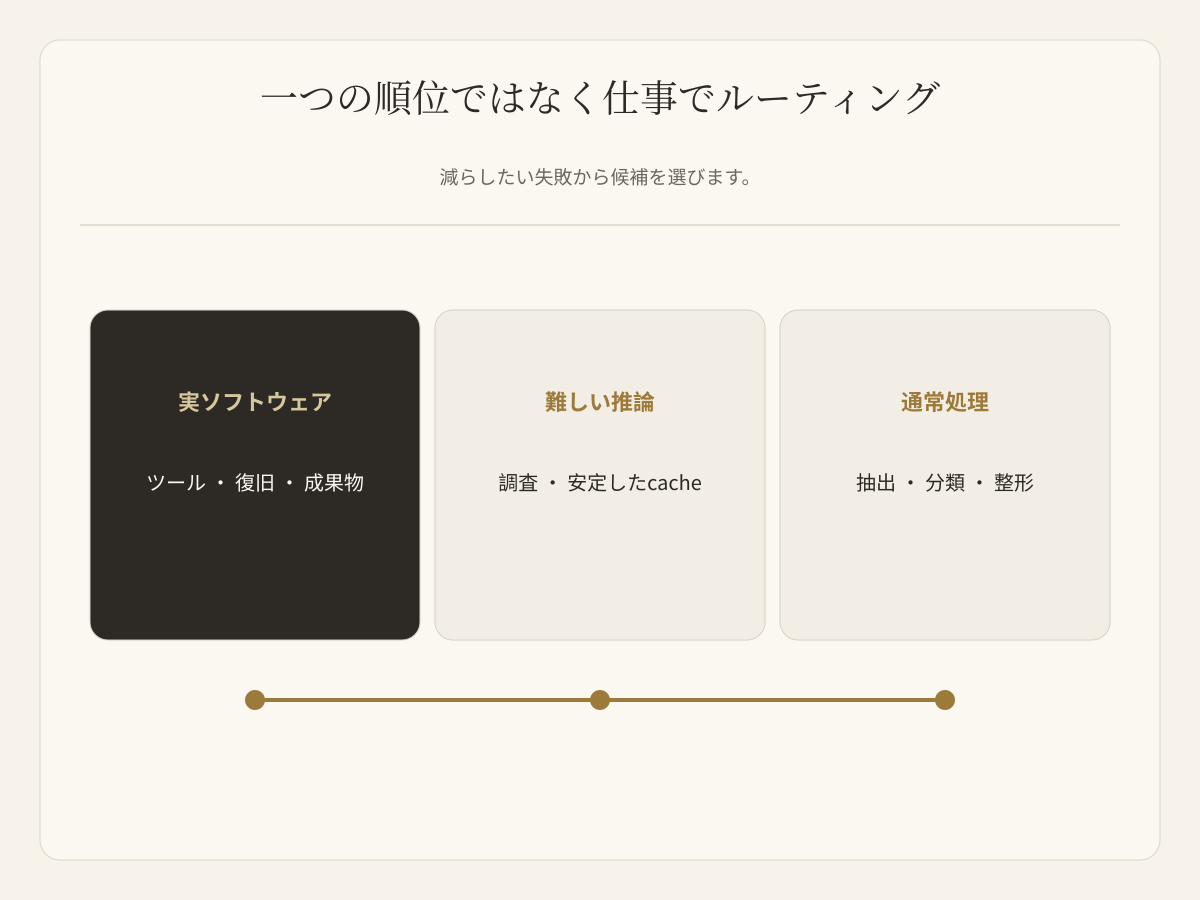
減らしたい失敗で選ぶ
**Astraを先に試す仕事:**Browserやデスクトップ操作、Terminal・ファイル・Web・検証を横断する処理、長時間実行の方向修正と復旧、文書・表計算・スライド・Webサイトの完成品。
**Fable 5.1を先に試す仕事:**難しい推論、多段階調査、安定した大きなプレフィックスを繰り返す会話、thinking blocksを正しく扱う既存Claude環境、Claude Code中心の開発。
**安価なモデルを維持する仕事:**抽出、分類、整形など検証しやすい処理、小さいモデルですでに合格する処理です。
Harnessが結果を反転させる
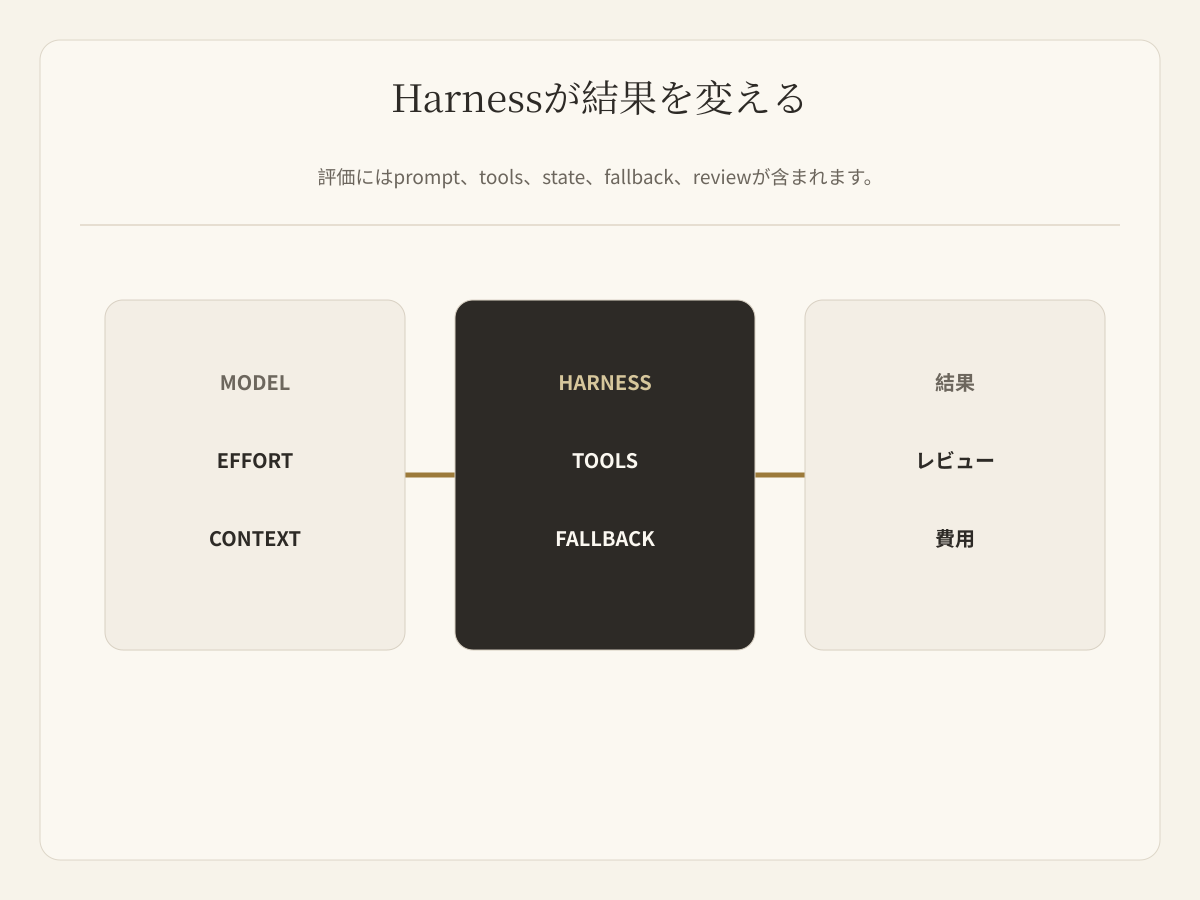
CodexとClaude Codeは、prompt、tools、permissions、compaction、fallback、confirmation、stateの保存方法が異なります。Astraの改善には、過去のcontext windowを検索できるCodex側の変更も含まれます。Fable 5.1にも、forced tool choice非対応、旧モデルがthinking blocksを読めない、過去turnの編集でthinking blocksが無効になる、といった制約があります。
本番切替前に同じ合格タスクで、初回合格率、ツール復旧、所要時間、input/cache/reasoning/output、修正回数、モデルとharnessどちらの失敗か、合格タスクあたり総費用を記録します。
裸のAPIテストと完成したAgent製品を比べて、モデル順位と呼ぶべきではありません。
Budaでの考え方
モデルはAgent Workspaceの一部です。永続ファイル、実ツール、権限、見える実行、人のレビューが引き続き必要です。
GPT-6 AstraとClaude Fable 5.1は、まだBudaでは利用できません。提供開始後の対象範囲とCreditsは、Budaのモデル一覧と公開料金ページで案内します。
関連:GPT-6 Astraリリースガイド、AI Agentに適したモデルの選び方、Claude Fable 5.1の変更点。
FAQ
AstraはFable 5.1より優れていますか
すべての仕事ではありません。Fable 5.1は現在のArtificial Analysis総合指標で先行し、Astraは複数のコンピューター操作、Terminal、自動化、科学タスクで先行しています。
どちらが安いですか
Standard入出力は同額です。Fable 5.1はcache readが安く、Astraは27.2万入力tokenを超えると割増になります。タスク全体で比較してください。
Context windowはどちらが大きいですか
Astraは105万、Fable 5.1は100万tokenです。実務では検索、cache、過去の判断を保持するharnessの方が重要です。
一つのbenchmarkでdefaultを決められますか
決められません。公開評価で候補を絞り、社内の安定した合格タスクでrouteを決めます。