Preço do GPT-6 Astra: por que US$ 10/50 não é o custo de uma tarefa concluída
Cache, sobretaxa de contexto longo, modo de processamento, tentativas, ferramentas e revisão definem o custo do trabalho aceito.

Preço do GPT-6 Astra: por que US$ 10/50 não é o custo de uma tarefa concluída
O preço Standard do GPT-6 Astra é US$ 10 por milhão de tokens de entrada sem cache e US$ 50 por milhão de saída. Isso precifica tokens, não um Agent.
Uma tarefa concluída pode incluir criação e leitura de cache, ferramentas, raciocínio e saída, novas tentativas, sobretaxa por entrada longa e revisão humana. O número útil é o custo por tarefa aceita.
Fórmula Standard para texto
Até 272 mil tokens de entrada: input sem cache custa US$ 10/MTok, cached input US$ 1/MTok, cache write US$ 12,50/MTok e output US$ 50/MTok.
custo = input sem cache × 10 + cache read × 1 + cache write × 12,50 + output × 50 (US$/MTok)
Use as categorias retornadas pela API e não conte o mesmo token duas vezes. Web search, computer use e outras ferramentas hospedadas também podem ter cobrança separada.
Quatro contas reproduzíveis
Os exemplos excluem impostos, margem do provedor, processamento regional e ferramentas.
1. Análise única: US$ 0,40
Com 20 mil tokens de input sem cache e 4 mil de output: 0,020 × 10 + 0,004 × 50 = US$ 0,40. Output custa cinco vezes mais por token; limitar tamanho e formato pode economizar mais que cortar um trecho pequeno do prompt.
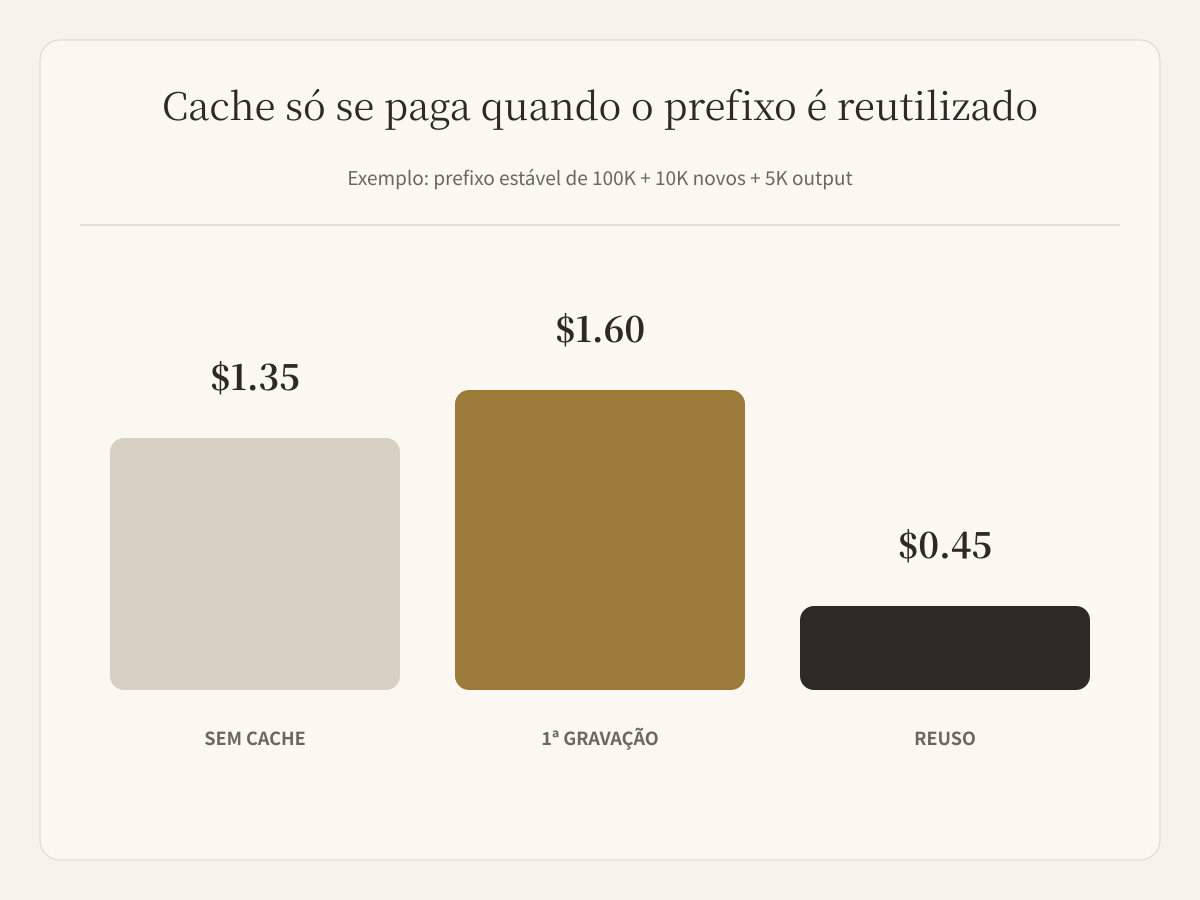
2. Prefixo reutilizável de 100K: US$ 1,60 primeiro, US$ 0,45 depois
Considere 100 mil tokens estáveis de regras e contexto, mais 10 mil de input novo e 5 mil de output.
- Sem cache:
1,10 + 0,25 = US$ 1,35 - Primeira gravação ilustrativa:
1,25 + 0,10 + 0,25 = US$ 1,60 - Leitura posterior:
0,10 + 0,10 + 0,25 = US$ 0,45
A primeira execução paga mais; a próxima reutilização economiza US$ 0,90 sobre uma execução sem cache. O prefixo precisa ser elegível, estável e realmente reutilizado.
3. Entrada de 300K: US$ 7,50, não US$ 4,00
Acima de 272 mil tokens de entrada, Astra cobra 2x pelas taxas de input/cache e 1,5x por output na solicitação inteira.
Com 300 mil tokens sem cache e 20 mil de saída: 0,300 × 20 + 0,020 × 75 = US$ 7,50. Aplicar só os números 10/50 daria US$ 4,00, uma diferença de US$ 3,50.
A janela de 1,05 milhão é capacidade, não meta de consumo. Recuperação seletiva continua sendo controle de custo.
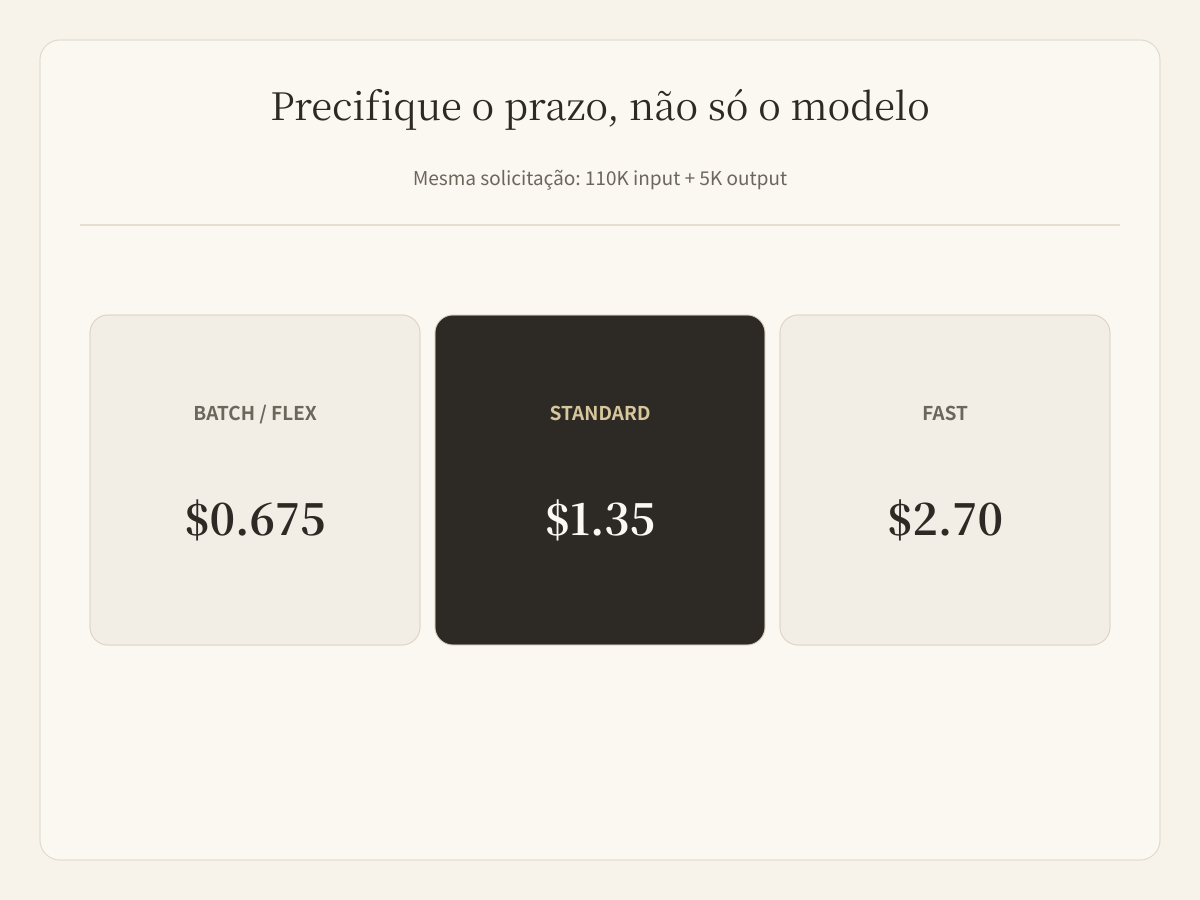
4. Standard, Batch/Flex e Fast: US$ 1,35, US$ 0,675 ou US$ 2,70
A mesma solicitação de 110 mil tokens sem cache e 5 mil de saída custa US$ 1,35 em Standard, US$ 0,675 em Batch/Flex a 50% e US$ 2,70 em Fast a 2x. Escolha pelo prazo e pelo valor da latência.
Custo por tarefa aceita
Uma aproximação simples é:
custo esperado por tarefa aceita = custo médio da tentativa ÷ taxa de aceite na primeira tentativa
Uma tentativa de US$ 0,40 com 80% de aceite chega a US$ 0,50. Outra de US$ 0,20 com 40% também chega a US$ 0,50, antes de contar a revisão.
Em produção, registre modelo, effort, mode, categorias de tokens, ferramentas, retries, fallback, aceite inicial, minutos de revisão e custo total por artefato aceito.
A OpenAI relata menos tokens ou tempo em algumas tarefas de coding e computer use. A Artificial Analysis encontra forte eficiência no Coding Agent, mas Astra fica 75% mais caro por tarefa que GPT-5.6 Sol no esforço máximo do Intelligence Index geral. O trabalho e o harness decidem se a eficiência compensa o preço maior.
Seis formas de controlar a conta
- Use o modelo premium apenas onde raciocínio ou recuperação alteram o aceite.
- Defina artefato, schema, tamanho e condição de parada para limitar output.
- Agrupe políticas, exemplos e contexto invariável em um prefixo estável.
- Recupere só os arquivos necessários; não preencha a janela por capacidade.
- Use Batch/Flex para trabalho adiável e Fast quando latência tiver valor real.
- Inclua revisão e retrabalho na medição.
O que isso significa no Buda
Os números acima são preços da API da OpenAI. Não são Buda Credits nem promessa de preço do Buda.
GPT-6 Astra ainda não está disponível no Buda. Quando for lançado, o seletor de modelos e a página pública de preços mostrarão disponibilidade e multiplicador de Credits. O consumo real também pode depender de input, output, cache, ferramentas e cobrança mínima.
Leia o guia de lançamento e Astra vs Claude Fable 5.1. Para multiplicadores atuais dos modelos no Buda, consulte a página pública de preços.
Perguntas frequentes
Quanto custa cada solicitação?
Não há valor fixo. Aplique as taxas às categorias reportadas pela API, use a regra de entrada longa acima de 272K e some ferramentas e infraestrutura.
Cache é sempre mais barato?
A leitura é barata, mas criar o cache custa mais que input comum. A economia exige prefixo estável e reutilização.
A sobretaxa vale só para tokens acima de 272K?
Não. Segundo a OpenAI, ela se aplica à solicitação inteira.
Fast é mais econômico?
Fast compra baixa latência a 2x das taxas aplicáveis. Só compensa quando o tempo economizado vale o adicional.
Preço da OpenAI é igual a Buda Credits?
Não. São sistemas de cobrança separados.