
Claude Fable 5 怎么收费:API 价格、Buda Credits 与真实任务成本
先给直接答案:Anthropic 的 Claude Fable 5 标准 API 目录价是每百万 token 输入 10 美元、输出 50 美元。缓存命中是 1 美元,Batch 则是输入 5 美元、输出 25 美元。
在 Buda 当前价格页中,Fable 5 显示为 3.3x Credit 倍率。这个倍率用来比较不同模型的相对消耗,不代表每次 Prompt 固定扣 3.3 Credits。实际消耗取决于输入、输出、缓存、工具、重试和任务复杂度。
这是三个不同层次:上游 API 目录价、Buda 相对倍率、整项任务的实际 Credits。把它们混在一起,才会出现“单价看懂了,账单却没看懂”。
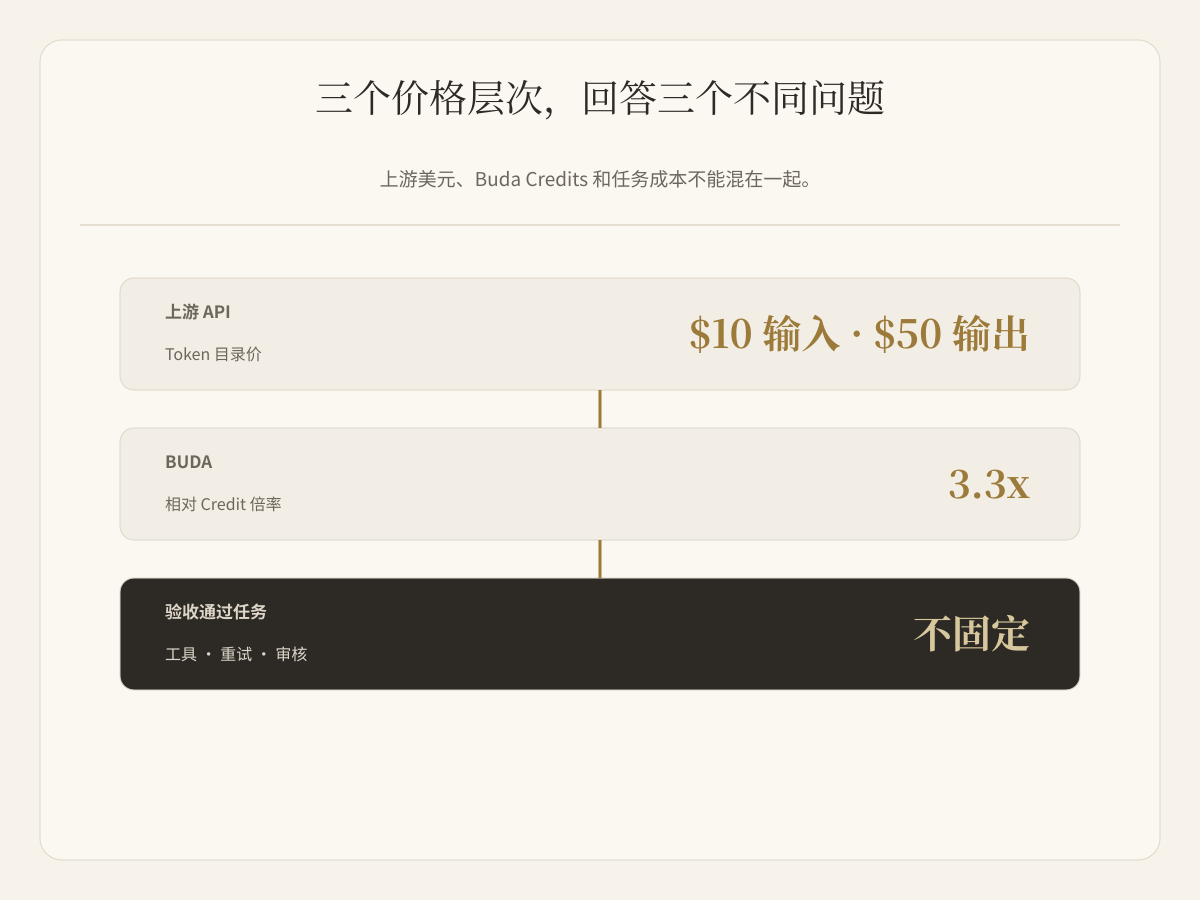
一张表看懂 Fable 5 价格
| 层次 | 当前公开值 | 它能回答什么 |
|---|---|---|
| Anthropic 标准 API | 输入 $10 / 输出 $50 每百万 token | 上游 token 目录价 |
| Anthropic 缓存命中 | $1 每百万 token | 重复读取缓存输入的价格 |
| Anthropic Batch | 输入 $5 / 输出 $25 每百万 token | 异步批处理折扣 |
| Buda | 3.3x | Buda 内不同模型的相对 Credit 倍率 |
| 完成一项任务 | 不固定 | 模型、工具、失败、审核和返工总和 |
输入 token 不只有用户发出的那句话,还包括系统指令、文件、检索上下文、工具定义、工具结果和对话历史。输出则包括回答、计划、代码、审查和报告。
所以,上游单价适合估算 API 请求,Buda 倍率适合比较模型。两者都不能单独预测一个 Agent 最终做完工作的成本。
一个最简单的 API 成本例子
假设一次请求使用 10 万个未缓存输入 token,并输出 8000 个 token:
- 输入:
100,000 / 1,000,000 × $10 = $1.00 - 输出:
8,000 / 1,000,000 × $50 = $0.40 - 这次请求的标准 token 成本:$1.40
这笔计算本身没错,但它只覆盖一次 API 请求。Agent 可能还会规划、调用工具、接收很长的结果、重试失败步骤,并再次验证。每多一次模型调用,任务总成本都会变化。
单个验收通过任务的成本 = 模型 + 工具 + 失败执行 + 重试 + 审核 + 返工
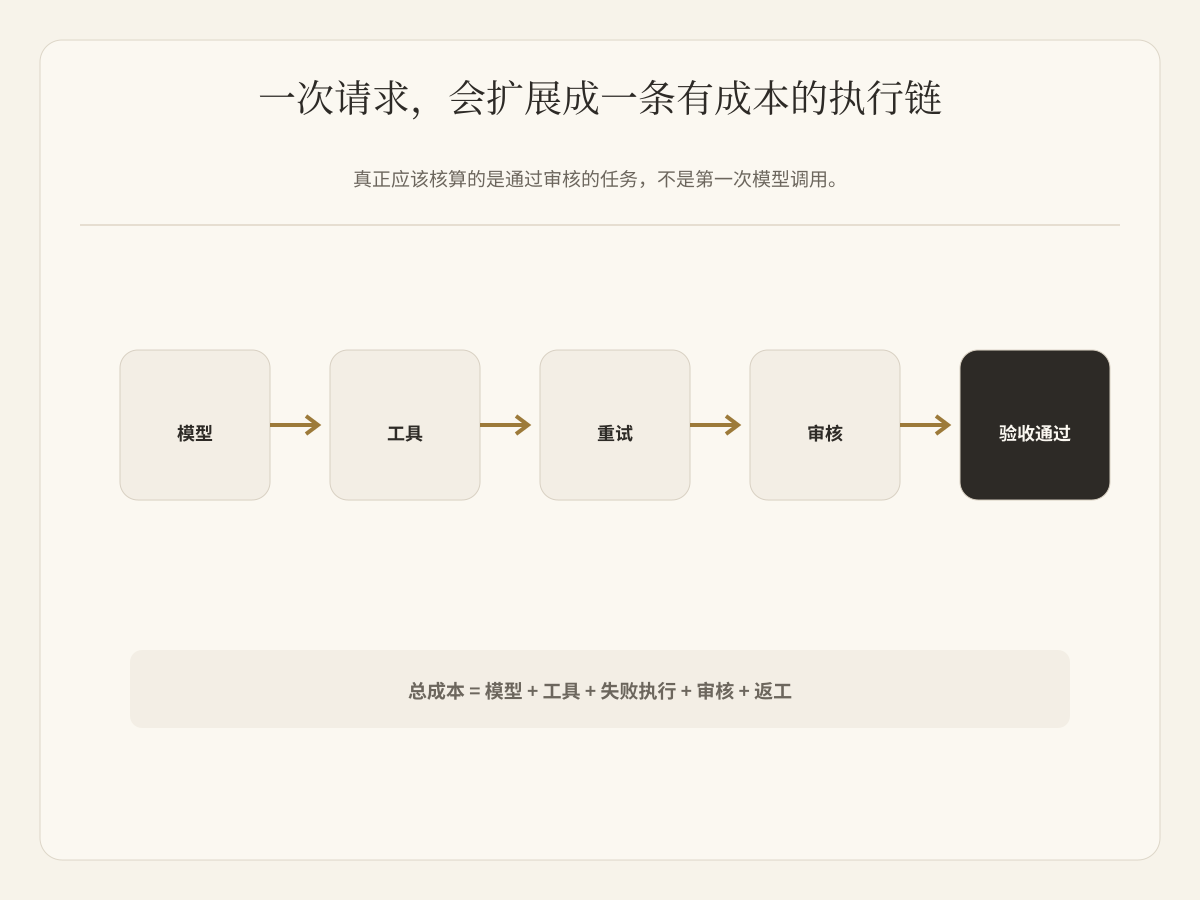
真正容易拉高成本的是输出和重试
Fable 5 的输出单价是未缓存输入的 5 倍。长篇代码改写、冗长报告、重复自检和没有必要的解释,很容易成为主要成本。
重试则会同时放大输入和输出。一次长上下文任务如果跑了三遍,应该看的不是“每次调用贵不贵”,而是三次之后有没有得到一个能通过审核的结果。
至少同时记录四个指标:
- 一次验收通过率
- 模型与工具总消耗
- 完成时间
- 人工修改时间
贵模型如果显著减少失败,单个可用结果可能反而更便宜。反过来,用它做格式转换和简单提取,就是把高价判断能力花在机械步骤上。
100 万上下文是不是要额外付费?
Claude Fable 5 支持 100 万 token 上下文,使用标准每 token 费率。90 万 token 和 9000 token 的单价相同,但前者处理的 token 数是后者的 100 倍。
上下文窗口是容量,不是免费记忆。不要因为“放得下”,就每轮都发送整个代码仓库、文档库和全部对话。更合理的方法是只检索当前决定真正需要的文件和片段。
Cache 和 Batch 分别省什么?
Prompt caching 适合反复读取稳定上下文。Anthropic 当前列出的 Fable 5 cache read 是每百万 token 1 美元,未缓存输入则是 10 美元。缓存写入本身更贵,是否节省取决于后续复用次数。
Batch 会把输入和输出费率都降低 50%,适合离线评测、批量文档审阅、分类和不要求即时返回的任务,不适合互动式 Agent Session。
三种降本方式解决的是不同问题:
- Cache 减少重复处理相同上下文
- Batch 降低异步批量工作的价格
- 模型路由避免机械步骤也使用 Fable 5
现在该选 Fable 5 还是 Fable 5.1?
Anthropic 当前把 Claude Fable 5.1 列为面向高难度推理和长周期 Agent 工作的 Fable 型号。Fable 5 仍然保留在价格表中,但新的评测通常应该把 5.1 纳入候选。
两者标准输入、输出目录价仍是 $10 / $50。Fable 5.1 把 cache read 从 $1 降到了 $0.25 / MTok,同时带来需要重新测试的兼容性变化。具体见Claude Fable 5.1 更新了什么:迁移风险与升级判断。
这篇页面继续回答 Fable 5 价格,因为这是它已有的搜索意图,不会改写成第二篇 Fable 5.1 发布文章。
什么任务值得使用 Fable 5?
当任务难、周期长、信息不完整,或者错误代价很高时,Fable 5 更容易证明自己的成本合理:
- 架构与迁移决策
- 大型代码仓库审查
- 多份资料汇总成决策
- 高影响交付物的最终审核
- 错误规划会引发大量返工的 Agent 任务
简单提取、格式转换、常规分类和容易验收的工具循环,可以交给成本更低的模型。
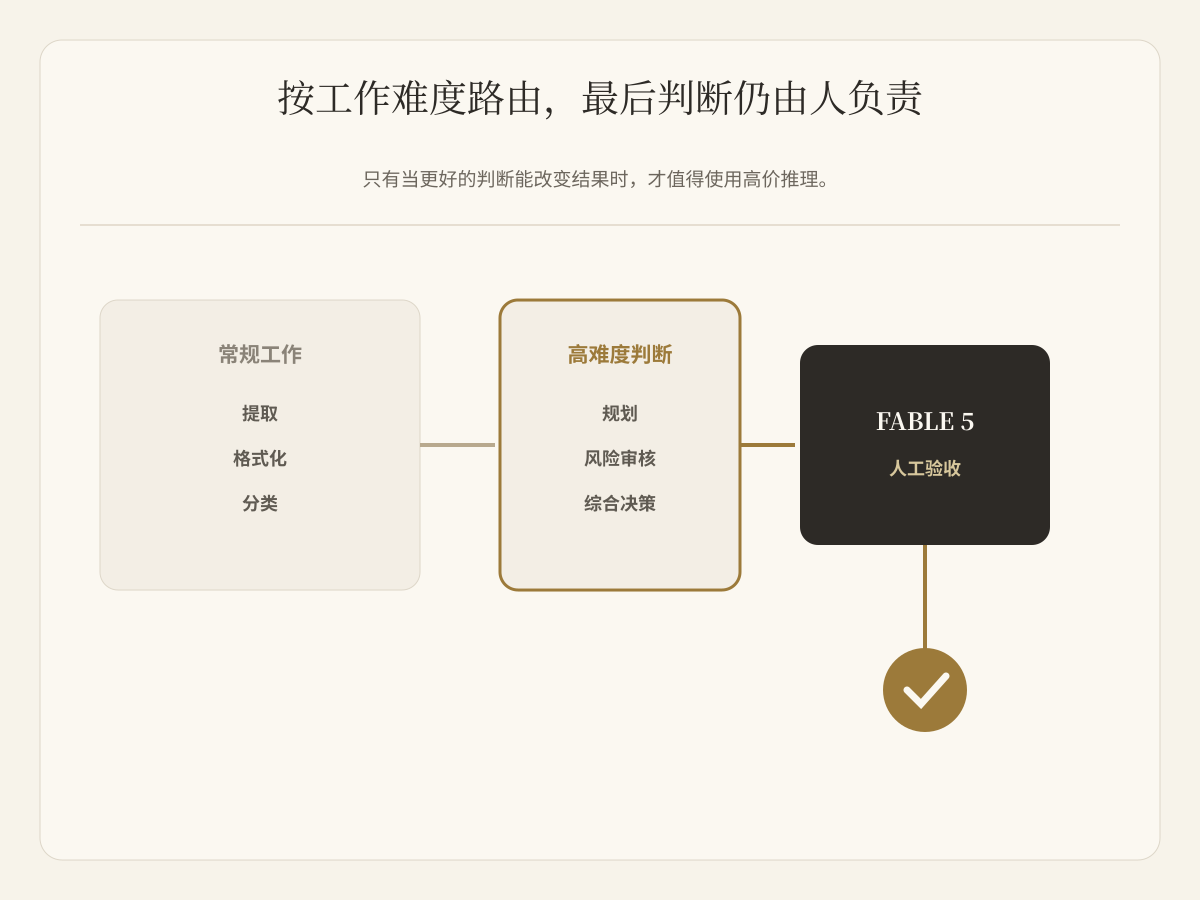
怎么理解 Buda 的 3.3x?
Buda 当前价格页把 Claude Fable 5 列为 3.3x,并定位为最高层级推理模型。这个数字用于比较不同模型的 Credit 消耗强度。
它不是把 Anthropic 美元单价直接换算成固定 Credits。Buda 的实际 Credits 取决于真正发生的工作,型号可用性和倍率也可能变化,大任务执行前应以当前产品界面为准。
更实用的工作方式是:常规执行使用更快的模型,只在判断质量会改变结果时升级到 Fable 5,最后由人负责验收。完整模型路由方法见如何为 AI Agent 选择合适的模型。
常见问题
Claude Fable 5 API 多少钱?
Anthropic 标准目录价是每百万 token 输入 10 美元、输出 50 美元;cache read 是 1 美元;Batch 输入和输出分别是 5 美元、25 美元。
Buda 里的 Fable 5 每次固定扣 3.3 Credits 吗?
不是。3.3x 是相对倍率,不是每次请求的固定扣费。实际 Credits 取决于使用量和任务行为。
100 万 token 是一个固定套餐价吗?
不是。100 万是上下文容量,实际仍按处理的 token 数计费。
Fable 5.1 比 Fable 5 便宜吗?
标准输入和输出费率相同。Fable 5.1 的缓存读取更便宜:每百万 token 0.25 美元,而 Fable 5 是 1 美元。
Agent 每一步都应该使用 Fable 5 吗?
不应该。只把它用在能减少高代价错误的判断步骤,常规、低风险工作交给成本更低的模型。