
GPT-6 Astra 价格详解:为什么 10/50 美元不是一次任务的真实成本
GPT-6 Astra 的 Standard API 目录价是:每百万个未缓存输入 token 10 美元,每百万个输出 token 50 美元。它能告诉你一个 token 的价格,却不能直接告诉你一个 Agent 要花多少钱。
一次完整任务还可能包括缓存写入与读取、工具费用、推理与可见输出、失败重试、长输入加价和人工审核。因此真正应该管理的是每个验收通过任务的成本,而不是每百万 token 的单价。
Standard 文本 token 公式
输入不超过 27.2 万 token 时,当前上游目录价是:
| 用量 | 每百万 token 价格 |
|---|---|
| 未缓存输入 | 10 美元 |
| 缓存读取 | 1 美元 |
| 缓存写入 | 12.50 美元 |
| 输出 | 50 美元 |
基础估算公式是:
文本成本 = 未缓存输入 × 10 美元/MTok + 缓存读取 × 1 美元/MTok + 缓存写入 × 12.50 美元/MTok + 输出 × 50 美元/MTok
应该使用 API 返回的实际用量分类。除非账单确实同时记录,否则不要把同一批 token 既算未缓存输入,又算缓存写入。
Web search、computer use 等托管工具还可能按调用单独计费,需要在预算里另列一行。
用四张账单把价格算清楚
以下只是上游目录价示例,不含税、渠道加价、区域处理和工具费。
1. 一次性分析:0.40 美元
任务输入 2 万个未缓存 token,输出 4000 个 token:
- 输入:
0.020 × 10 美元 = 0.20 美元 - 输出:
0.004 × 50 美元 = 0.20 美元 - 合计:0.40 美元
输出单价是未缓存输入的 5 倍。要求更短、更结构化的成品,可能比少删几段 Prompt 更有效。
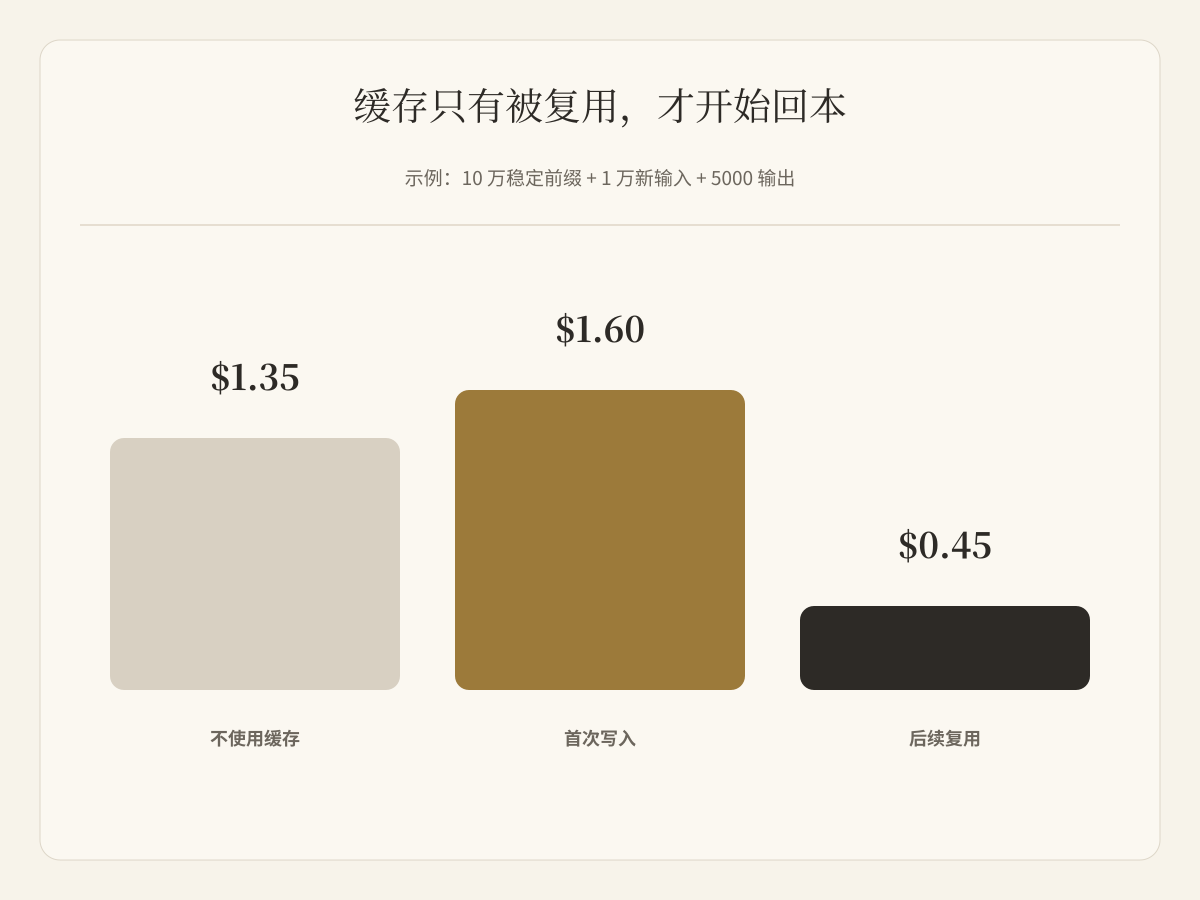
2. 重复使用 10 万 token 前缀:首次 1.60 美元,后续 0.45 美元
假设 Agent 每次都要使用 10 万 token 的稳定规则、代码库上下文和示例,再增加 1 万新输入,并输出 5000 token。
完全不使用缓存,每次是:
11 万输入(1.10 美元)+ 5000 输出(0.25 美元)= 1.35 美元
如果 10 万 token 前缀写入缓存,一个示意性的首次账单是:
缓存写入 1.25 美元 + 新输入 0.10 美元 + 输出 0.25 美元 = 1.60 美元
后续命中缓存则是:
缓存读取 0.10 美元 + 新输入 0.10 美元 + 输出 0.25 美元 = 0.45 美元
首次会多付费;第二次成功复用相较未缓存任务可节省 0.90 美元。前提是这段前缀符合缓存条件、足够稳定,并且真的再次使用。
3. 30 万输入任务:7.50 美元,不是 4 美元
Astra 的输入超过 27.2 万 token 后,整次请求的输入与缓存价格变为 2 倍,输出变为 1.5 倍。
30 万未缓存输入、2 万输出的账单是:
- 输入:
0.300 × 20 美元 = 6.00 美元 - 输出:
0.020 × 75 美元 = 1.50 美元 - 合计:7.50 美元
如果只按首页的 10/50 美元相乘,会得到 4 美元,少算 3.50 美元。原因是跨过阈值后整次请求重定价,不是只给超过 27.2 万的部分加价。
105 万上下文是容量上限,不是使用目标。检索与选择性上下文仍是成本控制手段。
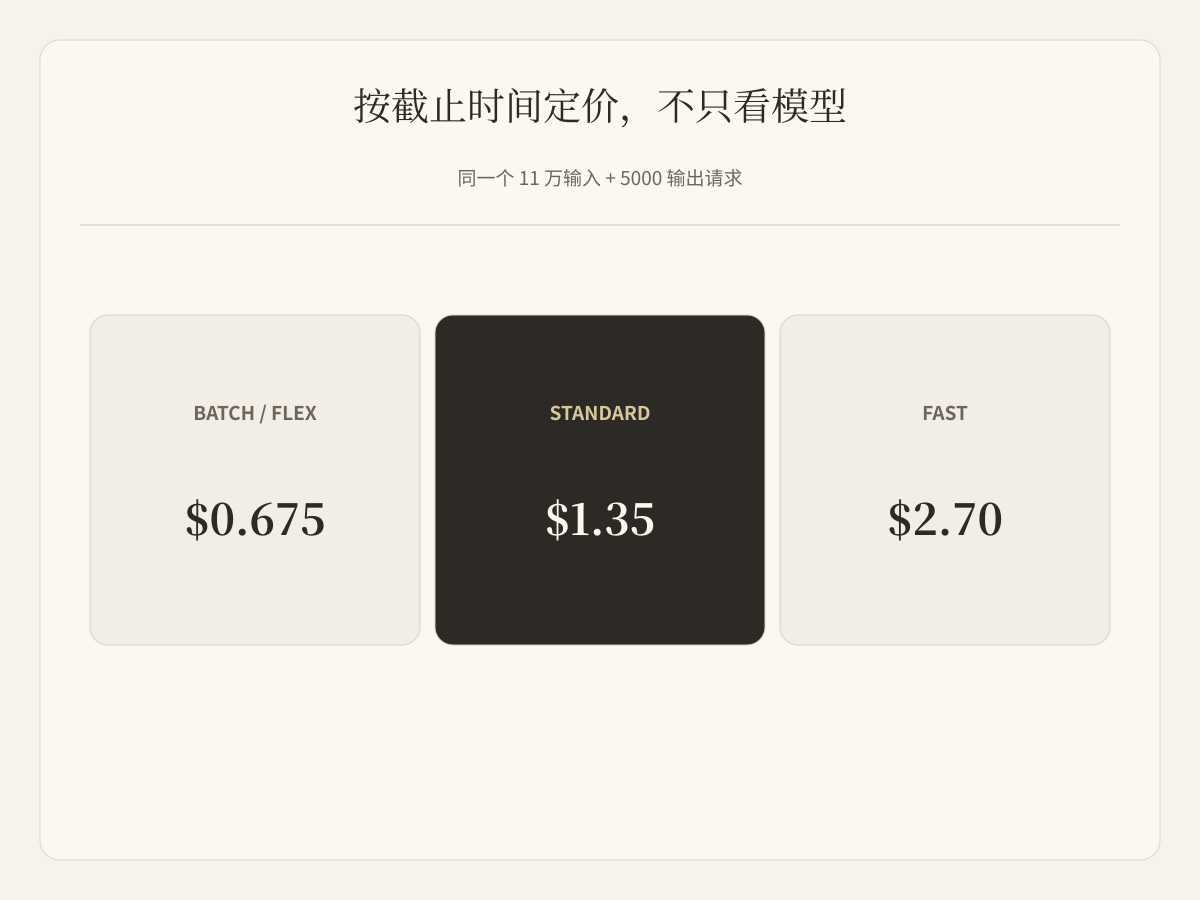
4. Standard、Batch/Flex 与 Fast:1.35、0.675 或 2.70 美元
仍用 11 万未缓存输入、5000 输出的任务:
- Standard:1.35 美元
- Batch 或 Flex:Standard 的 50%,即 0.675 美元
- Fast:适用价格的 2 倍,即 2.70 美元
低价模式用即时性或可预测性换价格;Fast 购买的是低延迟。应该按截止时间选模式,而不是按模型名气选。
每个验收通过任务的成本,才会改变决策
一次调用便宜,但失败更多,不代表工作更便宜。
一个简化的规划公式是:
每个验收通过任务的预期模型成本 = 平均单次成本 ÷ 首次通过率
一次 0.40 美元、首次通过率 80% 的任务,预期模型成本是 0.50 美元。一次只要 0.20 美元、但首次通过率只有 40% 的任务,同样是 0.50 美元,还没有计算审核时间。
这个公式假设重试相互独立,生产环境最终要以真实数据替代。但它把经常被漏掉的分母暴露出来:被接受的工作。
至少记录:
- 模型、effort 和处理模式;
- 未缓存输入、缓存读写、推理与输出;
- 工具调用及费用;
- 重试和 fallback;
- 首次通过率;
- 审核分钟数和修改范围;
- 每个验收通过成品的总成本。
OpenAI 报告 Astra 在部分 coding 和 computer-use 任务上使用更少 token 或更少时间。Artificial Analysis 也认为它的 Coding Agent token 效率很强,但在通用 Intelligence Index 的最高 effort 下,单任务成本比 GPT-5.6 Sol 高 75%。两者可以同时成立:任务结构和 Agent 运行环境决定效率能否抵消更高单价。
六种控制账单的方法
只把高价模型路由到困难步骤
在更好的推理或工具恢复能改变验收结果的环节使用 Astra。提取、分类和格式转换通常可以走更便宜的模型。
限定输出
明确成品、结构、长度和停止条件。输出 token 是文本计费中最贵的一项。
稳定可复用前缀
把规则、示例和不变的项目上下文放在一起,使它们更容易复用缓存。不要无谓地修改 Prompt 前部。
用检索代替填满窗口
只发送当前决策需要的文件和段落。上下文更大,并不会取消相关性排序。
按截止时间选择处理模式
可延迟任务使用 Batch 或 Flex;只有低延迟有业务价值时才使用 Fast。
记录审核和返工
如果一个高价模型能减少工具循环失败和人工修改,它仍可能让单个成品更便宜。必须用自己的验收集验证。
对 Buda 用户意味着什么
以上数字是 OpenAI API 目录价,不是 Buda Credits,也不是对 Buda 售价的承诺。
GPT-6 Astra 暂未在 Buda 上线。后续上线后,模型列表和公开价格页会显示可用范围与 Credit 倍率。实际 Credits 还可能受输入、输出、缓存、工具调用和最低扣费规则影响。
了解发布背景,可以读 GPT-6 Astra 发布指南;按工作选择模型,可以读 GPT-6 Astra 对比 Claude Fable 5.1;查询当前 Buda 模型倍率,请使用公开价格页。
常见问题
GPT-6 Astra 每次请求多少钱?
没有固定答案。需要按 API 返回的用量分类分别乘以费率;输入超过 27.2 万 token 时应用长输入规则,再加工具和基础设施费用。
缓存输入一定更便宜吗?
缓存读取比未缓存输入便宜,但创建缓存比一次普通输入贵。只有稳定前缀被成功复用,才会节省费用。
27.2 万 token 加价只算超出的部分吗?
不是。OpenAI 说明,输入超过 27.2 万 token 后,整次请求的输入与缓存费率为 2 倍,输出为 1.5 倍。
Fast 模式更划算吗?
Fast 是低延迟选项,价格为适用费率的 2 倍。只有节省的时间确实有价值时才划算。
OpenAI 价格就是 Buda Credits 吗?
不是。上游 API 价格与 Buda 面向用户的 Credits 是两套系统。