GPT-6 Astra 对比 Claude Fable 5.1:长任务 Agent 该选谁?
Fable 领先独立综合指数,Astra 在多项工具任务占优;真正要比较的是工作负载、运行环境与验收成本。

GPT-6 Astra 对比 Claude Fable 5.1:长任务 Agent 该选谁?
GPT-6 Astra 和 Claude Fable 5.1 的纸面规格非常接近:约 100 万 token 上下文、12.8 万 token 最大输出,标准上游 API 价格都是每百万 token 输入 10 美元、输出 50 美元。
但它们并不能直接互换。
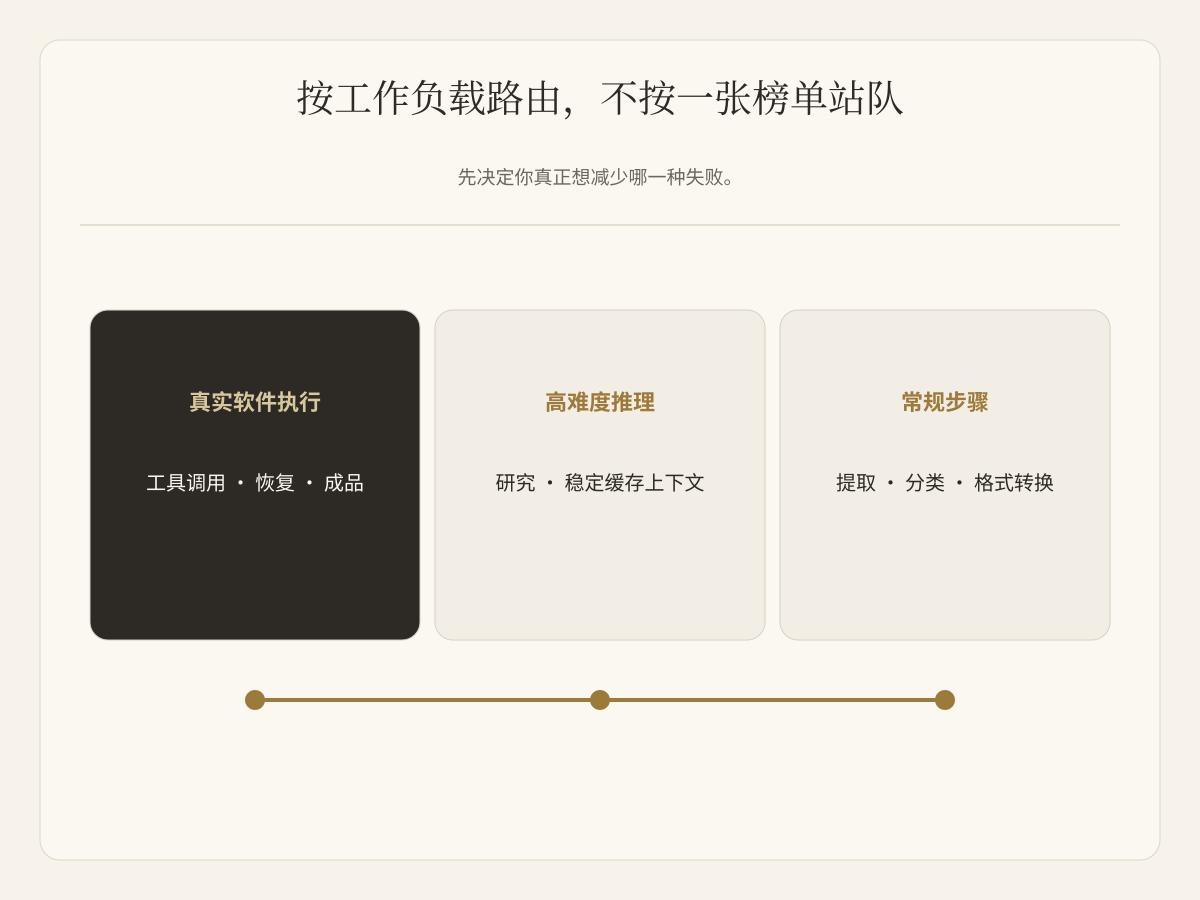
先说结论:高难度推理、多步研究,或者会反复读取大段缓存前缀的任务,可以先测 Fable 5.1;需要操作真实软件、跨多个工具持续执行、恢复失败并交付成品的任务,可以先测 Astra。 最终默认路由应由自己的验收任务决定,而不是由一张总榜决定。
独立综合测试目前更偏向 Fable 5.1
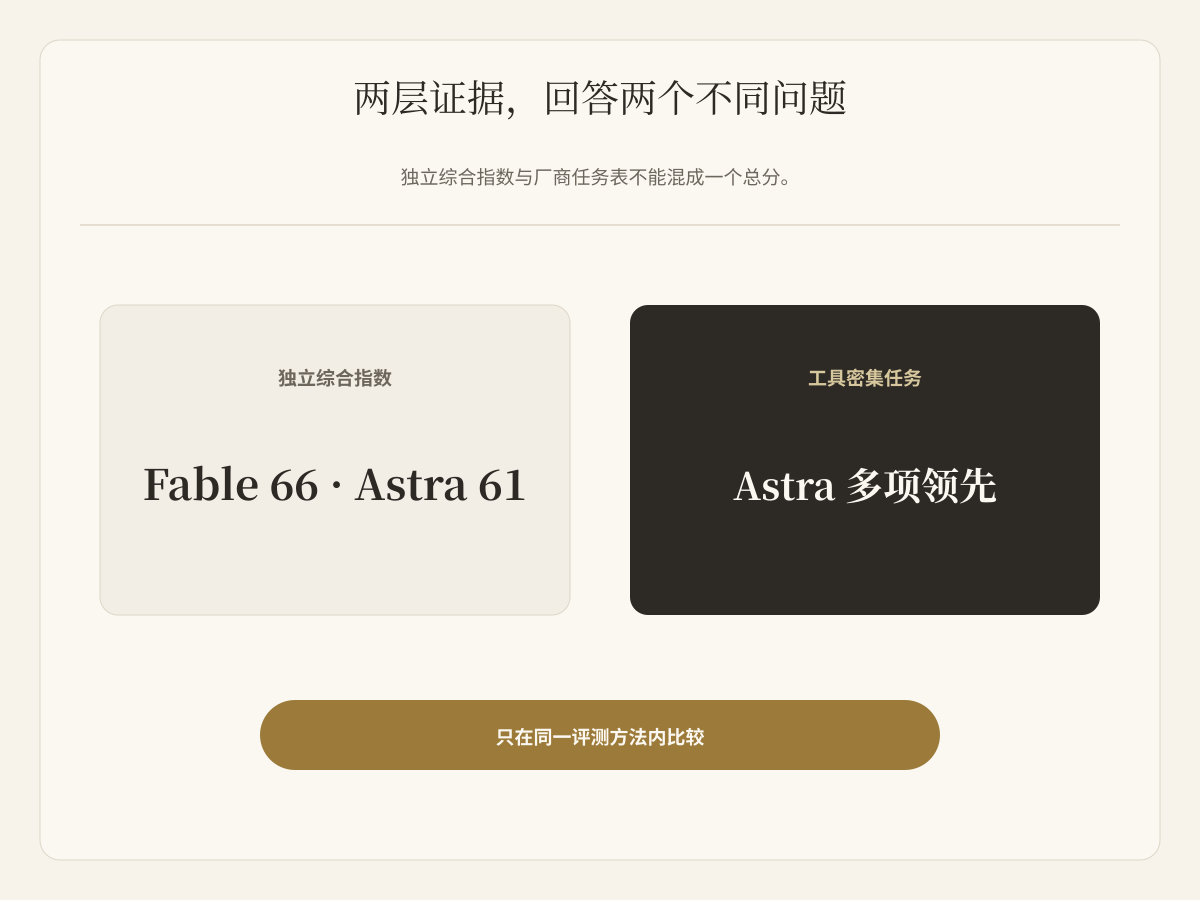
Artificial Analysis 的 Intelligence Index 中,Claude Fable 5.1 在最高 effort 下得到 66 分,GPT-6 Astra 为 61 分。Coding Agent Index 则是 Fable 5.1 得 70 分,Astra 得 67 分。
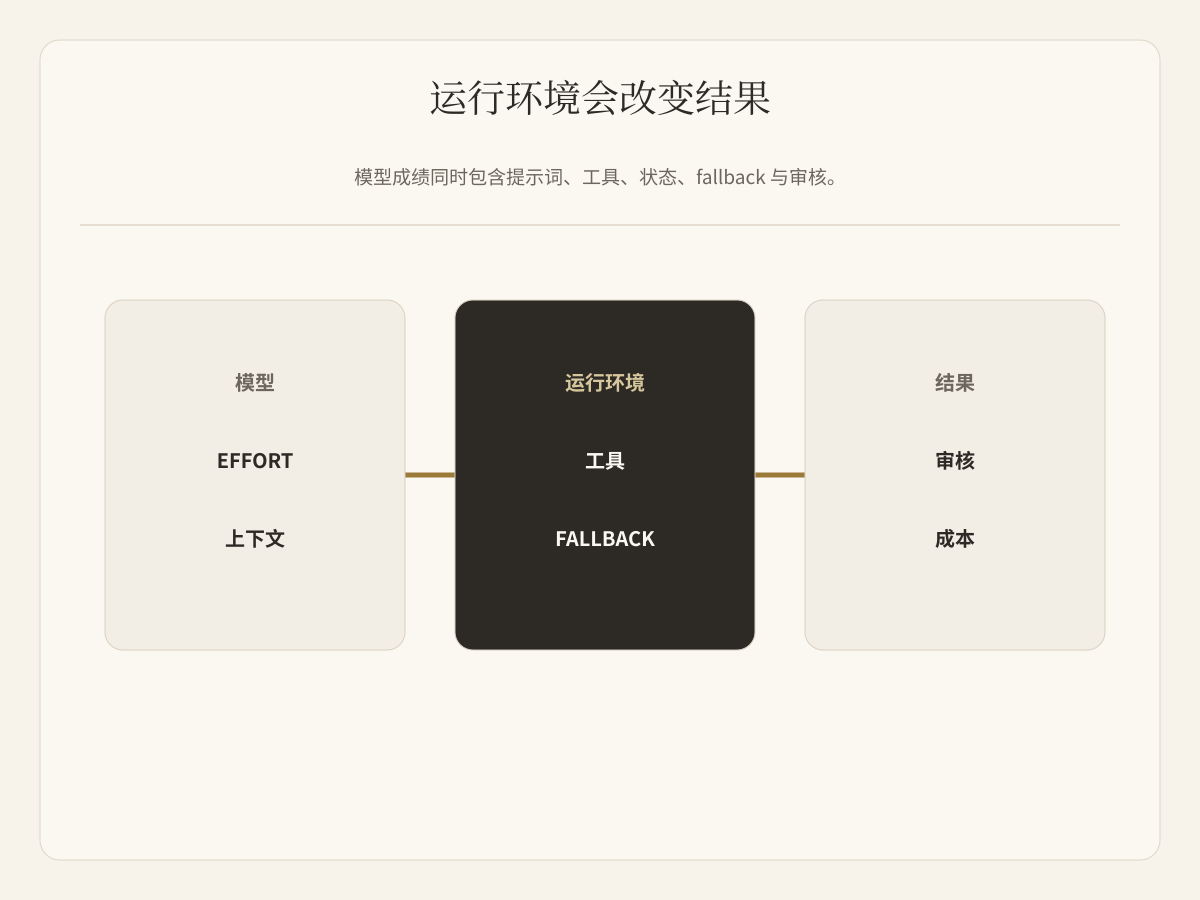
这组独立结果有价值,因为两款模型都经过同一评测方法。但它不代表 Fable 在每项工作上都更强。Fable 这一配置包含最高 effort 和默认 fallback;Coding Agent Index 里的运行环境分别是 Claude Code 与 Codex。它衡量的是“模型 + Agent 运行环境”,不是脱离工具的模型权重。
Artificial Analysis 对 Astra 的结论本身也是混合的:相较 GPT-5.6 Sol,Astra 的 token 效率明显提高,在 Coding Agent 成本曲线上很有竞争力;但在通用 Intelligence Index 中,涨价幅度超过了效率提升,单任务成本反而更高。
OpenAI 的任务表里,Astra 在多项工具工作领先
OpenAI 发布页给出了以下对比:
| 评测 | GPT-6 Astra | Claude Fable 5.1 | 边界 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 55.8% | OpenAI 表格;终端 Agent 配置会影响结果 |
| AutomationBench | 41.4% | 31.4% | SaaS 工作流执行 |
| BenchCAD | 95.9% | 84.3% | Claude 分数使用了文档注明的评测修改 |
| Terminal-Bench Science | 64.6% | 52.6% | 依赖工具的科学工作流 |
| Artificial Analysis Intelligence Index | 61.2 | 65.7 | OpenAI 表中引用的独立指数 |
| Artificial Analysis Coding Agent Index | 67.0 | 67.2 | 在这张快照里基本持平 |
这两组证据并不冲突:Astra 可以在电脑操作、终端和部分专业工作上领先,同时 Fable 仍在更广泛的独立综合指数中领先。
规格相似,运行成本并不相同
两款模型的标准输入、输出目录价相同,上下文和最大输出也接近。真正的差异出现在任务跑起来之后:
- Astra 缓存输入是每百万 token 1 美元;Fable 5.1 cache read 是 0.25 美元。
- Astra 输入超过 27.2 万 token 后,整次请求的输入与缓存价格变为 2 倍,输出变为 1.5 倍。
- 两者都有 50% Batch 折扣;Astra 还有 50% 的 Flex,以及按适用价格 2 倍计费的 Fast。
- Fable 5.1 始终使用 adaptive thinking,并支持在会话中途调整 effort。
- Fable 5.1 的默认 fallback 会改变实际被测系统。
- 工具调用、重试、拒绝、审核和返工,可能比 token 目录价更影响总成本。
有 100 万上下文,不等于每轮都应该塞满 100 万 token。检索和稳定缓存前缀仍然重要。
按你想减少的失败来选
先测 Astra
- Agent 必须操作浏览器或桌面软件;
- 任务同时经过终端、文件、网站和结果验证;
- 长任务经常在转向或失败恢复时丢失目标;
- 交付物是文档、表格、演示文稿或可运行网站;
- 减少工具循环次数能明显降低人工检查成本。
先测 Fable 5.1
- 工作主要是高难度推理或多步研究;
- 长会话会反复读取稳定、可缓存的前缀;
- 现有 Claude 集成已经正确处理 thinking blocks;
- 独立综合指数覆盖的任务更接近你的业务;
- Claude Code 或 Anthropic 原生运行环境已经是现有工作面。
继续用更便宜的模型
- 任务只是提取、分类、格式转换等容易验证的步骤;
- 小模型已经稳定通过验收;
- 升级模型不会减少失败和审核成本。
运行环境可能反转结果
不写运行环境的模型对比是不完整的。Codex 与 Claude Code 的提示词、工具、权限、压缩、fallback、确认策略和状态保存方式都不同。
Astra 发布中有一部分提升来自 Codex,包括可搜索更早的上下文窗口。Fable 5.1 也有自己的会话约束:不支持强制 tool choice;旧模型无法读取它的 thinking blocks;修改更早的消息可能让后续 thinking blocks 失效。
切换生产路由前,用同一组验收任务记录:
- 首次通过率;
- 工具调用和失败恢复;
- 完成时间;
- 输入、缓存、推理和输出消耗;
- 人工修改次数;
- 失败来自模型还是运行环境;
- 单个验收通过任务的总成本。
不要拿裸 API 测试与成熟的第一方 Agent 产品对比,再把结果叫作模型排名。
对 Buda 用户意味着什么
前沿模型只是 Agent 工作区的一部分。团队仍然需要持久文件、真实工具、权限边界、可见执行和人工审核。
GPT-6 Astra 和 Claude Fable 5.1 暂未在 Buda 上线。后续上线后,可用范围和 Credits 会在 Buda 模型列表与公开价格页显示。
了解发布背景,可以读 GPT-6 Astra 发布指南;设计模型路由,可以读如何为 AI Agent 选择合适的模型;Fable 的迁移细节见 Claude Fable 5.1 更新了什么。
常见问题
GPT-6 Astra 比 Claude Fable 5.1 更好吗?
不是所有工作都更好。Fable 5.1 领先当前 Artificial Analysis 综合指数;Astra 在多项厂商报告的电脑操作、终端、自动化和科学任务中领先。
哪个更便宜?
标准输入、输出目录价相同。Fable 5.1 的缓存读取更便宜;Astra 对超过 27.2 万输入 token 的请求加价,并提供 Fast、Batch 和 Flex。应该比较完整任务成本。
谁的上下文更大?
Astra 是 105 万 token,Fable 5.1 是 100 万。实际工作中,检索质量、缓存设计和运行环境如何保存决策通常更重要。
一张榜单能决定默认模型吗?
不能。公开评测用于筛选候选,稳定的内部验收集才用于决定路由。