
選擇之前,先檢查哪些狀態必須跨會話保留,以及恢復後如何驗收。
一個 Agent 在昨天的會話裡完成了三分之二的任務。今天繼續時,它能找到已經修改的檔案,卻忘了為什麼放棄另一條方案,也沒有識別測試還沒跑完。檔案還在,工作卻沒有真正接上。
Buda 和 MiMo Code 都值得從這個問題比較,但不能把它們寫成“有記憶的平臺”和“無記憶的程式碼 CLI”。MiMo Code 的官方 README 明確介紹了跨會話記憶、自動檢查點、任務跟蹤、停止條件以及多個工作流。它的桌面 beta 也覆蓋辦公和瀏覽器任務。Buda 的區別需要落實到持續工作空間與檢查方式,而不是抹掉對方的能力。
如果工作以一個開發專案為中心,需要掌控模型入口、專案記憶和開發工作流,MiMo Code 值得優先試。若主要問題是讓不同業務任務沿用檔案、在會話中操作瀏覽器和終端、持續檢查產物,則應評估 Buda 的 Agent Workspace。 下面把這個判斷拆開。
MiMo Code 的“記住”至少有四層
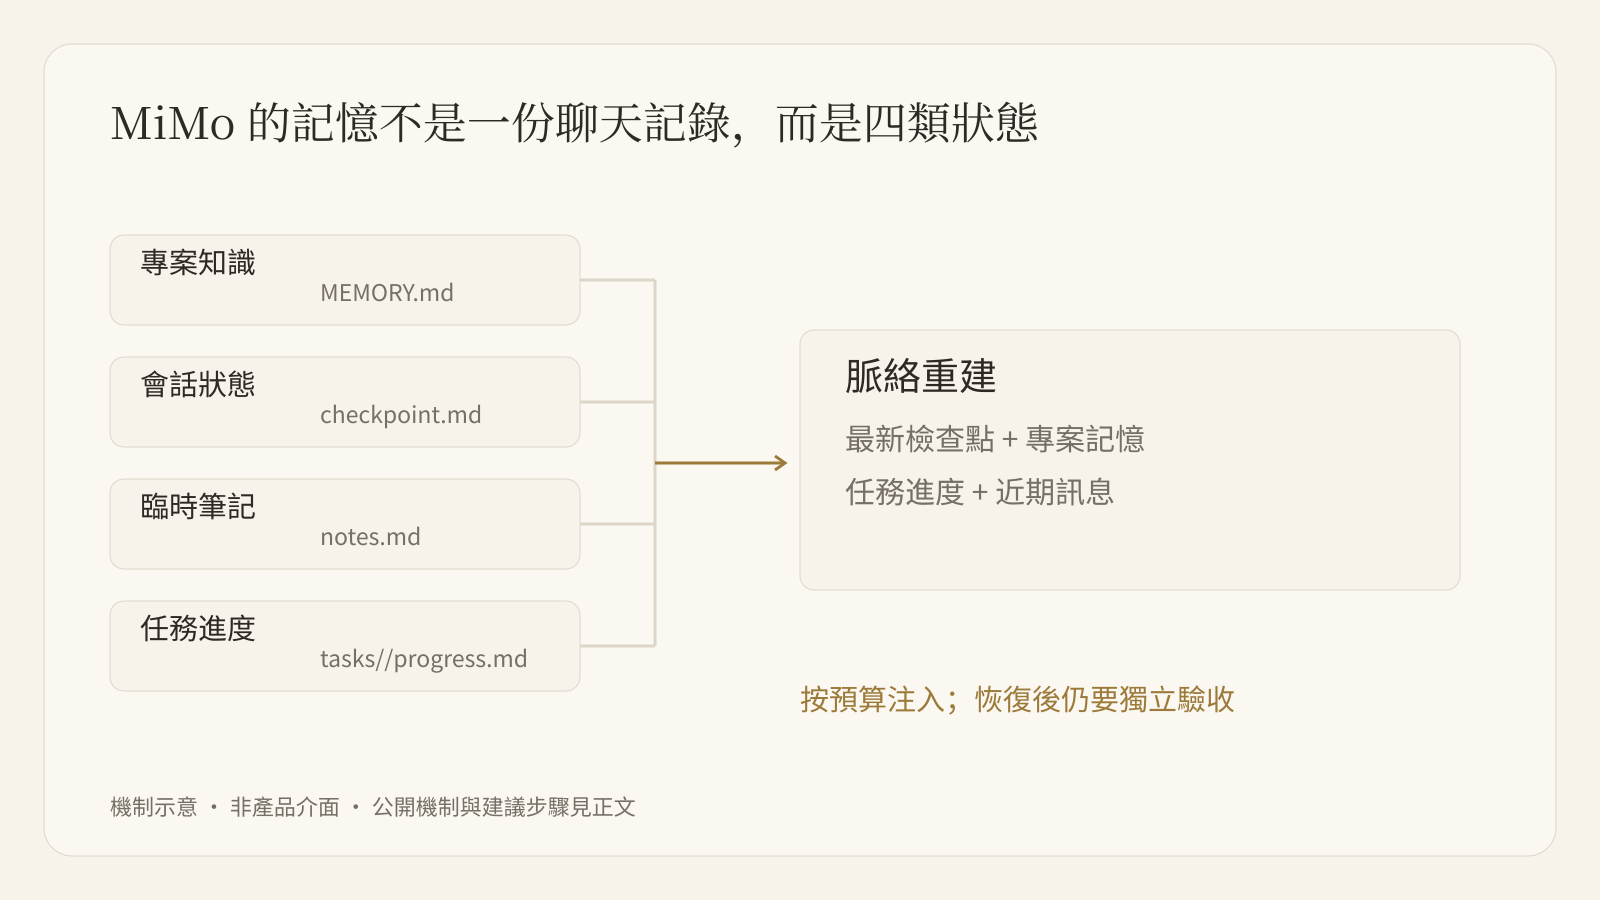
官方 README 描述的記憶系統採用 SQLite FTS5 全文檢索,並分別保留專案知識、會話檢查點、臨時筆記與任務進度。
| 層次 | 官方說明的載體 | 在恢復任務時回答什麼 |
|---|---|---|
| 專案記憶 | MEMORY.md | 專案規則、架構決策和長期知識是什麼? |
| 會話檢查點 | checkpoint.md | 中斷前的狀態與最近進展是什麼? |
| 臨時筆記 | notes.md | 當前有哪些暫存線索或工作筆記? |
| 任務日誌 | tasks//progress.md | 哪項任務執行到了哪裡? |
這比簡單把歷史聊天全部塞回模型更有結構。README 還說明了脈絡重建:當對話接近限制時,用最新檢查點、專案記憶、任務進度和保留的近期訊息重新組織脈絡;注入有 token 預算和重要性排序。使用者也能設定更早的壓縮點。
對長任務,這些機制有明確價值:Agent 不必重新搜尋全部專案,也可以保留已經探索過的方向。但記憶檔案正確存在,不保證它包含了需要的每一個事實。錯誤判斷也可能被記下來,舊約束也可能尚未清理。因此評估記憶要看“恢復後的行為是否正確”,而不只是“有沒有記憶功能”。
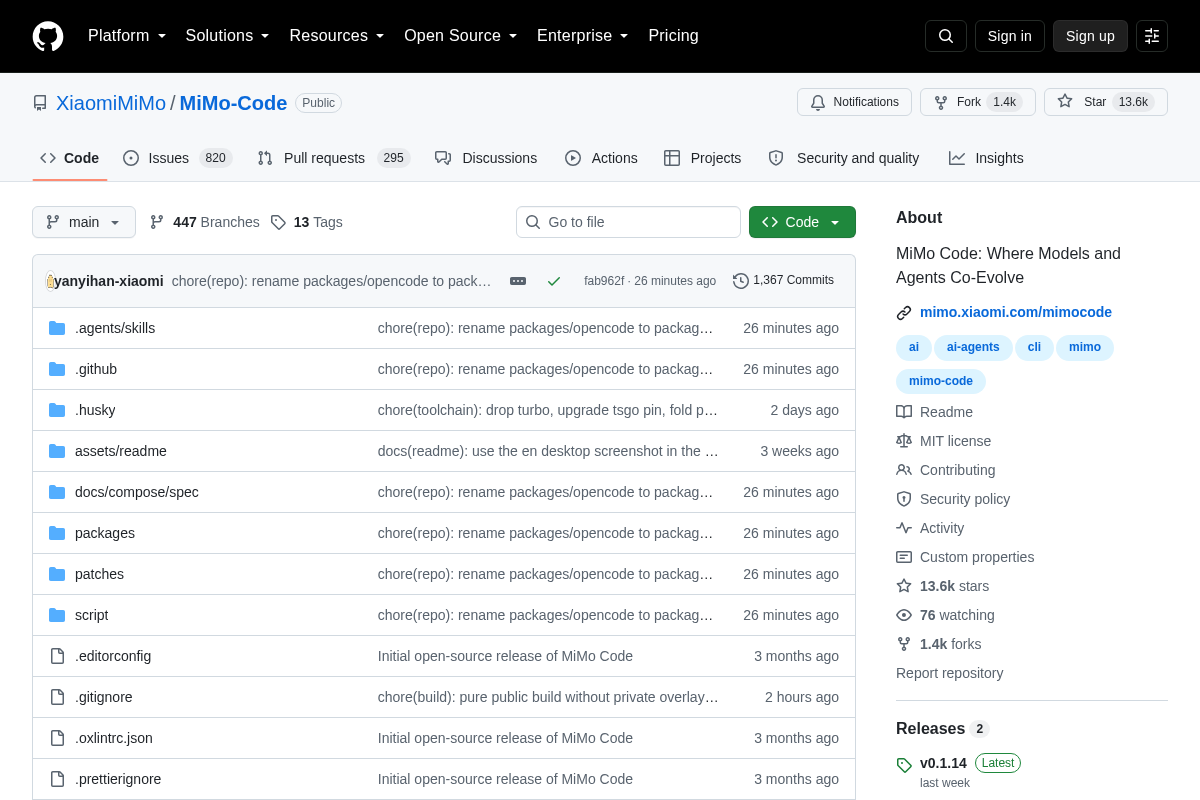
官方英文頁面截圖,來源:產品說明,擷取日期:2026-09-30。保留原文,避免把譯文偽裝成產品介面。
長任務的執行路徑也不是單一模式
MiMo Code 的主 Agent 包括 build、plan 和 compose:build 承擔開發執行,plan 用於只讀分析,compose 用於編排。官方建議在特定前沿模型上透過 build 呼叫 /compose-next,按需求、規格、實現、驗證、審查等階段推進;獨立 compose Agent 則是另一條流程。
此外,README 列出確定性 JavaScript workflows,包括 compose、deep-research、fact-check 和 research-experiment。它們可以固定階段順序、限制重試並行度、儲存檢查點;compose 工作流還描述了隔離 Git worktree、TDD 和階段間結構化輸出。互動路徑適合人中途改變方向,非互動工作流適合範圍已清楚、能分解的任務。
MiMo 的 /goal 停止條件也值得單獨看:Agent 想結束時,由獨立 judge 模型判斷目標是否達到。這能增加一道檢查,但 judge 仍是模型判斷。對於可以執行的測試、可校驗的檔案和生產動作,團隊仍應保留相應證據與人負責的放行步驟。
因此,MiMo 的選擇理由不只在於終端體驗。它把專案恢復、階段編排與結束判定做成了具體機制。如果這些正是團隊需要掌控的部分,應在真實程式碼庫裡驗證它們。
Buda 的比較重點,是工作空間裡能留下什麼
Buda 的 Agent Workspace 將會話與 Drive、終端、瀏覽器、Git 等工具放在一個可持續使用的環境中。Drive 留下原始檔案、工作檔案與產物;人在任務中可以開啟這些檔案、檢視執行過程,也可以在之後的任務中繼續使用它們。
這裡與 MiMo 不是“記憶檔案 vs 完全不需要記憶”的區別。兩個系統都需要清晰的輸入、適當的脈絡與驗收條件。實際選擇是:團隊更希望圍繞專案目錄配置和檢查 Agent,還是在統一工作空間中組織多類工作與產物。
| 需要解決的問題 | MiMo Code 官方資料提供的路徑 | Buda 可評估的路徑 |
|---|---|---|
| 專案會話恢復 | 記憶、檢查點、任務日誌與脈絡重建 | 保留 Drive 資料與既有工作產物,在持續會話中繼續任務 |
| 開發階段編排 | /compose-next 或確定性 workflows | 用可複用 Skill 描述執行與驗收步驟,結合終端和 Git 執行 |
| 人檢查正在做什麼 | 專案檔案、日誌與 Agent 互動 | 在工作空間開啟檔案、終端、瀏覽器和 Git 檢查 |
| 辦公與瀏覽器任務 | MiMo Desktop beta 的獨立能力範圍 | 在 Agent Workspace 執行相應工具並檢查成果 |
這張表列的是公開機制與評估入口,不是效能排行榜。沒有同任務實測時,不應把任何一列改成“更快”或“更可靠”。
辦公任務要單獨核對 MiMo Desktop 的版本邊界
MiMo Code README 的桌面 beta 說明包括多格式檔案、PPT、網頁、3D 資產、區域編輯、版本回滾和瀏覽器控制。國際版本還列有 computer control 與 Record & Replay。桌面應用以 MiMo Code 為核心引擎,但仍是需要申請的 beta;不同版本的功能範圍也有差別。
所以,若需求是“把資料做成演示文件,再到網頁核查”,不能直接說 MiMo 不支援辦公或瀏覽器。要確認自己實際拿到的是哪種入口和版本,再比較能否完成整項任務。README 所述最高快取命中率同樣屬於廠商說明,不應換算成自己的成本節省,更不能當作 Buda 對比結果。
模型連線也有不同操作負擔。MiMo 支援平臺登入、部分 OAuth 路徑、API key 和 OpenAI-compatible 自定義提供商;使用者需要檢查實際模型、端點、認證和脈絡預算。Buda 使用產品內的模型入口時,仍應按公開模型與套餐說明確認可用性。這裡不拿上游 token 單價或一方內部 Credits 去推算另一方價格。
做一次“中斷後繼續”的驗收,比比較記憶容量更有效
下面是建議的評估任務,不是已執行的基準:維護一份研究報告。輸入包括三份原始材料、上版報告、引用規則和新的資料檔案。任務需要校核舊結論、更新兩節分析,再生成一個可交付版本。
第一輪只讓 Agent 完成資料梳理與修改計劃,然後中斷。恢復時不要重講任務,只提供新增材料,觀察四件事:
- 它有沒有繼續使用已確認的來源與版本,而不是重新把舊檔案當最新?
- 已經否決的結論是否再次出現?能否找到否決原因?
- 未完成的檢查是否仍被明確標註,而不是隨總結壓縮而消失?
- 最終報告能否逐條追溯修改依據,並列出尚待判斷的衝突?
在 MiMo 中,檢查點與任務日誌是重要證據;在 Buda 中,Drive 中的原始檔、修改記錄和結果檔案應容易找到。雙方都應保留獨立的驗收清單,不把 Agent 自述“完成”當作唯一標準。
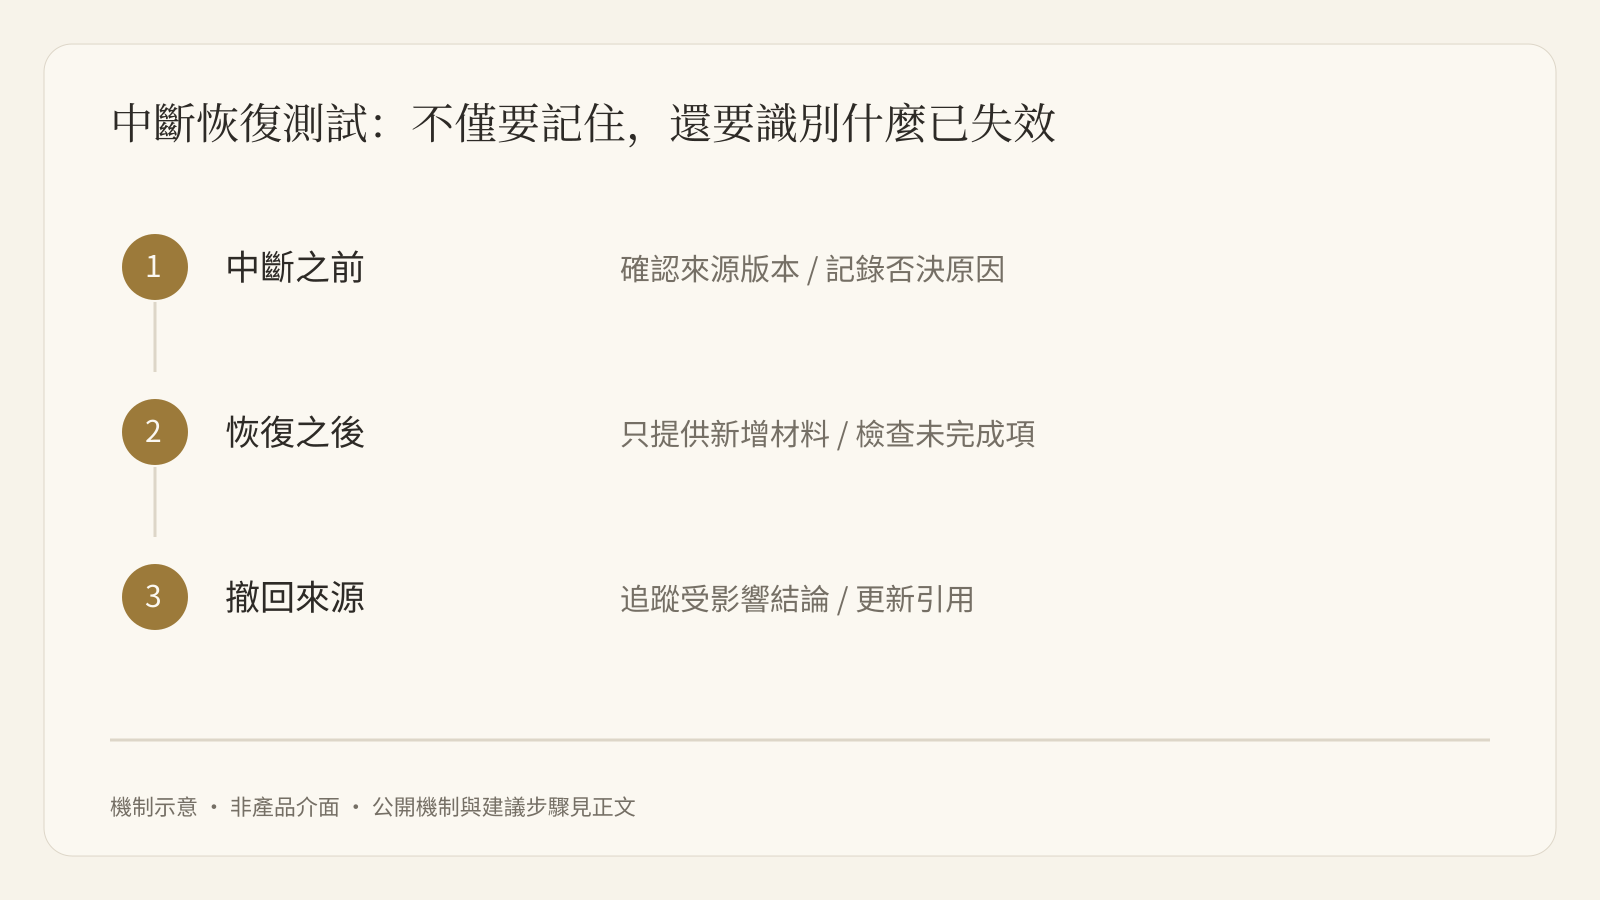
再加入一個人為變更:撤回一份來源,要求修訂依賴它的結論。這個步驟能發現記憶中的舊事實有沒有被正確替換。所謂持續工作,不只是保留過去,更包括識別過去哪些內容已經失效。
實際選擇:看團隊準備承擔哪種管理工作
以開發專案為主要單位、習慣檢查配置和檔案、希望自行選擇模型提供商的團隊,可以先試 MiMo Code。測試重點應包括恢復質量、workflow 的階段證據、停止條件和許可權,而不是隻跑一個生成頁面的演示。
需要讓資料研究、檔案處理、工具執行和後續任務在同一工作空間持續推進的團隊,可以從 Buda 開始。先把來源、輸出和檢查步驟放清楚,再選擇合適的 Skill;可安裝的 Skill 可以在 Buda AI 的 Marketplace 搜尋並安裝。穩定的流程才適合進一步定時化。
同一團隊也可能用 MiMo 處理倉庫開發,用 Buda 組織另一類持續任務。交接時應交付可檢查檔案、版本與未決事項,而不是複製一段“它已經做好了”的聊天摘要。
常見問題
MiMo Code 是不是隻能呼叫小米模型?
不是。官方 README 列出多種提供商、部分 OAuth 入口以及自定義 OpenAI-compatible API。實際登入與模型可用性仍要按所選提供商確認。
MiMo 的持久記憶是否代表所有脈絡都永久完整?
不是。README 說明了注入預算、重要性排序和重建過程。團隊應該驗證關鍵約束有沒有被保留,而不是假設所有歷史訊息都會原樣進入下一輪。
build、compose 和 workflows 應怎樣選擇?
先判斷任務是否還需要互動改變方向。官方把 build 加 /compose-next 作為一條推薦開發路徑;確定性 workflows 更適合已明確、可拆分的任務。具體功能與模型建議以當前 README 為準,不必為了多 Agent 而拆開本來簡單的工作。
MiMo Desktop 與 MiMo Code 的能力可以混寫嗎?
不應混寫。CLI 是公開說明的終端原生助手;桌面應用是以它為核心引擎的 beta,版本和申請資格需要核對。電腦控制明確有國際版本邊界。
哪個更能防止任務“假完成”?
MiMo 公開描述了 /goal judge 和階段驗證;Buda 可以保留產物與工具執行供檢查。沒有同任務實測,不能宣稱任何一方徹底消除了假完成。可執行驗收與明確負責人應獨立於 Agent 的自述。
來源
核對日期:2026-09-30。功能依據公開說明;研究報告的中斷測試為建議方案,未執行效能或效率對比。