
Claude Fable 5.1 更新了什麼:遷移風險與升級判斷
Claude Fable 5.1 是 Anthropic 目前的 Fable 型號,面向高難度推理與長週期 Agent 工作。它維持 Fable 5 的輸入、輸出目錄單價,把 cache read 降到原來的四分之一,並加入更適合長任務的控制能力。
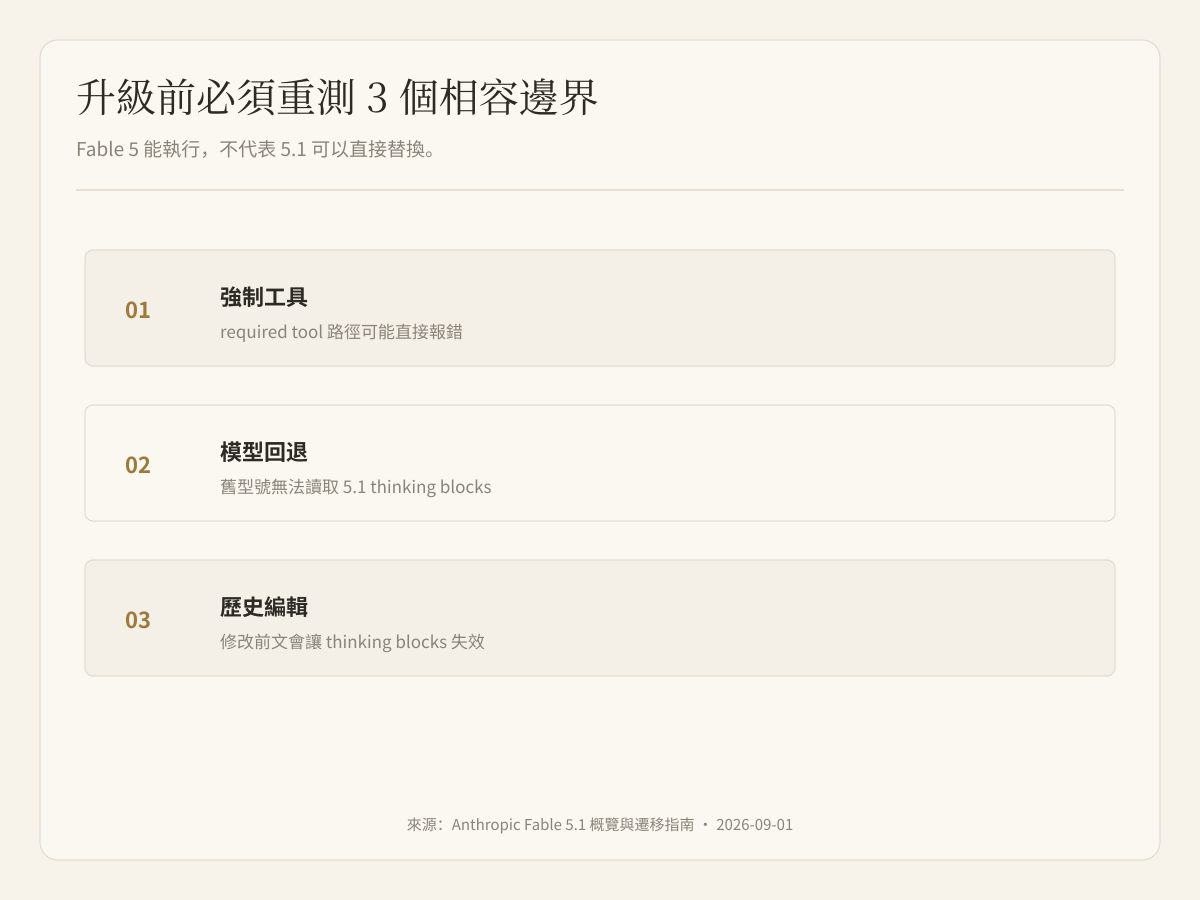
但這不是只改模型 ID 就能完成的升級。官方同時列出 3 項相容性變化,分別影響強制工具呼叫、跨模型讀取 thinking blocks,以及修改歷史對話後的狀態有效性。
先說結論:多數任務仍應先從 Claude Opus 5 開始。只有 Opus 5 在較高 effort 下仍無法通過你的驗收,才值得評估 Fable 5.1。 上線前要跑真實任務評測,而不是只看一次漂亮的示範。
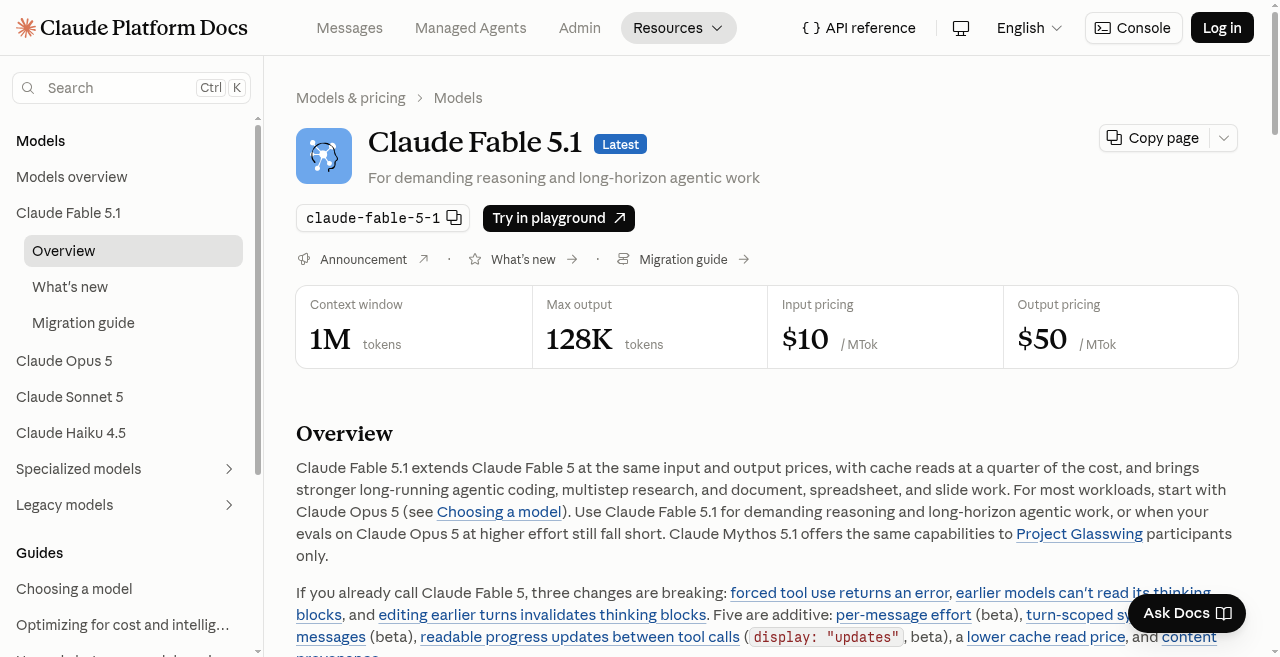
來源:Anthropic Claude Platform 文件,截圖於 2026 年 9 月 2 日。
Claude Fable 5.1 是什麼?
Anthropic 於 2026 年 9 月 1 日發布 Claude Fable 5.1。官方規格包括:
- 100 萬 token context window
- 最大輸出 12.8 萬 token
- 始終啟用 adaptive thinking
- 可靠知識截止時間為 2026 年 6 月
- 適合長週期 Agent coding、多步驟研究,以及文件、試算表和簡報工作
官方也給了一個重要限制:大多數工作先使用 Opus 5;當 Opus 5 提高 effort 後仍不夠,再使用 Fable 5.1。
換句話說,Fable 5.1 更像需要按條件呼叫的高階專家,不是每一步都要使用的預設模型。
Fable 5.1 與 Fable 5 的差異
| 項目 | Fable 5 | Fable 5.1 | 實際影響 |
|---|---|---|---|
| 狀態 | Active,legacy | Active,latest | 新評測應以 5.1 為主 |
| Context | 1M | 1M | 沒有增加 |
| 最大輸出 | 128K | 128K | 沒有增加 |
| 上游輸入/輸出目錄價 | $10 / $50 每百萬 token | $10 / $50 每百萬 token | 基礎單價不變 |
| Cache read | $1 每百萬 token | $0.25 每百萬 token | 重複讀取長 context 更便宜 |
| 長任務控制 | 舊能力 | per-message effort、turn-scoped system messages、可讀進度更新 | 執行過程更容易控制 |
| 內容溯源 | 舊能力 | content provenance | 支援的輸出更容易追蹤 |
這些是 Anthropic 上游 API 目錄價,不是 Buda 價格。Buda 可能使用 Credits、倍率、最低扣費、工具呼叫與 cache 等不同規則。本文也沒有確認 Fable 5.1 已在 Buda 上線。
升級前必須檢查的 3 個相容性變化
1. 強制工具呼叫可能報錯
如果 Agent 強制指定某個 tool,舊版本可以執行的請求,在 Fable 5.1 可能直接返回錯誤。所有 required-tool 路徑都要重新測試。
2. 較早型號不能讀取它的 thinking blocks
如果 workflow 從 Fable 5.1 切回較早型號,舊型號可能無法接續讀取 thinking blocks。模型 fallback 必須用多輪任務驗證。
3. 修改前面的對話會讓 thinking blocks 失效
Agent framework 常會壓縮歷史、修改舊訊息或從中途分支。這些動作可能讓已有 thinking blocks 失效。請測試 context compaction、重試、分支與人工修訂。
哪些任務值得升級?
以下條件同時成立時,Fable 5.1 才較可能值得:
- 任務持續時間長,包含多階段判斷與執行
- 錯誤成本高,返工會影響真實業務結果
- Opus 5 在合適 effort 下仍無法達標
- Workflow 會反覆讀取大量穩定 context
- 最終成果或高影響動作仍由人審核
如果工作重複、低風險、重視低延遲,或結果很容易驗證,更便宜的模型通常更合適。
Cache read 降價,不代表整項任務便宜 75%
長任務會反覆讀取指令、工具定義、文件和歷史。Cache read 從 $1 降到 $0.25 / MTok,的確能降低一部分成本。
但總成本還包含未快取輸入、輸出、推理、工具、subagent、失敗執行、重試、人工審核與返工。比較模型時,應計算:
單個驗收通過任務的總成本 = 模型 + 工具 + 失敗執行 + 重試 + 審核 + 返工
一份更穩妥的遷移清單
- 在測試環境固定
claude-fable-5-1。 - 使用真實業務任務建立 evaluation set。
- 測試所有強制工具呼叫。
- 測試 model fallback 與 thinking blocks。
- 測試歷史壓縮、編輯、重試和分支。
- 比較通過率、總成本、延遲與人工修正次數。
- 先在有限 workflow 灰度,不直接換掉全域預設。
- 保留不依賴不相容 thinking state 的回滾路徑。
對執行 Agent 的團隊意味著什麼?
模型越強,單次自主執行可能走得越遠。權限、過程可見性、評測與人工審核也因此更重要。
Buda 提供的是這一層工作環境:Agent 在持久檔案與真實工具上執行,人可以查看 Session 和產物,並在高影響結果進入外部系統前保留審核權。模型選擇只是其中一環;更重要的是工作有邊界、過程可見、結果可接管。
延伸閱讀:如何為 AI Agent 選擇合適的模型。舊版本背景可見 Claude Fable 5 已在 Buda 上線。Fable 5.1 的 Buda 可用性與 Credits 請以目前產品頁面為準。
常見問題
Fable 5.1 比 Fable 5 便宜嗎?
上游輸入、輸出目錄價不變。Cache read 從 $1 降到 $0.25。實際總成本取決於 cache 命中、輸出、工具、重試與返工。
所有 Fable 5 工作都應立刻遷移嗎?
不應該。先跑評測與相容性測試,尤其是強制工具、混合模型 Session 與歷史訊息編輯。
Fable 5.1 是否全面優於 Opus 5?
不是。Anthropic 建議多數工作先從 Opus 5 開始。
Fable 5.1 已在 Buda 上線嗎?
型號可用性與 Credits 會隨產品更新,請以 Buda 目前的模型列表為準。本文中的 Anthropic 目錄價是上游參考價格,不是 Buda Credits。