
Anthropic 於 2026 年 10 月 7 日釋出 Claude Haiku 5.5。這次更新同時推進了小模型的能力、速度和價格:電腦操作與推理評測較 Haiku 4.5 明顯進步,首次為 Haiku 系列加入可調 effort,100k tokens 以內請求的 token 單價下降 90%。
它的定位仍然很明確:摘要、分類、資料庫查詢、上下文壓縮,以及大任務中的短小子任務。對於頻繁呼叫模型的應用,變化不只是“一次回答更便宜”,而是一些過去成本過高、或舊小模型做不好的步驟,現在多了一個值得驗證的選項。
小模型的進步,體現在哪些任務上?
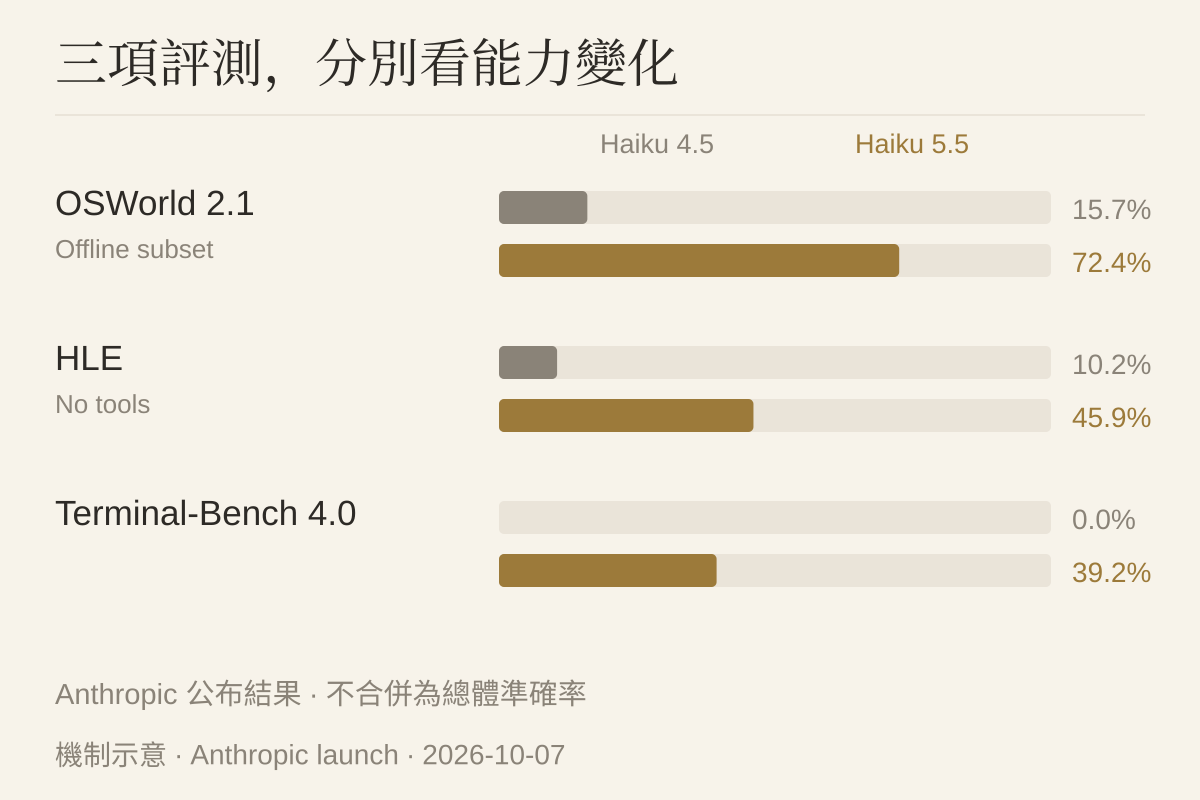
Anthropic 公佈的評測覆蓋知識工作、電腦操作、推理、程式設計和圖表理解。以下三項最能說明 Haiku 4.5 到 5.5 的變化:
| 評測 | Haiku 4.5 | Haiku 5.5 | 測什麼 |
|---|---|---|---|
| OSWorld 2.1,offline subset | 15.7% | 72.4% | 電腦上的多步驟任務 |
| Humanity’s Last Exam,無工具 | 10.2% | 45.9% | 專家級知識與推理 |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 命令列中的複雜任務 |
這些是 Anthropic 釋出頁列出的評測結果;設定和完整方法見其系統卡。不同評測衡量的能力不同,不能把它們合併成一個“總體準確率”。
電腦操作的提升尤其值得關注。除了模型更新,Anthropic 還為 Python 和 TypeScript SDK 增加了 beta 版 computer use 與 browser use 支援。對需要在網頁或桌面上完成動作的應用,模型能力和開發工具都在往前走,但接入、許可權與結果檢查仍需要應用自己處理。
第一次可以為 Haiku 調整思考投入
Haiku 5.5 是首個提供可調 effort 的 Haiku 模型。釋出頁展示了 low、medium、high、xhigh 和 max 不同投入下的表現與成本曲線。
這改變了小模型的使用方式:簡單分類和短查詢不必與複雜分析使用同一檔思考投入;需要更強推理時,也可以先提高 effort,再決定是否換更大的模型。每一檔是否划算,仍要用實際任務的正確率、延遲和成本判斷,釋出頁沒有給出一檔適合所有工作的設定。
速度方面,Anthropic 將它稱為標準速度下最快的 Claude 模型;這一表述不包括 Opus Fast Mode。釋出頁中的 Asana 早測還報告,任務完成延遲降低超過 30%,單次 Agent 回合的推理速度最高提高 2.5 倍。這是客戶在自己的評測套件中得到的結果,不是所有應用都能獲得的固定加速。
高頻工作,比整包複雜專案更適合它
釋出頁的客戶案例給出了更具體的工作分工。
- **AlphaSense:文件中的短問題。**其 Ask in Document 業務每週約有 800 萬次生產呼叫。公司用 400 條查詢測試新模型,報告結果從 Haiku 4.5 的 0.76 提升到 0.84;這裡的數值沿用客戶評估口徑。
- **HubSpot:CRM 中的明確任務。**模擬客戶工作區的測試套件中,Haiku 5.5 三次執行平均得分為 92.8%。其中一項任務是找出陳舊但含義模糊的記錄。
- **Rogo:把短查詢交給子 Agent。**大模型負責製作簡報,Haiku 子 Agent 去 10-K 中提取所需的分部收入,再把結果交回。
這些都是 Anthropic 收錄的客戶早測。共同點不是“把整份工作交給便宜模型”,而是把邊界明確、呼叫量大、結果能核對的步驟分出來。對業務應用而言,分類、提取、短摘要和查詢往往比完整專案更容易判斷模型是否夠用。
複雜 agentic coding 仍有明顯差距。同一釋出頁中,Sonnet 5.5 的 Terminal-Bench 4.0 結果為 70.6%,Haiku 5.5 為 39.2%。Anthropic 繼續把 Sonnet、Opus 放在複雜程式設計任務的位置,Haiku 則承接更窄的工作。
價格分兩檔:短請求降 90%,長請求降 50%
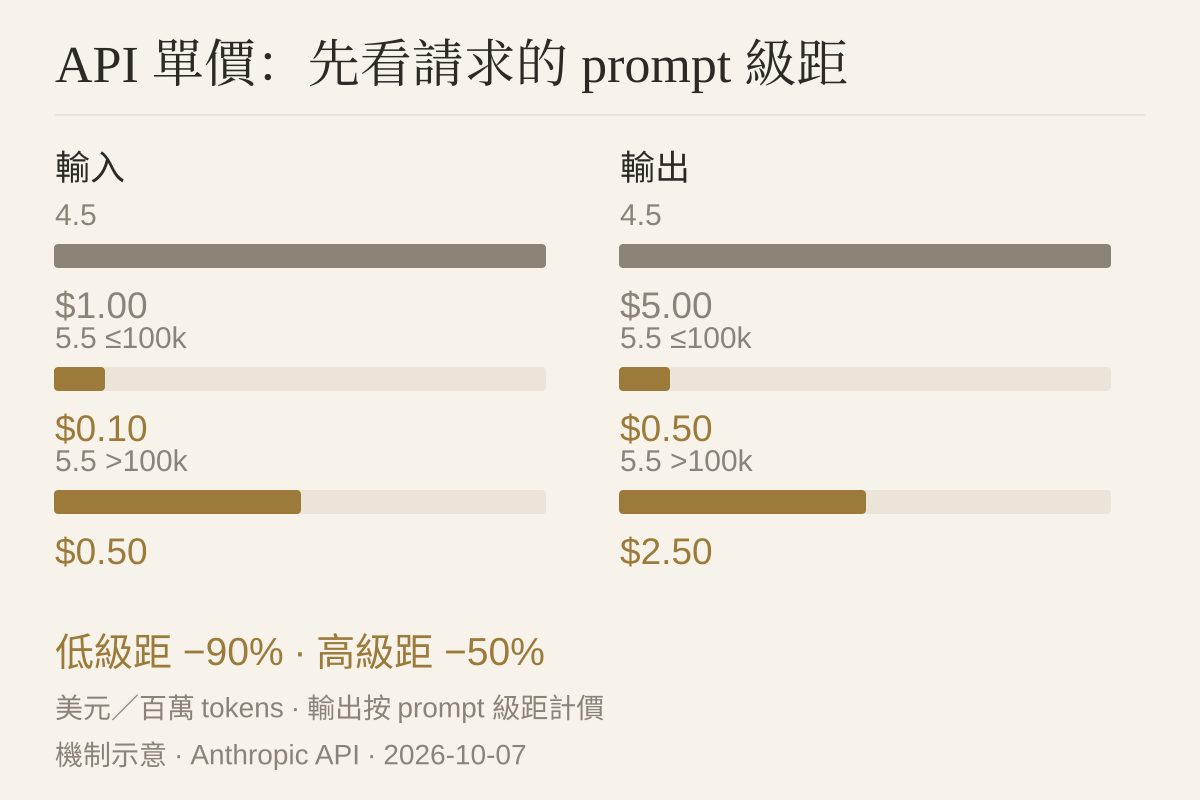
Anthropic API 的每百萬 token 公佈單價如下:
| 專案 | Haiku 4.5 | 5.5 prompt ≤100k | 5.5 prompt >100k |
|---|---|---|---|
| 輸入 | $1.00 | $0.10 | $0.50 |
| 輸出 | $5.00 | $0.50 | $2.50 |
| 快取讀取 | $0.10 | $0.01 | $0.05 |
| 快取寫入 | $1.25 | $0.125 | $0.625 |
低檔四項單價都比 4.5 低 90%,高檔低 50%。輸出也按對應請求的 prompt 長度檔計價,不能把所有請求都按 $0.50/百萬輸出 tokens 估算。
Anthropic 表示,舊 Haiku 約 90% 的請求落在 100k 以內,這也是短請求價格變化更有實際意義的原因。這裡的“90% 請求佔比”和“90% 降價”是兩個不同資料。
為什麼官方說平均任務成本降低約 75%?
token 單價下降,不等於相同工作按同一比例省錢。Haiku 5.5 使用新 tokenizer;遷移指南說明,相同輸入文字平均約產生 30% 更多 tokens,具體增幅隨內容變化。思考投入、輸出長度和重試也會改變任務用量。
所以 Anthropic 的“平均執行成本降低約 75%”考慮了完成工作所需 tokens 的變化,而不只是低檔單價。實際評估應比較同一批任務的完成質量和總成本,並用 5.5 重新計數,尤其關注接近 100k 分界線的輸入。
對應用的意義是:可以重新評估過去因成本被壓縮的摘要、文件問答或子 Agent 呼叫;是否擴大呼叫量,應由任務結果和實測賬單決定,而不是隻看價格表。
已公佈的入口,以及升級前的提醒
Anthropic 宣佈 Haiku 5.5 在 Claude Platform、AWS、Google Cloud 和 Microsoft Azure 可用;Claude API 的固定模型 ID 是 claude-haiku-5-5。
現有整合升級前,仍需檢查相容性。Managed Agents 的指南只要求更新模型名;Messages API 則涉及 thinking、響應解析、取樣引數、assistant prefill 和工具等變化。詳細修改見官方遷移指南,不應只替換 ID 後直接放大流量。
Haiku 5.5 的核心變化,是高頻、範圍明確的任務獲得了更強、更低價的小模型選項。先找出應用中真正反覆發生的一步,再比較完成質量、延遲與成本,才能判斷這次更新能改變哪部分工作。
核驗:2026-10-09。評測、價格與客戶早測來自 Anthropic 釋出頁;tokenizer 與相容性說明來自官方遷移指南。以上模型表現依據來源評測,未經獨立複測。