Claude Opus 5.5 價格詳解:為什麼 4/20 美元不等於一次 Agent 任務成本
Token 單價只是第一層,effort、快取、重試、工具與審核共同決定任務總成本。

Claude Opus 5.5 價格詳解:一次 Agent 任務到底要花多少錢?
一次任務連續呼叫模型十幾次,最後還要有人檢查和返工。看到 Opus 5.5 輸入每百萬 token 4 美元、輸出 20 美元的目錄價,並不能據此估出這次交付的成本。決定賬單的是上下文怎樣重複、工具迴圈走了幾輪,以及最後的產物有沒有過驗收。
先把單價算明白
按 Anthropic 公佈的標準 API 價格,Opus 5.5 的輸入和輸出分別是每百萬 token 4 美元與 20 美元;Opus 5 是 5 美元與 25 美元。單價降低了 20%。快取讀取的價格分別是每百萬 token 0.20 美元與 0.50 美元;Opus 5.5 的五分鐘和一小時快取寫入分別是 5 美元和 8 美元。使用 Fast mode 或 Batch,則要按各自價格和處理時延重新算。
Anthropic 還稱預設設定下的典型任務成本下降約 40%,並稱輸出速度提升超過 30%。前者不只是“單價打八折”,還包含其測試中使用的 token 和步驟變化。這是廠商測試結果;團隊自己的任務如果重試增加、快取失效或驗收率下降,賬單不會自動下降 40%。
一次任務為什麼會把同一份材料付費多次
以修改一箇中型程式碼倉庫為例:Agent 首先閱讀需求和倉庫規則,隨後搜尋檔案、修改程式碼、執行測試、讀取錯誤,再改一次。每輪都可能帶上系統指令、工具定義、已有對話、程式碼片段和測試輸出。不是隻有最初的問題消耗輸入 token;失敗後的重複上下文也在計費。
快取可以降低重複讀取穩定材料的成本,但要記錄實際命中率和寫入次數。過早拆分快取字首、頻繁調整工具定義或反覆注入整份倉庫,都可能讓預期中的快取優勢消失。長上下文是容量,不是應把全部歷史放進每一次請求的理由。
輸出也不只包括螢幕上看到的最終答覆。Opus 5.5 的 adaptive thinking 始終開啟,effort 可以調節思考深度;思考 token 消耗輸出預算。預設 medium effort 是一個可複測的起點,先用真實任務驗證,再決定哪裡需要提高。
用一張任務賬本代替價格印象
對每個任務,至少分開記四筆:模型費用(含輸入、輸出和快取)、付費工具或外部 API、執行時間,以及稽核和返工。再記錄提交了多少次、測試透過了幾次、最終有多少產物被接受。
一個實用口徑是:每個透過驗收的產物總成本 = 全部嘗試的模型與工具成本 + 稽核返工成本,再除以最終透過驗收的產物數。如果五次嘗試只交付三份可用結果,不能拿五次請求的平均價格冒充“每份交付成本”。人工時間也不要隨手摺成 token;兩項應同時展示,內部需要做採購決策時再按本團隊的人力口徑折算。
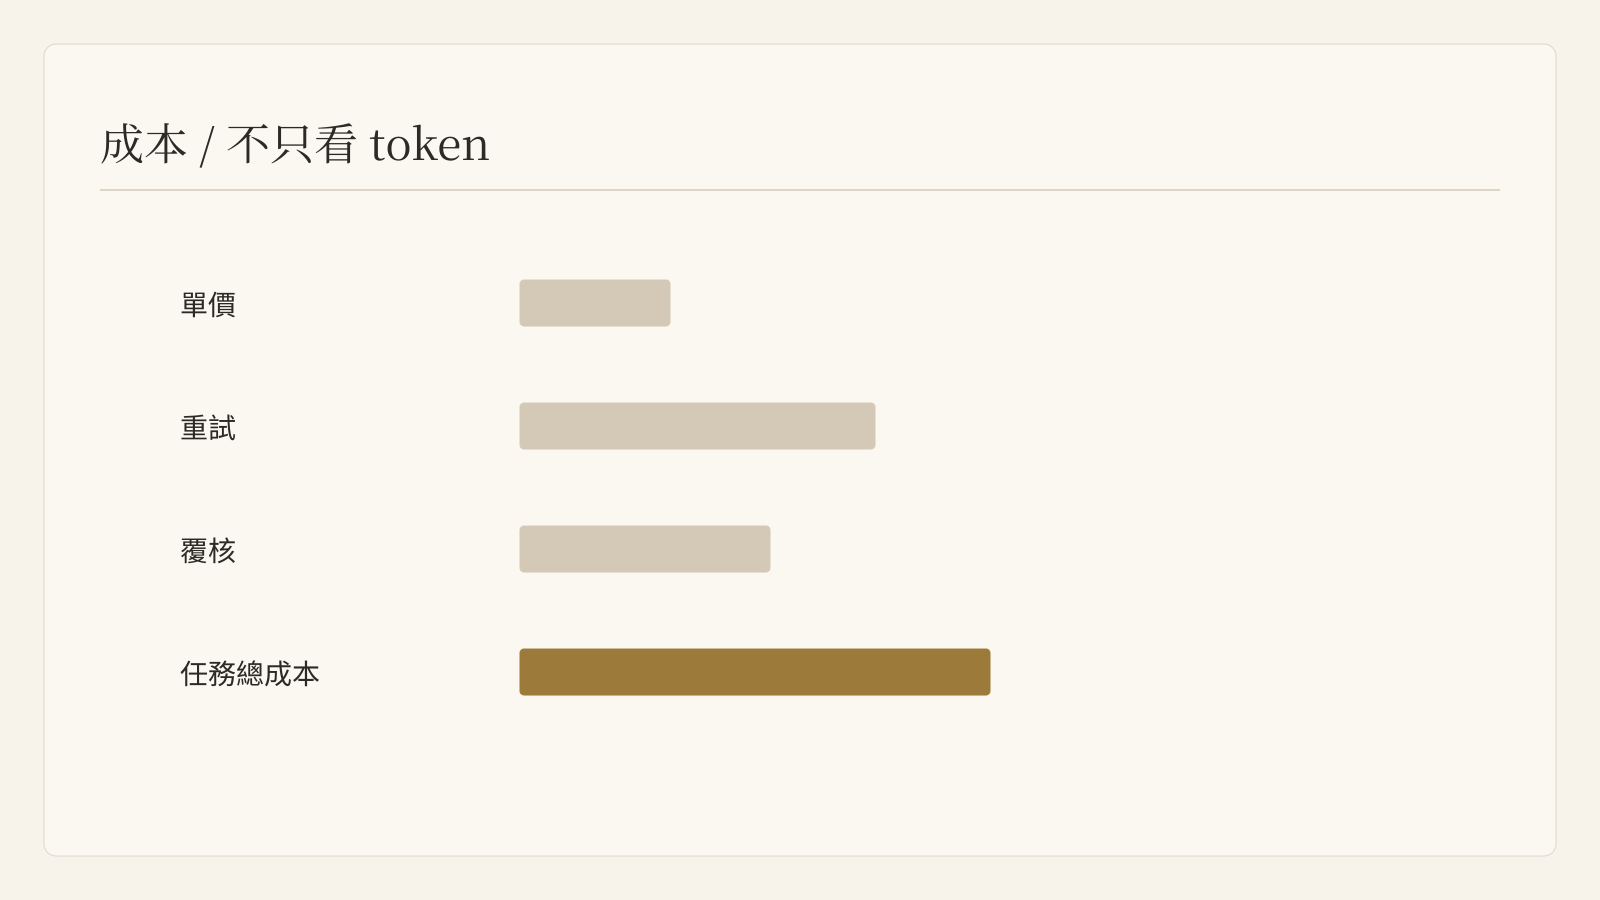
同一任務怎樣公平比較 Opus 5 與 5.5
選取已經做過、有驗收標準的任務,而不是專門為新模型寫的演示提示詞。固定材料、工具許可權、時限和測試;分別記錄兩種模型的輸入、快取讀取、輸出、工具呼叫、失敗迴圈、總耗時、稽核修改量和最終透過率。高風險任務還要記錄嚴重錯誤,不能用便宜抵消不可接受的錯誤。
可以按任務分組看:倉庫級程式碼修改看補丁、測試和迴歸;資料研究看事實和引用;跨應用流程看中途失敗能否恢復;業務材料看成稿是否滿足模板和審批。每組先在預設或相近的 effort 設定下比較,再針對明顯受益的任務提高 effort。不要用廠商各自的 benchmark 百分比替代自己工作流的驗收記錄。
什麼時候值得用 Fast mode 或快取
如果客服響應、現場協作或實時操作的延遲本身影響業務結果,才有必要比較 Fast mode 的加價與等待時間。能排隊的批次處理可以測 Batch 的費率,但要把交付時限列進驗收。重複使用的規則、工具說明和背景材料適合評估快取;經常變化的任務輸入則要按實際命中率決策。
Buda 的檔案、終端、瀏覽器和產物記錄可以把執行過程與稽核結果留在同一處。採購判斷仍應基於真實交付:任務透過率、全部呼叫成本、失敗恢復和稽核時間,而不是模型選擇器裡的一行單價。
Buda Credits 與使用權限
Claude Opus 5.5 已面向具有有效付費訂閱的 Space 開放。僅購買額外 Credits 不會替代這個訂閱模型所需的訪問許可權。
Buda 展示倍率為 1.3×,相對 Claude Sonnet 5 的 1.0× 基準。它不是每個任務的固定扣費;實際 Credits 取決於輸入、輸出、快取、工具呼叫和最低扣費規則。Anthropic API 美元價格屬於另一套計價體系。