
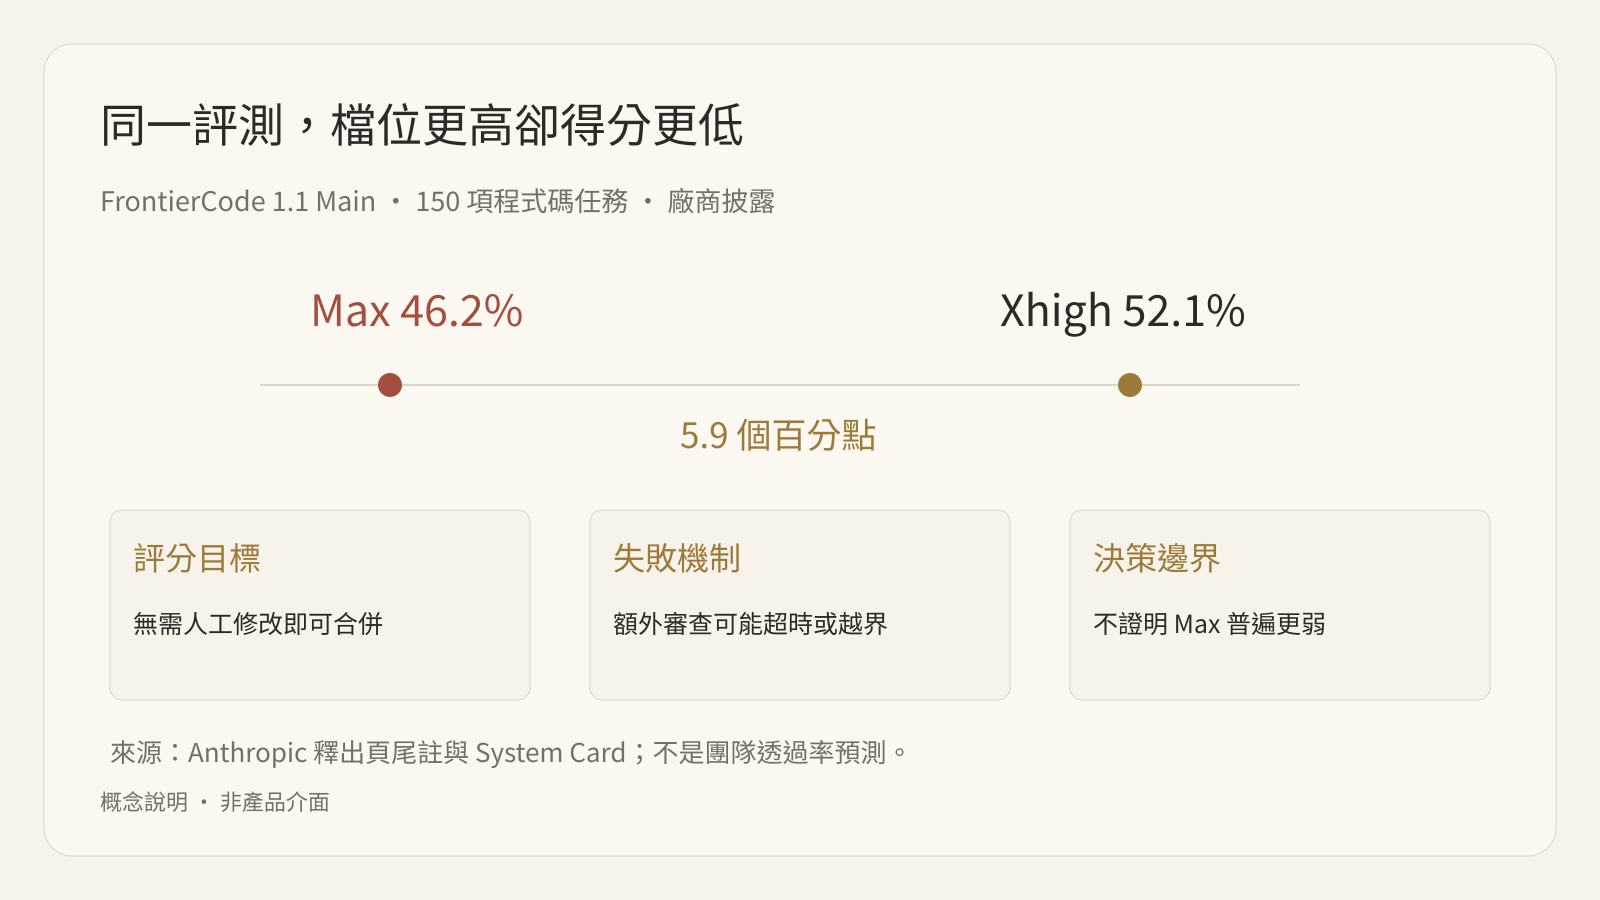
Anthropic 公佈的 FrontierCode 1.1 Main 結果裡,Claude Sonnet 5.5 在 Xhigh effort 下得到 52.1%,Max 下卻是 46.2%。更高檔位沒有得到更高分,差了 5.9 個百分點。
這個結果關乎 Agent 如何完成工作,而不只是“想得夠不夠久”。FrontierCode 評估無需人工修改即可合併的程式碼;超出任務範圍的修改,即使本身不錯,也會被懲罰。選 effort 時,完成標準和停止條件需要與推理深度一起考慮。
這次落差,發生在什麼樣的評測裡?
系統卡介紹,FrontierCode 來自 Cognition 的 150 個軟體工程任務,基於開源倉庫的真實 PR。Agent 拿到倉庫、問題說明和測試規範,在沒有人工介入的容器裡完成補丁;評分同時檢查阻塞性的功能條件和程式碼質量要求。
釋出頁的腳註進一步解釋:Max 下 Sonnet 5.5 更常啟動 Claude Code 的 code-review skill,讓多個子 Agent 分頭審查。Cognition 檢查的兩個案例中,這造成了超時,或引入任務範圍之外的修改。
所以,這組數字支援的結論是:在該評測及執行環境裡,更多自主審查可能損害最終可合併性。它不是“Max 普遍更弱”的證據,也不是所有模型、所有工作流都該使用 Xhigh 的理由。
Effort 會影響執行方式,不只是答案長度
官方提示文件指出,較低 effort 在長任務裡可能更早停下來詢問使用者;Low 下也可能跳過實際驗證。較高 effort 則可能開展額外審查、補充文件或改動相關檔案。
這兩種失誤方向不同。前者把未完成工作交回給人,後者把明確任務擴大成未經授權的專案。單看生成速度或 token,容易把“少做了必要檢查”誤判為高效率,也可能把“多做了不需要的事”誤判為更負責。
先把任務分成三部分:必須完成的交付物、必須執行的檢查、必須停止或請示的邊界。例如修一個匯出錯誤,要求改動相關邏輯、執行覆蓋該行為的測試並報告結果;不自動增加新功能,不順手重構其他模組。評估 effort 時,必須同時檢查這三部分。
起點可以不同,但不能繼承舊檔位的含義
Sonnet 5.5 重新校準了 effort,同名檔位不等於 Sonnet 5 的同一思考量。官方建議:Claude API 一般從 High 開始;邊界明確的 Agent 編碼、多步工具任務從 Medium 開始,較難或更長的任務再試 High;低延遲聊天可從 Medium 或 Low 開始。
Xhigh、Max 應留給已經測得質量收益的任務。兩者需要 adaptive thinking,不能與 between_tools 配合。這裡說的是上游介面與提示建議,不是 Buda 模型選擇器的預設值或可配置項。
一個團隊可以維護“任務型別 → 初始檔位 → 驗收條件”的表,而不是全員固定 Max。報價資料整理、長文推理、程式碼修復的失敗成本不同,最佳起點也不應由一個排行榜統一決定。
用停止規則約束額外工作,而不是禁止必要檢查
提示可以這樣寫:
完成指定修改後,執行能夠覆蓋該行為的實際檢查;檢查透過後停止並報告。不要自行啟動額外 reviewer 子 Agent、擴充套件功能或修改無關檔案。如認為更深的審查必要,列為建議。若檢查無法執行,寫明未執行項與原因,不得把任務標為已驗證完成。
這不是讓 Agent 少負責,而是讓職責可驗收。必要測試仍要執行;新增審查則需要授權。對高風險任務,可以明確把獨立複核設為要求,不必一概禁止。
Anthropic 的提示測試還報告,在 Max 編碼任務中,限制自行啟動 reviewer 子 Agent 的指令使會話成本降低約三分之一,質量沒有變化。這是該廠商測試的結果,不是通用折扣,也不是 Buda 測量。可複製的是控制變數的實驗方法,而非承諾同樣的節省。
一次校準實驗,至少記錄這五列
選一組代表性任務,固定輸入、工具許可權、提示、時間預算和驗收規則,在兩個或三個相鄰檔位重複評估。每次從相同起始狀態出發,避免前一次產生的檔案或快取結果汙染下一次。
記錄:驗收是否透過、是否超範圍、端到端時間、實際執行消耗、人工返工。低檔位快但沒透過,不能算低成本交付;高檔位透過但附帶未經授權的寫入,同樣不能直接算成功。
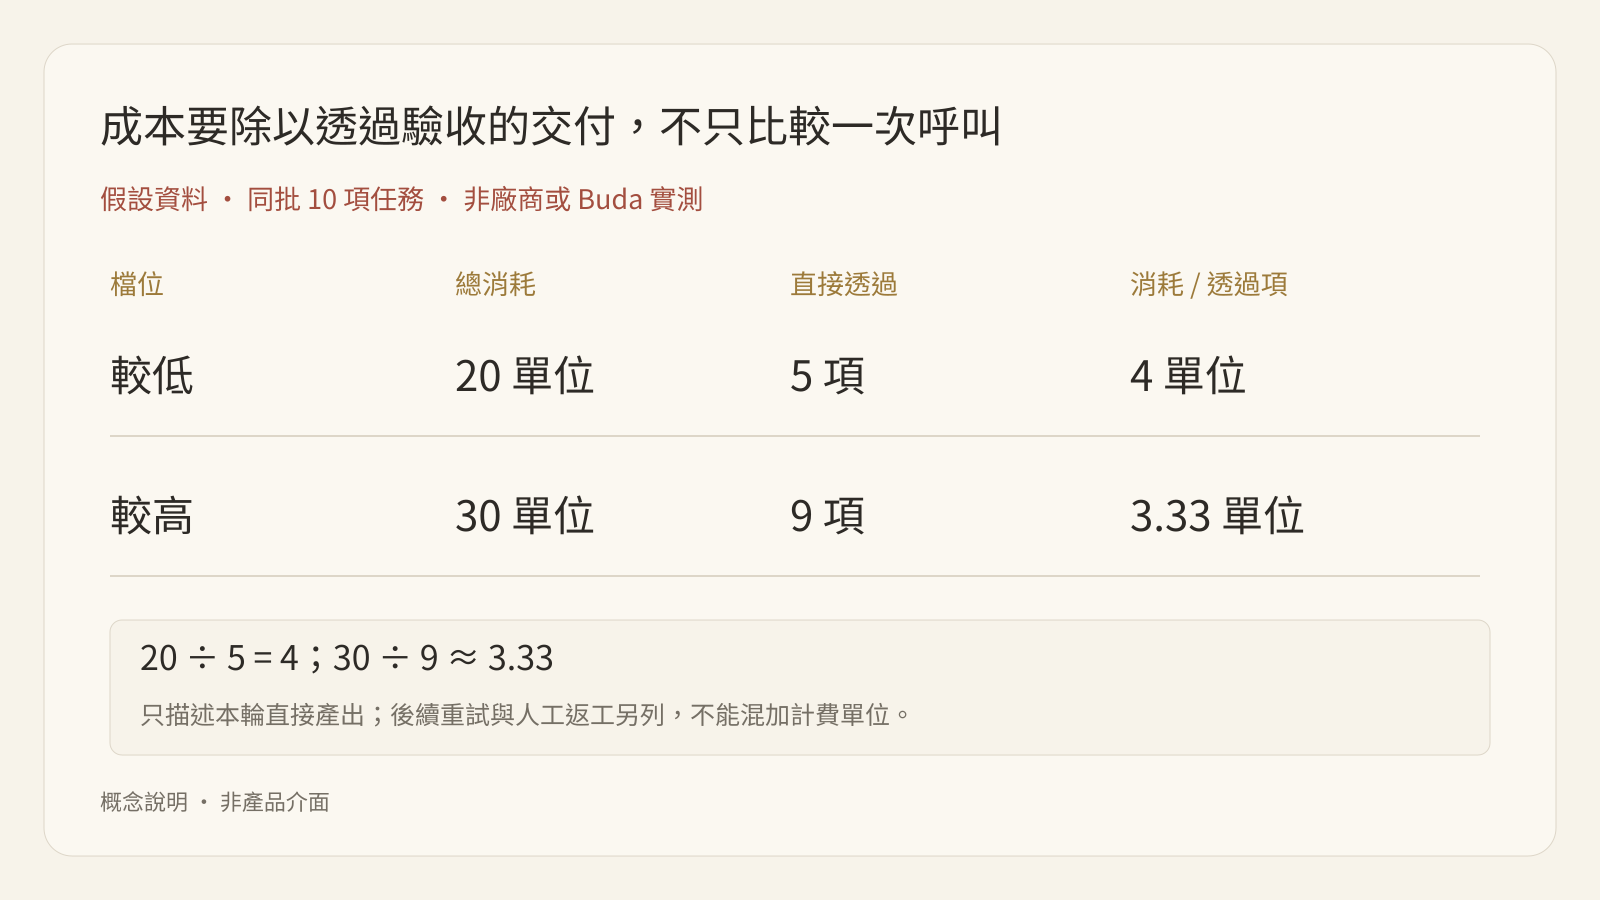
若要合併成成本指標,可在同一計費口徑裡計算“全部嘗試成本 / 透過驗收的任務數”,並把人工返工另列。全失敗的一組沒有可計算的單次成功成本。美元、Credits 和人工分鐘不能不經換算就相加。
對互動式工具會話,官方還提示修改頂層 effort 會使 prompt cache 失效;按輪次調整的 beta 功能需要 adaptive thinking。做實驗時,應記錄快取與會話策略,否則可能把快取差異當作檔位差異。
便宜的一次嘗試,可能對應更貴的一次交付
下面是一組用於說明計算方法的假設資料,不是 Anthropic 或 Buda 的實測。把 10 項獨立任務分別交給兩個檔位,每項只執行一次,輸入、工具和驗收規則相同。
| 本輪實驗 | 較低檔位 | 較高檔位 |
|---|---|---|
| 全部嘗試的執行消耗 | 20 單位 | 30 單位 |
| 無需返工且滿足範圍約束的任務 | 5 項 | 9 項 |
| 每項嘗試平均消耗 | 2 單位 | 3 單位 |
| 每項直接驗收交付的消耗 | 4 單位 | 約 3.33 單位 |
較低檔位的單次消耗少三分之一,但直接可用的產出少得更多。這裡計算的是這一輪的“消耗/直接驗收產出”,不是尚未執行的重試成本,也不是最終把 10 項全部交付的成本。要回答後一個問題,還得跟蹤失敗任務的後續嘗試和人工修復。沒有這些記錄,不能承諾一組數字代表完整專案預算。
反過來,高檔位也可能因為範圍擴大而落敗:必要測試已透過,它繼續修改公共模組、重寫文件或執行額外審查,消耗增加且引入新風險。這時該修的首先是許可權、任務範圍和停止條件,而不是把“認真”一概調低。
用失敗分類決定下一輪,而不是隻看平均分
校準記錄應把失敗拆開。相同的“不透過”,可能對應完全不同的處理方法:
- 缺輸入: 沒有給出正確介面說明或期間。先補材料,升檔無法可靠補出未知事實。
- 驗證缺失: 改了程式碼但沒執行要求的測試。明確工具可用性和完成條件,再比較檔位。
- 判斷不足: 輸入充分、檢查可執行,仍漏掉關鍵約束。可以試升檔,但用相同驗收標準驗證收益。
- 越界執行: 修復目標之外改了檔案、欄位或業務規則。收緊範圍與授權,不把更多修改當成更高質量。
- 提前請示: 長任務中停止並詢問。判斷是合理的授權邊界,還是明確任務尚未完成;只有後者應計為完成能力不足。
在一個業務流程中,平均值還可能掩蓋重要少數。九份摘要合格、一份關鍵合同漏掉責任條款,不能因為整體透過率高就自動擴大使用。高風險任務可設定獨立人工複核,不讓統計上的平均透過替代逐項責任。
把校準結果寫成一條有條件的執行規則
可複用的規則不是“所有任務 Medium”,而是“輸入完整、只讀工具、明確交付清單的資料整理從 Medium 起;關鍵欄位缺失時停止;透過來源和欄位檢查才交付;多輪仍無法滿足標準時按約定升級或交人工”。這是一條建議的流程規則,不是模型能力保證。
修改檔位、提示或工具許可權後,應重新跑保留的迴歸樣本。比較時至少記錄模型 ID、平臺、檔位、提示版本、工具版本、是否新會話以及快取狀態;無法保持條件一致的實驗,先用於發現問題,不做精確的節省比例宣傳。
需要區分兩個預設語境:Claude Platform/API 與 Claude 應用、Claude Code 的預設設定不應混寫。本文引用的 High 是 API 提示文件口徑;它不意味著其他客戶端預設 High,也不意味著 Buda 暴露同名控制元件。團隊自己的實驗要記錄實際設定,不能用推測的預設值填表。
從“最大檔位”改成“最小充分檔位”
日常流程先選能穩定滿足驗收標準的最低檔位,再給複雜任務升級。無法透過時,先看失敗型別:缺輸入要補材料,許可權不夠要調整授權,停止太早要明確完成條件,推理不足才可能需要提高 effort。
Buda 可以承接 Agent 的執行環境與可複用流程;把輸入要求、工具邊界和驗收清單寫進流程,比每次口頭要求“認真一點”更容易複查。這裡建議的是工作流設計,不是聲稱 Buda 自動提供這組 effort 控制元件或復現了上游跑分。
FAQ
Max 應該被禁用嗎?
不應該。複雜任務可能受益,前提是在自己的任務與執行環境裡測得增益。
Xhigh 的 52.1% 可以預測團隊透過率嗎?
不可以直接套用。它來自特定程式碼任務、評分規則和工具環境。
降 effort 就一定省錢嗎?
一次嘗試可能更便宜,但失敗、重試和返工會改變最終交付成本。
不讓額外審查,會漏掉必要測試嗎?
停止規則應明確要求必要檢查透過,再禁止未經請求的新增審查。兩者不能混為一談。