GPT-6 Astra 對比 Claude Fable 5.1:長任務 Agent 該選誰?
Fable 領先獨立綜合指數,Astra 在多項工具任務占優;真正要比較的是工作負載、執行環境與驗收成本。

GPT-6 Astra 對比 Claude Fable 5.1:長任務 Agent 該選誰?
GPT-6 Astra 和 Claude Fable 5.1 的紙面規格非常接近:約 100 萬 token 上下文、12.8 萬 token 最大輸出,Standard 上游 API 價格都是每百萬 token 輸入 10 美元、輸出 50 美元。
但兩者並不能直接互換。
先說結論:高難度推理、多步研究,或反覆讀取大型快取前綴的任務,可以先測 Fable 5.1;需要操作真實軟體、跨工具持續執行、從失敗恢復並交付成品的任務,可以先測 Astra。 最終路由應由自己的驗收任務決定,而不是由一張總榜決定。
獨立綜合測試目前偏向 Fable 5.1
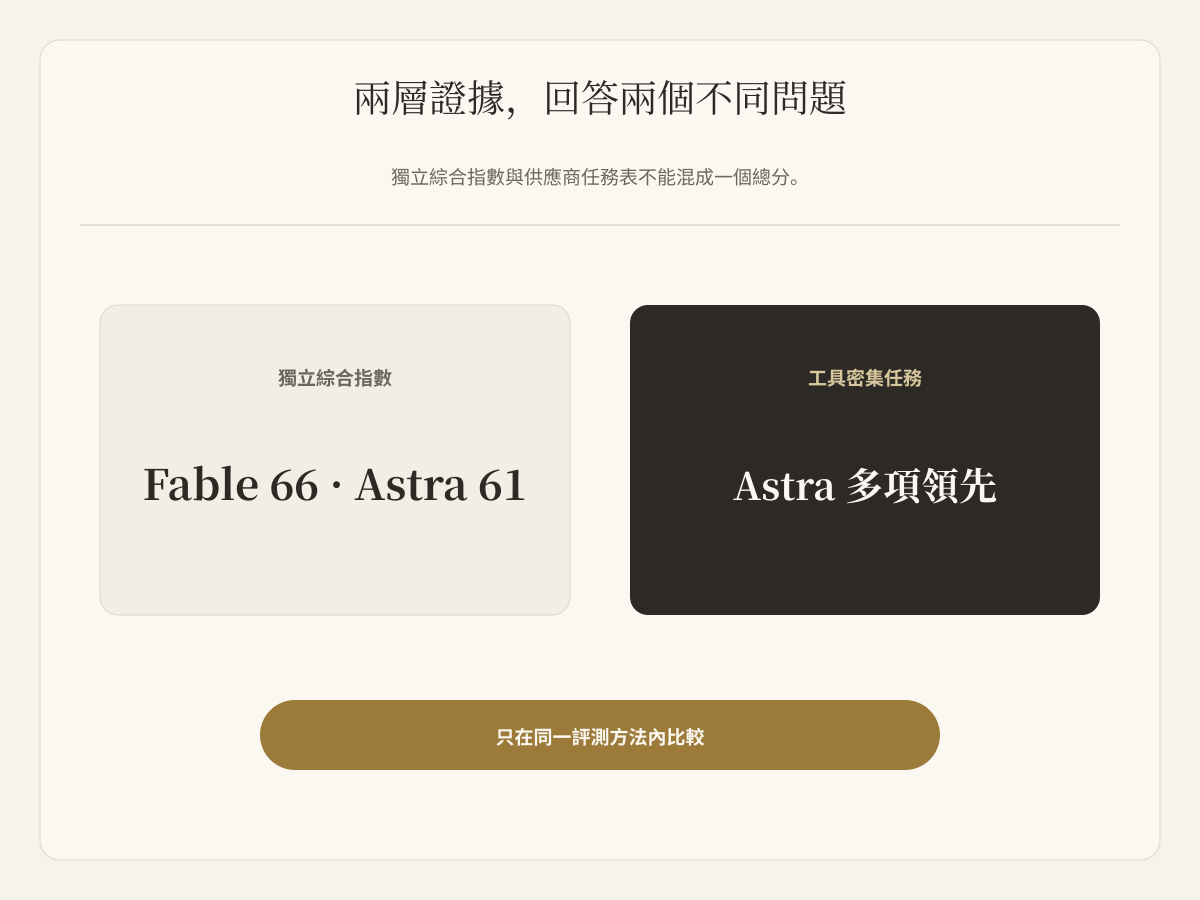
Artificial Analysis 的 Intelligence Index 中,Claude Fable 5.1 在最高 effort 下得到 66 分,GPT-6 Astra 為 61 分。Coding Agent Index 則是 Fable 5.1 得 70 分,Astra 得 67 分。
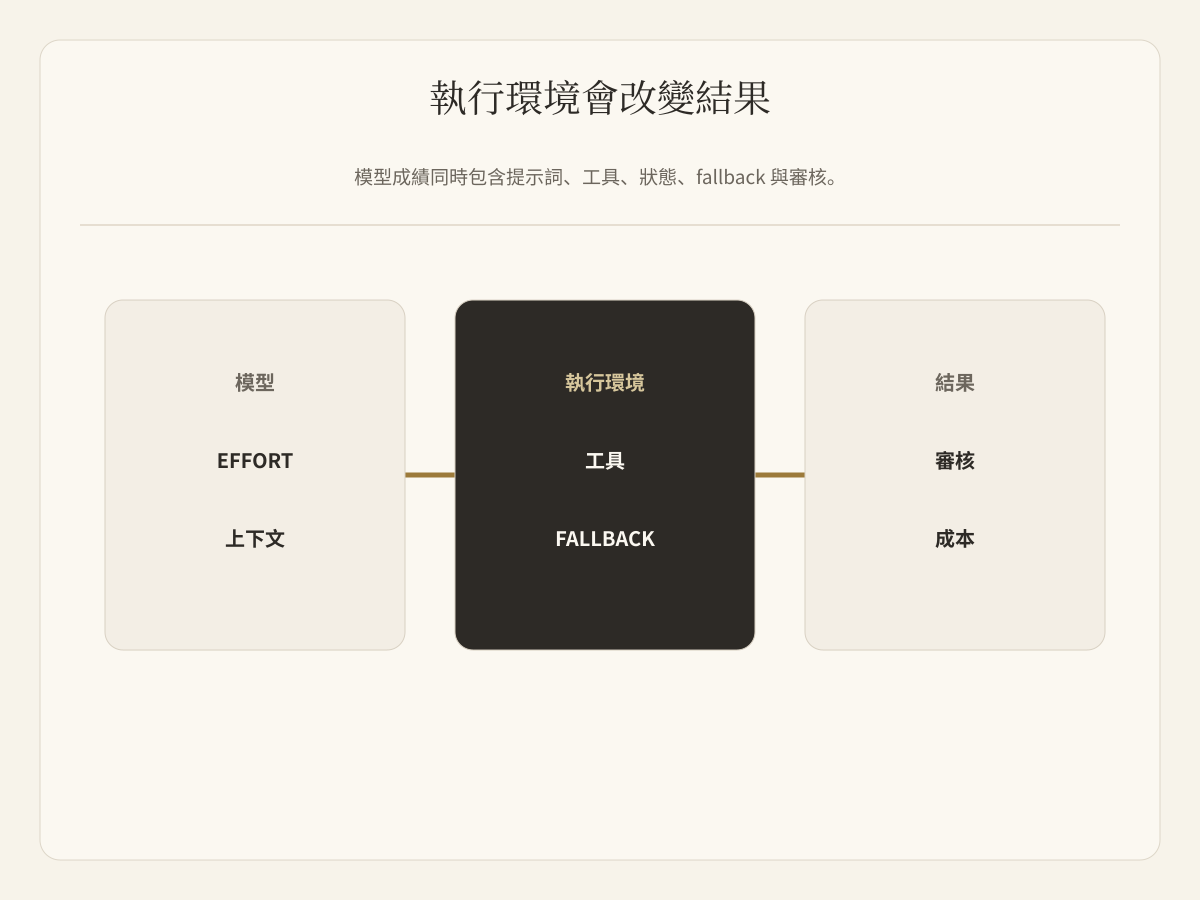
這組獨立結果有價值,因為兩款模型經過同一評測方法。但它不代表 Fable 在每項工作上都更強。Fable 的設定包含最高 effort 和預設 fallback;Coding Agent Index 的執行環境分別是 Claude Code 與 Codex。它衡量的是「模型 + Agent 執行環境」,不是脫離工具的模型權重。
Artificial Analysis 對 Astra 的結論也是混合的:相較 GPT-5.6 Sol,token 效率明顯提高,Coding Agent 成本很有競爭力;但在通用 Intelligence Index 中,漲價超過效率改善,每項任務成本反而較高。
OpenAI 的任務表中,Astra 在多項工具工作領先
| 評測 | GPT-6 Astra | Claude Fable 5.1 | 邊界 |
|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 55.8% | OpenAI 表格;終端 Agent 設定會影響結果 |
| AutomationBench | 41.4% | 31.4% | SaaS 工作流程執行 |
| BenchCAD | 95.9% | 84.3% | Claude 分數使用文件註明的評測修改 |
| Terminal-Bench Science | 64.6% | 52.6% | 依賴工具的科學工作流程 |
| Artificial Analysis Intelligence Index | 61.2 | 65.7 | OpenAI 表中引用的獨立指數 |
| Artificial Analysis Coding Agent Index | 67.0 | 67.2 | 在該快照中接近持平 |
兩組證據並不衝突:Astra 可以在電腦操作、終端與部分專業工作領先,同時 Fable 在更廣泛的獨立綜合指數領先。
規格相似,執行成本並不相同
- Astra 快取輸入每百萬 token 1 美元;Fable 5.1 cache read 是 0.25 美元。
- Astra 輸入超過 27.2 萬 token 後,整次請求輸入與快取為 2 倍價格,輸出為 1.5 倍。
- 兩者都有 50% Batch 折扣;Astra 另有 50% Flex,以及按適用價格 2 倍計費的 Fast。
- Fable 5.1 始終使用 adaptive thinking,並可在對話中途調整 effort。
- Fable 5.1 的預設 fallback 會改變實際被測系統。
- 工具、重試、拒絕、審核與返工可能比 token 單價更影響總成本。
100 萬上下文不代表每輪都該塞滿。檢索與穩定快取前綴仍然重要。
按想減少的失敗來選
**先測 Astra:**需要操作 Browser 或桌面軟體;同時經過 Terminal、檔案、網站與驗證;長任務常在轉向或恢復時失去目標;交付物是文件、試算表、簡報或可執行網站。
**先測 Fable 5.1:**工作以困難推理或多步研究為主;長對話反覆讀取可快取前綴;現有 Claude 整合已正確處理 thinking blocks;Claude Code 已是主要工作面。
**繼續用便宜模型:**擷取、分類、格式轉換等容易驗證的步驟;小模型已穩定通過驗收;升級不會減少失敗或審核。
執行環境可能反轉結果
Codex 與 Claude Code 的提示詞、工具、權限、壓縮、fallback、確認與狀態保存方式都不同。Astra 的部分提升來自 Codex,包括可搜尋更早的上下文視窗。Fable 5.1 也有自己的限制:不支援強制 tool choice;舊模型無法讀取它的 thinking blocks;修改更早訊息可能讓後續 thinking blocks 失效。
切換生產路由前,使用同一組驗收任務記錄首次通過率、工具恢復、完成時間、token 與快取消耗、人工修改、模型或 harness 的失敗來源,以及每個驗收通過任務的總成本。
不要拿裸 API 與成熟的第一方 Agent 產品比較,再把結果稱為模型排名。
對 Buda 使用者意味著什麼
前沿模型只是 Agent Workspace 的一部分。團隊仍需要持久檔案、真實工具、權限邊界、可見執行和人工審核。
GPT-6 Astra 和 Claude Fable 5.1 暫未在 Buda 上線。後續上線後,可用範圍與 Credits 會在 Buda 模型列表和公開價格頁顯示。
延伸閱讀:GPT-6 Astra 發布指南、如何為 AI Agent 選擇合適的模型、Claude Fable 5.1 更新了什麼。
常見問題
GPT-6 Astra 比 Claude Fable 5.1 更好嗎?
不是所有工作都更好。Fable 5.1 領先目前的 Artificial Analysis 綜合指數;Astra 在多項供應商報告的電腦操作、終端、自動化與科學任務領先。
哪一個更便宜?
Standard 輸入、輸出目錄價相同。Fable 5.1 的快取讀取更便宜;Astra 對超過 27.2 萬輸入 token 的請求加價。應比較完整任務成本。
誰的上下文較大?
Astra 為 105 萬 token,Fable 5.1 為 100 萬。實務上,檢索品質、快取設計和執行環境如何保存決策通常更重要。
一張榜單能決定預設模型嗎?
不能。公開評測用於篩選候選,穩定的內部驗收集才用於決定路由。